如何构建没有重复群众演员的 AI 短剧群像场景
当生成器必须同时创造过多完整人物和动作时,群像场景往往容易失败。本教程将展示如何通过受控分层构建 AI 短剧群像,保留主角,避免群众演员重复,并针对竖屏视频完成构图。
文章目录
群像场景与双人场景的失败方式不同
可靠的群像场景不是一次生成一场庞大的群体表演,而是由稳定的地点、视觉特征锁定的主角、受控的人群区域,以及少量易于识别的动作事件组合而成。
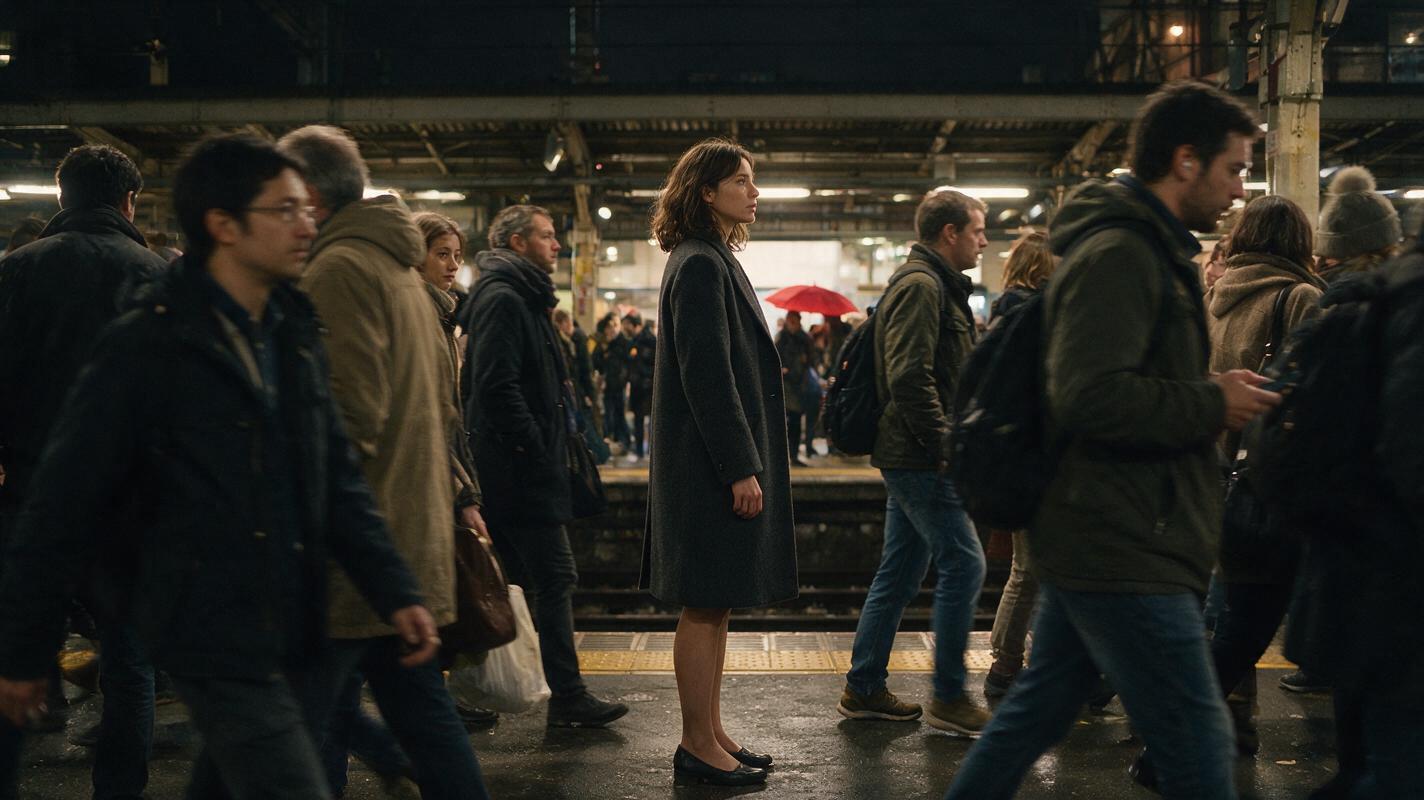
当ai short drama提示词只是要求“一个挤满人群的繁忙车站”时,模型必须同时决定每张脸、每个身体、每条路径、每个手势以及彼此的遮挡关系。这可能导致群众演员像克隆人一样重复、肢体融合、人群密度不断变化,或者主角消失在背景之中。
更安全的方法是把人群视为制作设计的一部分。确定群体为故事贡献什么,按景别深度安排人物,限制可见身份的数量,并且只为观众需要理解的动作添加动画。
第 1 步——为人群设定一个戏剧任务
先从故事功能入手,而不是先确定人数。人群可以阻挡逃跑路线、隐藏目击者、孤立主角、庆祝某个事件,或制造社会压力。为镜头选择一个主要功能。
将这一功能转化为一份简明的人群简报:
场景:夜晚的末班车站台
主角动作:Mara 寻找信使
人群功能:不断挡住她的视线
可识别事件:一把红伞出现在铁轨对面
近景区域:两个不完整的前景通勤者
中景区域:Mara 加上三个横向穿行的人物
远景区域:在列车附近等候的柔和人群簇
动作类型:仅缓慢横向行走
禁止事项:相同的脸、同步手势、人物穿过 Mara
这份简报为场景建立了层级。观众应该先注意到 Mara,其次是遮挡,第三才是红伞。背景人物的单张脸并不是故事信息,因此不需要拥有同等程度的视觉细节。
制作规则:如果一个群众演员没有执行具体的故事动作,就把这个人视为形状、节奏或氛围,而不是配角。
第 2 步——在构建人群前锁定主角
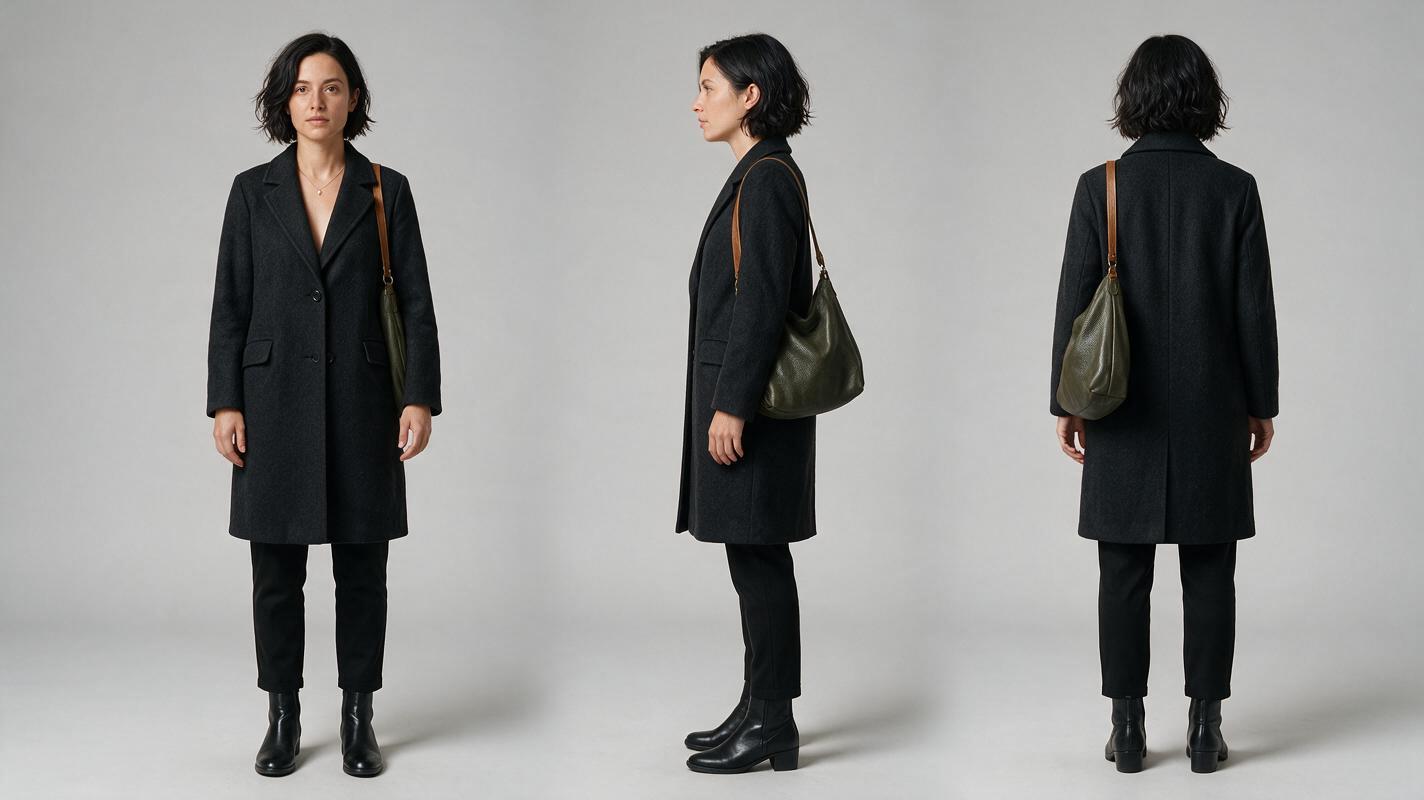
将主角独立于群像场景单独创建。记录脸型、发型、外套、鞋子、年龄范围以及一个醒目的轮廓特征等稳定特征。生成正面、侧面和背面的参考表,确保角色即使被部分遮挡也能保持可识别性。
群像镜头需要比特写镜头更鲜明的轮廓。独特的外套长度、肩部形状、包,或一块醒目的色彩区域,即使脸部在画面中占比很小,也能帮助观众识别角色。不要依赖细小的首饰或微妙的妆容。
视觉重现提示词:
同一位虚构女性 Mara 的写实照片风格三格角色参考表,31 岁,黑色短卷发,椭圆脸,炭灰色及膝大衣,低饱和绿色单肩包,黑色短靴;左侧面板为正面视图,中间面板为完全侧面视图,右侧面板为背面视图;每个面板中的服装、比例、发型和光线完全一致;全身可见,双手放松并与躯干分开;中性浅灰色无缝摄影棚背景;横向 16:9 构图;必须使用的摄影机:视线高度、正交风格的全身取景,呈现 85mm 镜头效果;均匀柔和的摄影棚照明;无文字、无标签、无标志、无界面元素。在生成地点或群众演员前先确认这张参考表。如果主角单独生成时就不稳定,加入更多人物只会让问题更难诊断。
第 3 步——设计人群几何关系,而不是额外身份
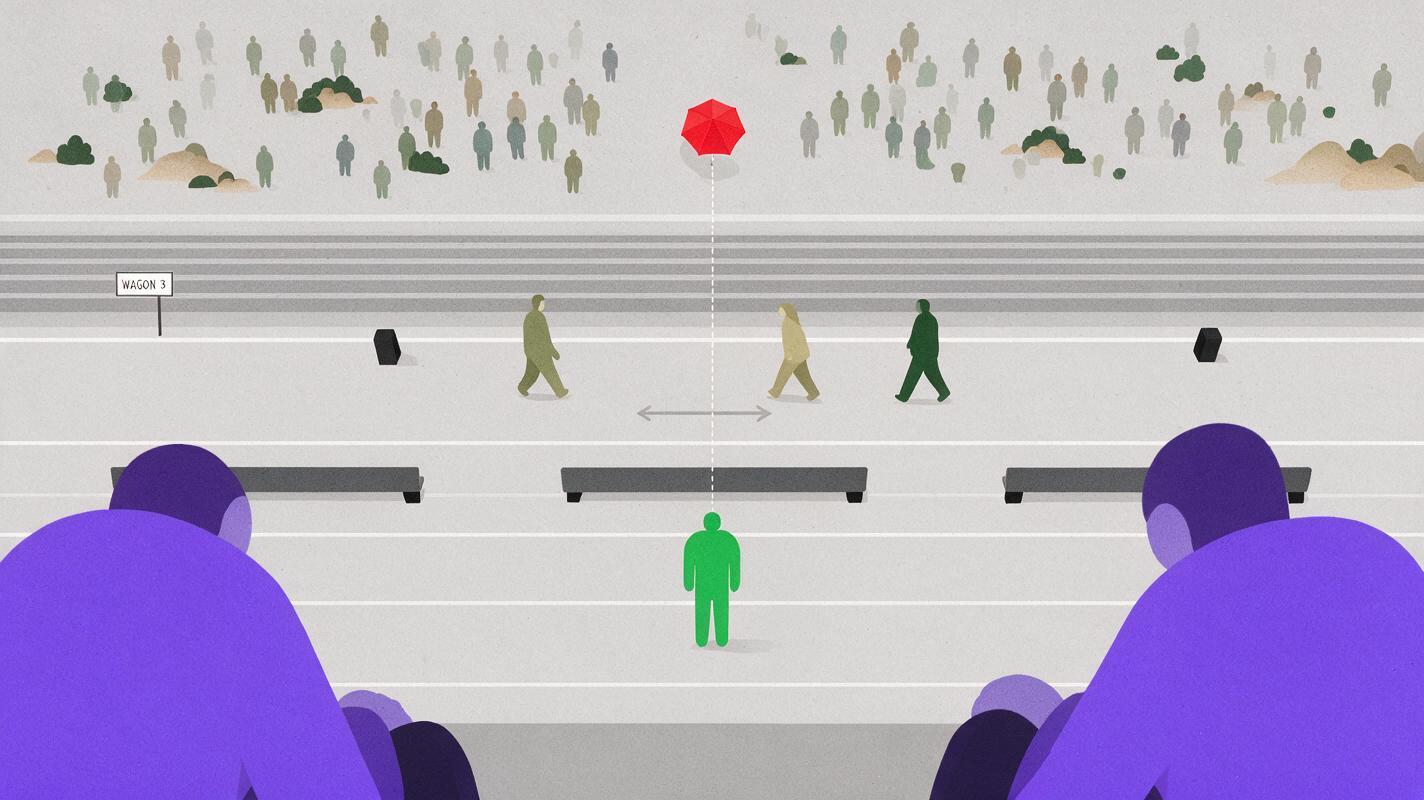
将画面划分为近景、中景和远景人群区域。每个区域都应承担不同的视觉职责:
- 近景区域:被裁切的肩膀、外套或包,用于制造前景运动和短暂遮挡。
- 中景区域:主角、故事线索,以及仅执行可识别动作的群众演员。
- 远景区域:用于建立规模感的小型人群簇,但不应要求面部准确。
不要平均分布人物。人工规则的间距会让重复人物更容易被注意到,也会削弱镜头的视觉焦点路径。应使用不对称的人群簇、空旷通道、相互重叠的轮廓以及建筑分隔物。
视觉重现提示词:
铁路站台的中性俯视调度图,以写实微缩场景的形式呈现;中间通道中有一个身穿绿色外套的主角人物,画面下缘附近有两个被大幅裁切的前景人物,三个彼此分开的中景行人横向穿过画面,远景区域有几组不规则的小型人群,并且铁轨对面朝向一把红伞的方向有一条清晰的空旷视线;横向 16:9;必须使用的摄影机:精确九十度垂直俯视,无透视倾斜;柔和中性光线;简单的无脸彩色人物形体;无文字、箭头、标签、标志、屏幕或软件界面。空旷的视线与人群同样重要。它能为剪辑师提供一个干净的瞬间,让线索得以显现。
第 4 步——先生成干净的地点,再加入人物
先将车站、市场、大厅或街道作为空场景底片构建。锁定建筑、实景灯光、天气、镜头高度以及主角预定的位置。干净底片可以成为所有人群变体的连续性参考,也能在生成的人物破坏背景时作为修复素材。
保持入口、柱子、长椅、门和标识区域的空间一致。这些地标即使被群众演员打断,也能帮助观众理解运动关系。
夜晚富有电影感的空旷通勤铁路站台,潮湿的混凝土地面,温暖的顶部实景灯光,漆黑的铁轨,风化的柱子,画面右侧有长椅,中间有一条开放的步行通道,远处可以看到对面的站台,真实可信且具有生活感的公共空间,克制的编辑风格写实感,横向 16:9,必须使用的摄影机:从站台入口拍摄的视线高度真实四分之三视角,呈现 35mm 镜头效果,固定摄影机,无人物,无可读文字,无标志。对于竖屏短剧视频,现在也要测试 9:16 裁切。确认主角通道、线索通道以及至少一个环境地标能够放入狭窄画面。
第 5 步——从后向前构建人群
先加入最不重要的人群层。远景人群应保持较小的尺寸、部分重叠,并在视觉上处于从属地位。接着加入中景表演者,最后将前景身体作为独立的遮挡元素使用。
这种顺序可以避免前景失败导致整个环境都必须重新生成。同时,它也让人群密度能够在剪辑时调整:移除一层前景以获得更清晰的视线,或添加一层来增强压迫感。
| 层级 | 细节程度 | 允许的动作 | 主要风险 |
|---|---|---|---|
| 远景人群 | 低 | 等候、缓慢游移 | 重复的轮廓 |
| 中景群众演员 | 中 | 单一方向穿行 | 与主角碰撞 |
| 主角 | 高 | 寻找、停下、反应 | 身份或服装漂移 |
| 前景层 | 仅保留部分身体 | 短暂横向遮挡 | 出现不需要的脸或融合边缘 |
只要工作流程允许,就将每一层保留为独立镜头或可复用底片。模块化人群比所有动作都包含在同一个片段中的人群更容易修复。
第 6 步——一次只制作一种动作类型
先从稳定的人群画面开始,然后使用image to video添加受限运动。每次生成只要求一种动作类型:横向行走、缓慢的等待手势,或前景穿过。不要在同一条提示词中同时组合奔跑、挥手、转身、交谈和摄影机运动。
固定的电影感摄影机。Mara 保持在中间区域中央不动,横跨铁轨观察,并进行一次受控的转头。三个中景通勤者从左向右缓慢行走,不要触碰 Mara,也不要穿过她的身体。远景人群仅进行最低限度的自然重心转移。一件深色前景外套短暂地从左下边缘进入并离开。保留所有面部、人数、服装颜色、站台地标和光线条件。不要新增人物,不要重复角色,不要同步运动,不要摄影机运动,不要变形。如果主角必须移动,就固定人群的功能。例如,让 Mara 穿过一群基本静止的等候者。相互竞争的运动系统会增加路径碰撞和身体重复的可能性。
第 7 步——针对竖屏画面构图人群
9:16 构图无法像宽幅建立镜头那样展示人群规模。与其用人物填满整个画面宽度,不如通过景深和遮挡来表现压力感。
- 将主角放在中央附近的垂直故事轴线上。
- 使用被裁切的前景人物,暗示画面之外还有更多人群。
- 让远景头部处于不同高度,而不是排成一条直线。
- 在揭示线索的时刻,为线索周围预留干净空间。
- 让重要的手和脸远离画面最边缘。
只有在地理关系重要时才使用广角镜头。为了表现情绪压力,一个有肩膀经过的竖屏中景,可能比完整的站台全景更有效地传达庞大人群。
第 8 步——在剪辑中诊断重复问题
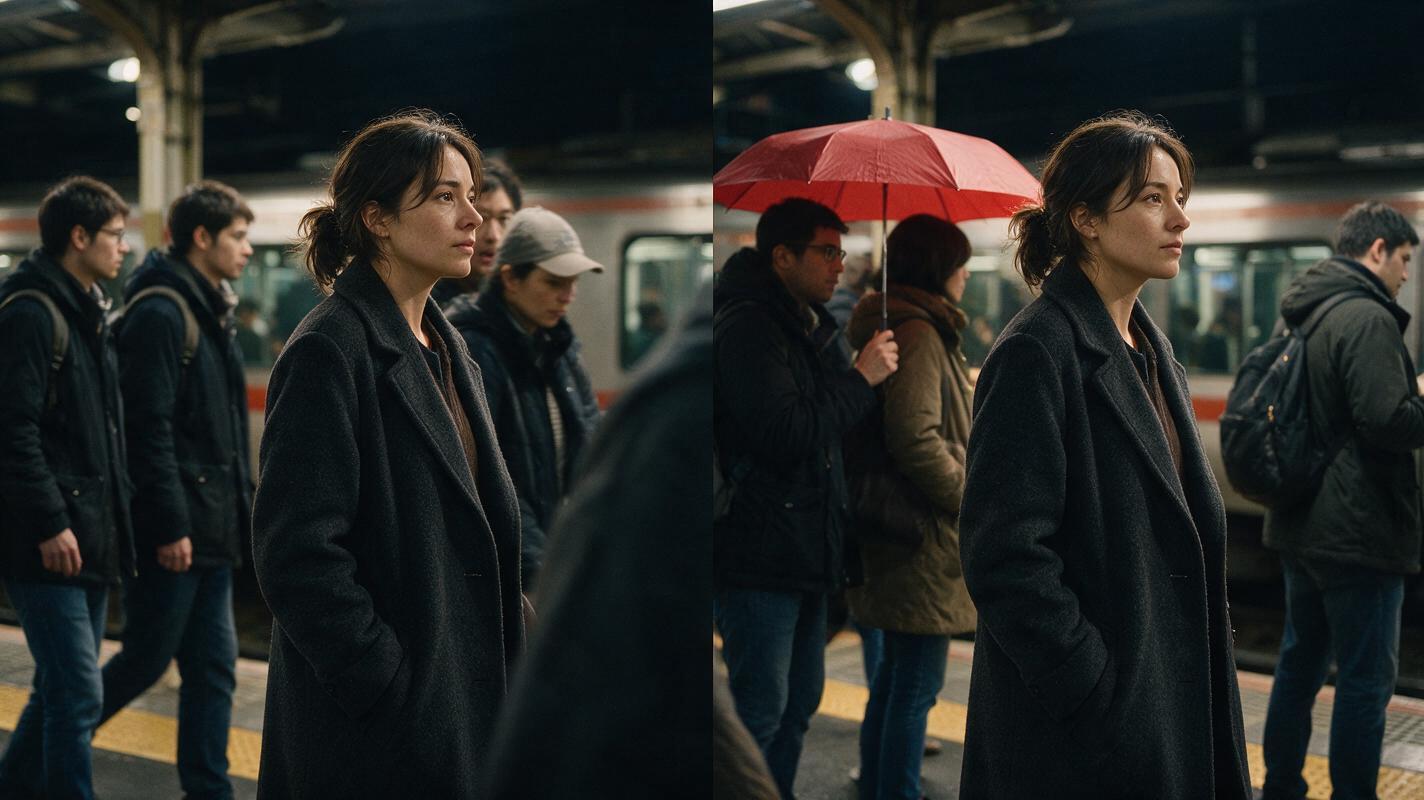
在发生重叠的时刻逐帧检查片段。重复通常会出现在背景人物从主角身后出现、两个行人交叉,或摄影机揭示之前隐藏区域的时候。
视觉重现提示词:
一幅横向 16:9 画面中的写实照片风格电影感并排对比图,两侧都展示同一个夜晚的铁路站台和同一位身穿炭灰色大衣的女性;左半部分有意展示失败的人群生成结果,其中有两个相同的背景通勤者、一处融合的肩膀,以及一个出现在主角身后的多余人物;右半部分展示修正后的场景,间距不规则,轮廓彼此不同,身体分离清晰,并且有一条不受遮挡的视线通向一把红伞;必须使用的摄影机:两侧均为完全相同的固定视线高度四分之三视角,呈现 35mm 镜头效果;真实的编辑风格灯光;无文字、分隔标签、标志或界面元素。在修复前先对失败进行分类:
- 身份重复:只替换或遮挡重复的群众演员。
- 身体融合:缩短重叠时间,或重新生成该动作层。
- 人数突然出现:在人物出现前剪切,或用前景层遮盖。
- 主角漂移:恢复已确认的主角画面,只重新生成表演部分。
- 密度不一致:更换人群底片时,使用中性过渡镜头。
反应特写、鞋子高度的穿行镜头、车门插入镜头或线索细节镜头,都可以连接两个不同的人群状态,而不需要一条完美连续的主镜头。目标是叙事连续性,而不是不间断的模拟。
第 9 步——进行简短的人群压力测试
在制作完整的 AI 微短剧之前,先测试一个包含主角、一次中景穿行、一次前景遮挡以及关键线索的困难镜头。不要生成一段很长的表演,而应渲染多个简短的动作单元。
比较各个结果的身份稳定性、身体分离度、背景连续性和可编辑性。单站式多模型工作流在这里很有用,因为同一套已确认的参考素材可以在图像和视频选项之间进行测试,而无需重新设计场景简报。准备好简报后,免费试用这些模型,并保留能够维持故事层级的版本,而不只是动作最多的版本。
最终检查清单
- 人群具有一个明确的戏剧功能。
- 主角拥有一份已确认的三视图角色表。
- 近景、中景和远景人群区域承担不同任务。
- 存在一张用于连续性和修复的空地点底片。
- 只有与故事相关的群众演员才拥有可识别的身份。
- 每条生成片段都使用一种主要动作类型。
- 9:16 裁切保留了主角、线索和视线通道。
- 逐帧检查重复身体和人数变化。
- 准备好过渡镜头,以连接不兼容的人群状态。
常见问题
AI 短剧群像场景中应该出现多少群众演员?
只使用足以传达地点和戏剧压力的可见人物数量。部分前景身体、相互重叠的轮廓以及远处的人群簇,都可以在不要求每个人都生成完整细节的情况下,暗示更大规模的人群。
为什么 AI 剧情生成器会重复背景人物?
当提示词要求大量完整身份、相互重叠的路径以及同步手势时,重复的可能性会增加。通过分离景深层级、限制动作,并遮挡非必要的面部,可以降低生成负担。
主角和人群应该一起生成吗?
先单独锁定主角。最终镜头可以分层生成或合成,但在整个流程中,主角已确认的外观都应保持最高优先级的参考地位。
如何让竖屏短剧视频中的人群显得庞大?
使用景深、被裁切的前景人流、画外声音、错落的头部高度以及短暂遮挡。这些线索能够在保留中央表演可读性的同时,暗示狭窄画面之外的活动。
修复一个重复群众演员最快的方法是什么?
如果重复人物没有与主角互动,可以用前景层遮盖、替换受影响区域、缩短镜头,或剪切到与故事相关的插入镜头。重新生成完整场景应当是最后的选择。
关键词
ai short drama, ai microdrama, ai short film generator, ai drama generator, ai series video, batch short drama production, vertical drama video