为什么 AI 漫画人群看起来像克隆人——以及有效的提示词修复方法
AI 生成的漫画人群经常重复面孔、姿势、服装和间距,导致繁忙场景看起来像复制品,十分不自然。本指南将使用 Flux 提示词、人群层级和针对性的修复流程,在不牺牲分镜可读性的前提下,创建多样化的背景角色。
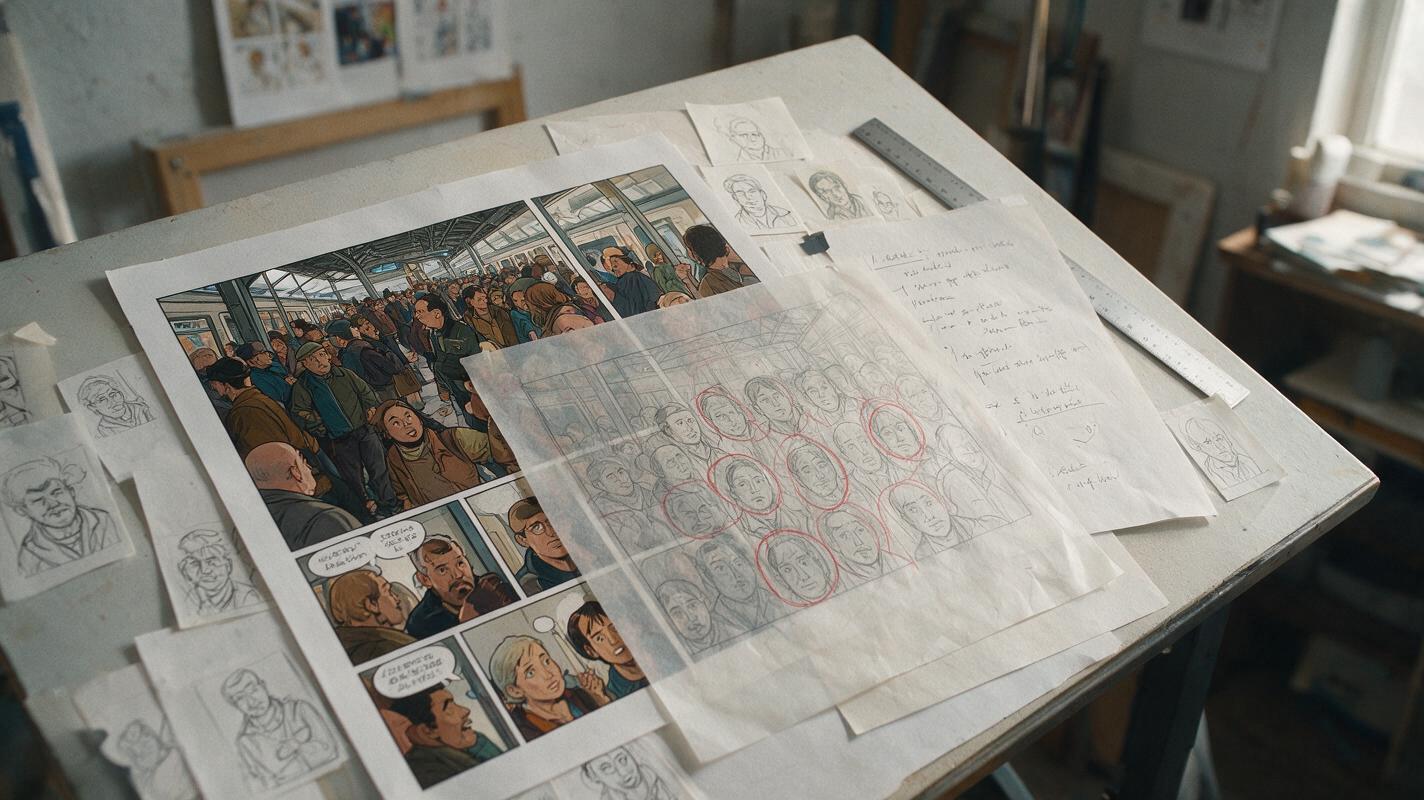
文章目录
构建一个支持分镜的群像,而不是用克隆人填满画面
令人信服的漫画人群并不需要二十个经过单独设计的角色,而是需要受控的变化、清晰的景深分组,以及将注意力集中在故事上的视觉层级。当每个背景人物都获得相同的提示词权重时,AI 往往会重复面孔、姿势、服装和间距。解决方法是将人群描述为一个有组织的构图,而不是一份随机人物清单。
这套工作流程使用 Flux 创建初始场景,然后针对仍然明显的重复部分进行选择性再生成。实用的 ai image generator 工作流程可以处理大量视觉内容,但艺术家仍然需要决定哪些人物重要、哪些人物应成为剪影,以及细节应当在哪些地方消失。
核心规则:不均等地引导模型的注意力。精确描述焦点角色,概括描述辅助群体,并将远处人物简化为易于识别的形状。
为什么生成的人群会重复同一个人
像挤满形形色色人群的繁忙车站这样的提示词听起来很合理,但它没有提供多少关于空间组织的信息。模型必须自行决定人物数量、人物比例、人物与镜头的关系,以及分配给每个人的细节量。重复就成了满足请求的一种高效方式。
漫画和网络漫画分镜中通常会出现以下四个问题:
- 身份克隆:多个角色拥有相同的脸、发型或服装。
- 姿势克隆:所有人都以相同角度站立,手臂姿势也很相似。
- 间距模式:头部形成均匀分布的网格,而不是自然的群组。
- 注意力竞争:背景路人和主角一样清晰、色彩鲜艳。
添加更多形容词很少能解决这些问题。多样、独特和形形色色等词表达了意图,却没有告诉模型每种变化应当出现在哪里。
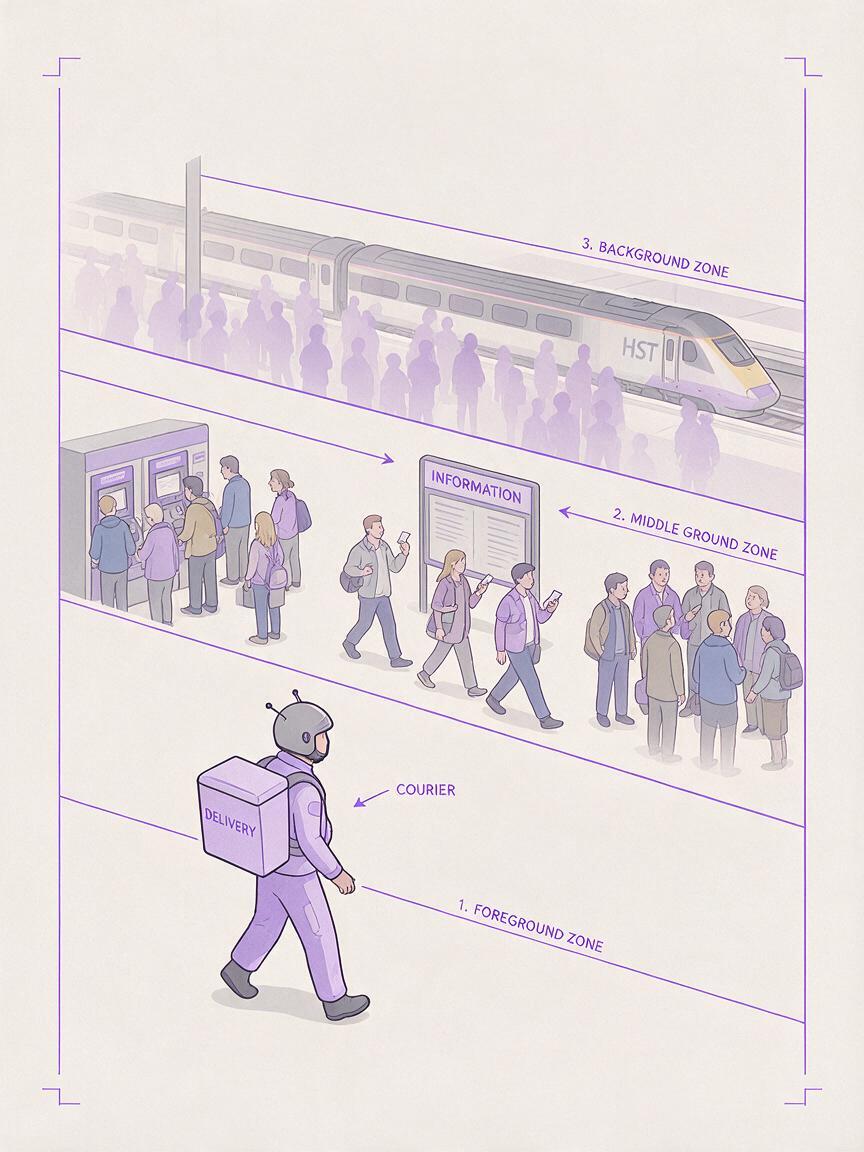
将分镜划分为不同的人群角色
在编写提示词之前,先将场景分为三种视觉角色。这可以避免让每个路人都获得同等程度的细节。
| 角色 | 作用 | 有用的描述 |
|---|---|---|
| 焦点群组 | 传达故事重点 | 明确的姿势、表情、服装和位置 |
| 辅助群组 | 展示活动和社交背景 | 由不同动作和朝向组成的小型群组 |
| 氛围层 | 营造规模感和景深 | 局部身体、剪影、柔化的面孔和相互遮挡 |
例如,一格抗议场景可以在焦点群组中安排一名演讲者和两名听众。辅助群组可以包括记者、举牌者,以及在路障附近争论的人。氛围层则可以是一条由远处头部和标语组成的压缩带状区域。
这种层级也能保护画面的可读性。如果主角位于右下方前景,就应当在那里保留最强的对比度和最清晰的面部细节。人群角色可以彼此遮挡,但不应在主角的眼睛、嘴巴或手部形成切线。
提示空间群组,而不是笼统地要求多样性
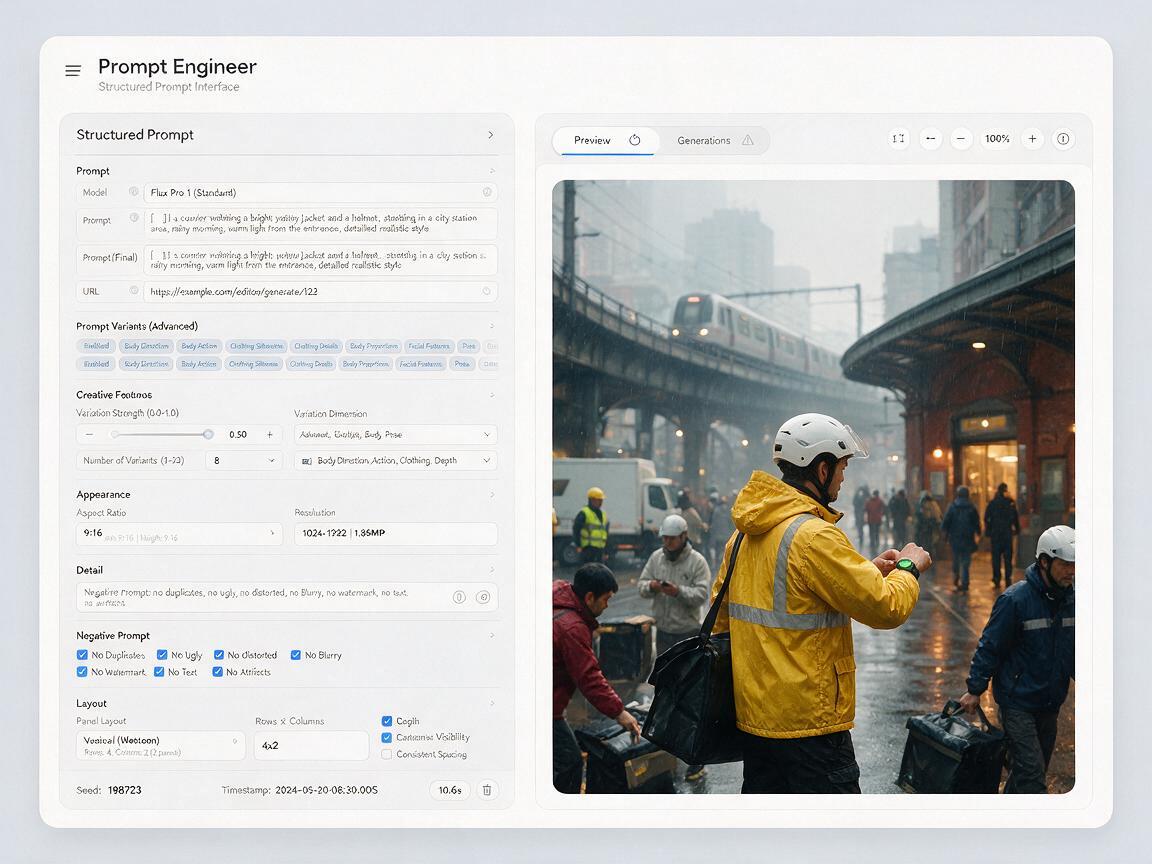
可靠的 Flux 提示词会按照从大构图到小变化的顺序描述分镜。先说明镜头和焦点动作,然后将两到三个群组放置在明确的景深区域中。最后补充风格、明度结构和排除项。
竖版网络漫画分镜,拥挤通勤车站内的平视中远景镜头。右侧前景中,一名身穿黄色雨衣的年轻快递员停下脚步,回头看向身后,与人群清晰分开。中景中有三个鲜明的群组:两名办公室职员一边交谈一边向左匆匆赶路;一名家长在售票机旁蹲在孩子身边;两名学生站在柱子旁彼此面对。最远处背景中是压缩、相互重叠的剪影和局部头部,面孔因距离而简化。间距不均,身体朝向各异,身高和服装轮廓不同,自然遮挡。最强对比集中在快递员身上,人群使用克制的色彩和更柔和的细节,干净利落的漫画线稿,清晰易读的竖版构图。避免重复面孔、镜像姿势、间距均匀的头部和完全相同的服装。注意,这段提示词并没有要求固定数量、且全部完整渲染的陌生人。它为少数群组分配动作,同时允许远处人物转化为氛围元素。在进行 text to image 生成时,这种方式比要求生成二十个独特人物能提供更强的结构引导。
能够产生明显差异的变化类别
选择在分镜尺寸下仍然清晰可见的差异。细微的面部细节可能会消失,但剪影和动作在缩小后仍能保留。
- 身体朝向:面向左侧、转身、弯腰、坐着或横穿画面。
- 动作:查看手机、搬运箱子、指向某处、说话或等待。
- 剪影:长外套、背包、雨伞、宽腿裤或短款夹克。
- 身高和比例:将成年人、青少年和坐着的人物分布在不同景深中。
- 遮挡:人物部分隐藏在柱子、标牌、家具或其他人后面。
避免在一个提示词中堆砌种族、发型、配饰和颜色的长清单。过多的列表可能使每个人物在视觉上都过于抢眼。选择少数高影响力的差异,并将它们分配给指定群组。
利用遮挡让人群显得自然
真实的人群并不是一组彼此孤立的完整人物。人们会相互重叠、从画面边缘进入,也会消失在物体后方。这些打断能让场景充满人气,同时减少模型需要处理的身体结构。
以下是一些塑造人群的实用短语:
- 前景肩膀穿过左下角
- 被右侧边缘裁切的局部人物
- 高度各异、相互重叠的头部
- 被长椅遮住的下半身
- 远处面孔简化为极少的笔触
- 小型社交群组之间不规则的间隙
遮挡仍然必须服务于故事。不要让随机的前景头部遮住重要的反应、手势或道具。应将人群视为一种框景装置,引导视线朝向故事重点。
修复重复路人,而不是重新生成整个分镜
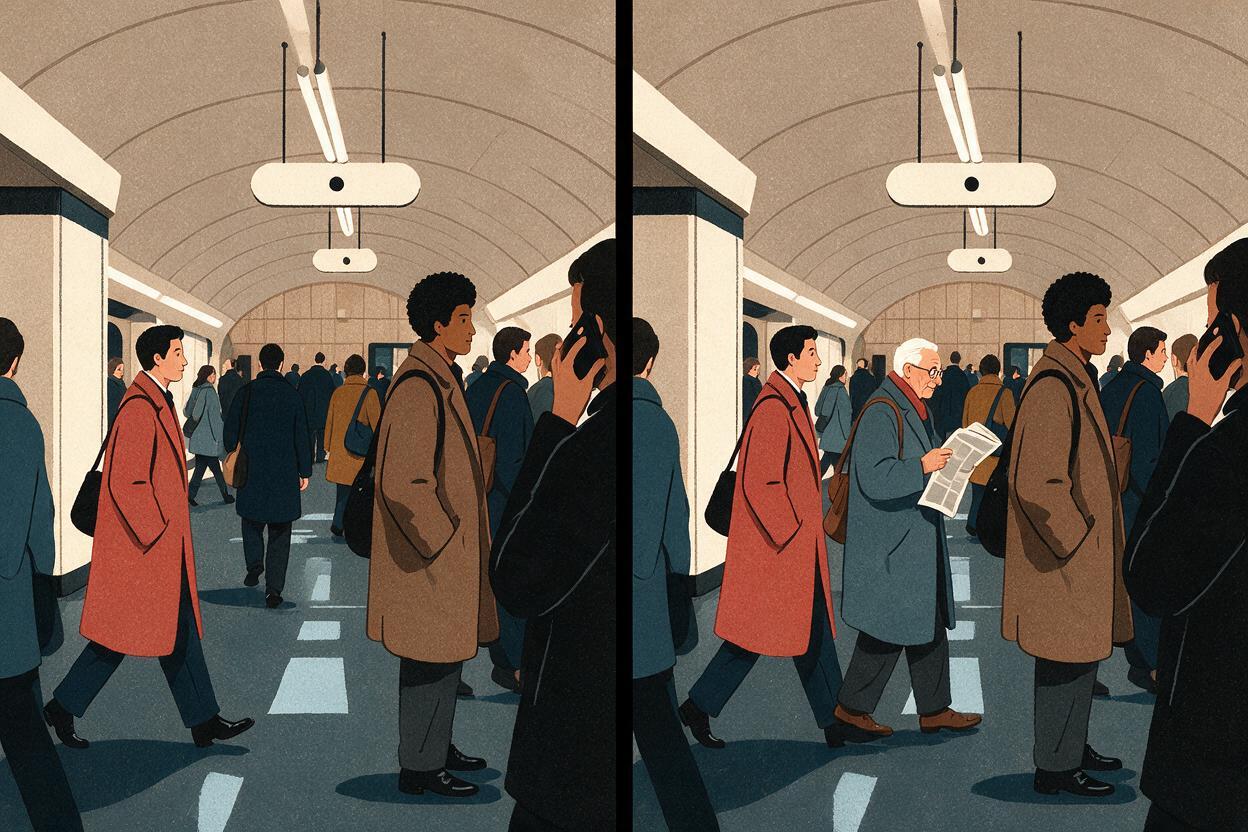
即使构图出色,也可能包含两张几乎相同的脸或重复的夹克。重新生成整个场景有可能改变主角、镜头角度和环境。相反,只需标记一个重复人物进行局部编辑。
为替换人物指定新的动作和剪影,而不是提出模糊的修改要求:
仅替换选中的背景人物。创建一名穿宽松深色开衫的年长通勤者,身体以四分之三角度背向镜头,一只手拿着折叠报纸。保留原有位置、比例、光照、线条粗细、透视关系和周围的遮挡关系。不要改变快递员、车站建筑或相邻人物。如果两个人物共享同一个姿势,就改变其中较不重要的那个。如果多个头部形成网格,可以删除一个人物,或将其推到另一个人物后方,而不是继续增加细节。留出空隙并增加遮挡,往往比再生成一个人物更能改善人群效果。
优先修复读者真正会注意到的问题
- 焦点角色旁边的重复人物
- 中景中重复的面孔
- 相同的鲜艳服装轮廓
- 镜像手势或平行肢体
- 远处剪影中的轻微重复
最后一类可能不需要修正。在正常阅读尺寸下,远处的重复可以融入纹理。应将修复时间花在会破坏分镜故事或制造明显视觉节奏的克隆现象上。
只有在故事需要时,才保持重复出现的路人一致
并非每个群像成员都应该成为反复出现的角色。过度设计一次性路人会增加连续性维护工作,却不会改善场景。应将稳定的身份细节留给会说话、影响行动或在后续分镜中再次出现的人物。
对于重复出现的路人,可以保存一份简洁的参考资料,其中包括:
- 正面或四分之三侧脸视图
- 具有主导性的发型轮廓
- 一个易于识别的服装特征
- 相对于主角的大致身高
- 一句描述其叙事作用的话
其他人则可以通过临时的场景角色来定义,例如不耐烦的乘客、正在堆放水果的摊贩或正在拍摄事件的学生。这样可以产生有目的的变化,而不会将人群管理变成完整的角色设计项目。
在最终阅读尺寸下测试人群效果
人群在放大时可能看起来很壮观,但放进手机宽度的网络漫画分镜后却可能变得混乱。将图像缩小到预期显示尺寸,先检查焦点角色。你应该在观察任何单独路人之前,就能认出主要动作。
然后以灰度模式评估分镜。如果背景服装产生的对比度强于主角,就降低其明度范围或饱和度。如果人群变成一堵平面墙,应通过遮挡、比例变化和更柔和的远景边缘来增加景深,而不是到处添加随机模糊。
最后,将该分镜与前后分镜放在一起检查。密集的人群场景通常会在相邻分镜较为安静时呈现更好的效果。视觉叙事依赖不同时刻之间的对比,而不是让每一格都拥有最大细节量。
最终检查清单
- 让主角拥有最清晰的细节和最强的对比度。
- 将路人组织为焦点、辅助和氛围三种角色。
- 为可见群组分配不同的动作和身体朝向。
- 利用裁切、遮挡和环境物体打破重复。
- 局部修复重复人物,而不是重新生成整个场景。
- 只为会再次出现或影响故事的路人保留身份一致性。
- 在最终漫画或网络漫画阅读尺寸下检查结果。
确定人群角色和构图后,免费试用这些模型,并在进行详细修复前比较多种变化方案。
关键词
ai 漫画人群、漫画人群提示词、Flux 提示词、漫画人群场景、背景角色、漫画 AI 生成器、AI 视觉叙事