如何使用图像转视频创建受控的移焦效果
通过让两个主体处于明显分离的景深位置、生成稳固的锚点帧,并以最少的竞争性运动制作一次明确的焦点变化,创建令人信服的 AI 移焦效果。本工作流结合图像转视频生成、模型对比和短片段修复,避免模糊脉动、意外变焦以及主体不稳定等问题。
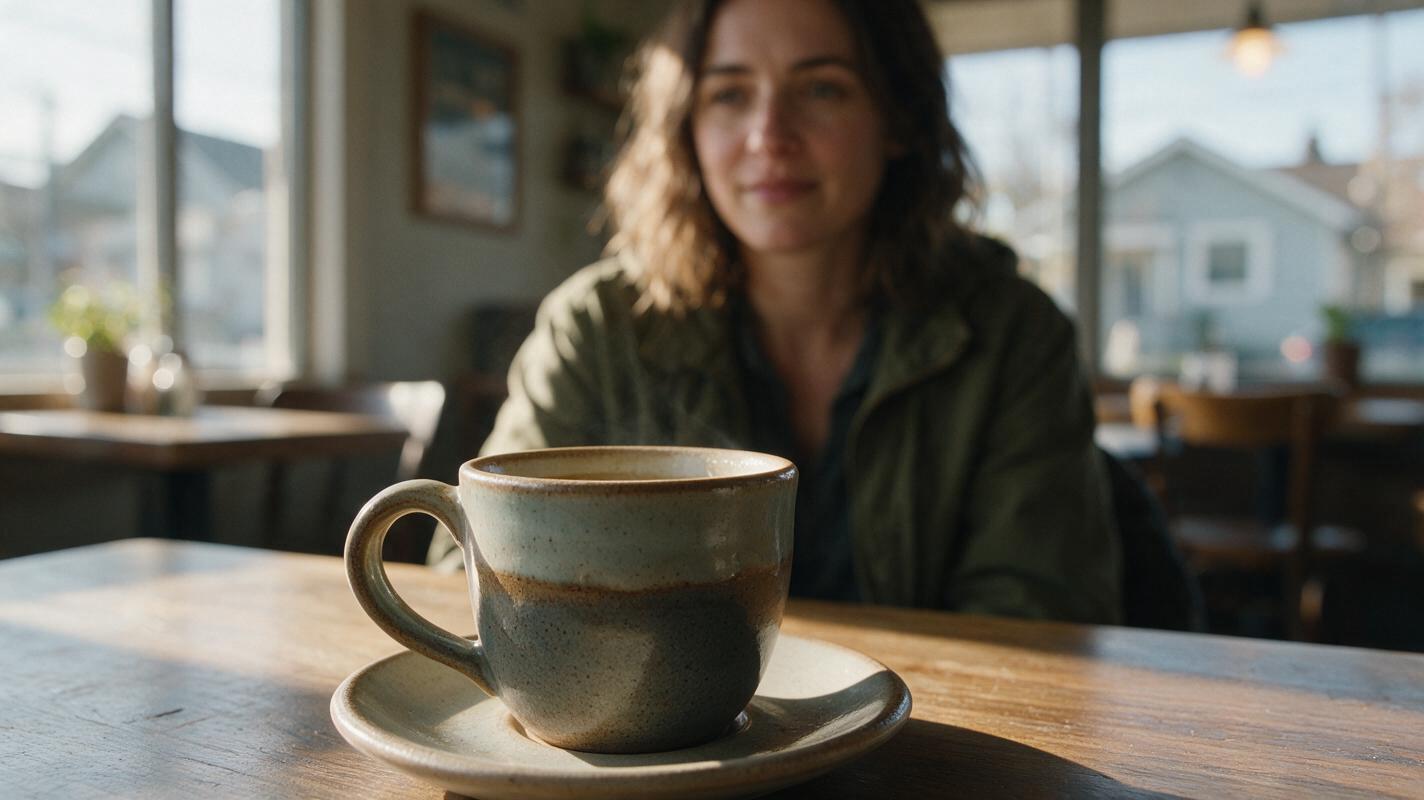
文章目录
TL;DR:先构建景深,再制作一次焦点变化
在ai video中创建受控移焦效果,最快的方法是先准备一张锚点图像,其中包含一个清晰的前景主体和一个与其景深明显分离的背景主体。然后使用简短提示词为这张图像添加动画,让摄影机和主体保持静止,只将焦点从明确命名的起始平面转移到明确命名的目标平面,并且只转移一次。
避免同时要求模型构思构图、执行复杂动作、移动摄影机和改变焦点。令人信服的焦点拉动通常是一种克制的光学事件,而不是充满运动的转场。
为什么 AI 移焦镜头经常看起来不对
真实的移焦会在连续拍摄过程中改变镜头的对焦距离。一个景深平面变得模糊,而另一个变得清晰,从而在不需要剪辑的情况下引导注意力。AI 视频模型可以模仿这种外观,但不一定会模拟真实的物理镜头。
常见问题包括:
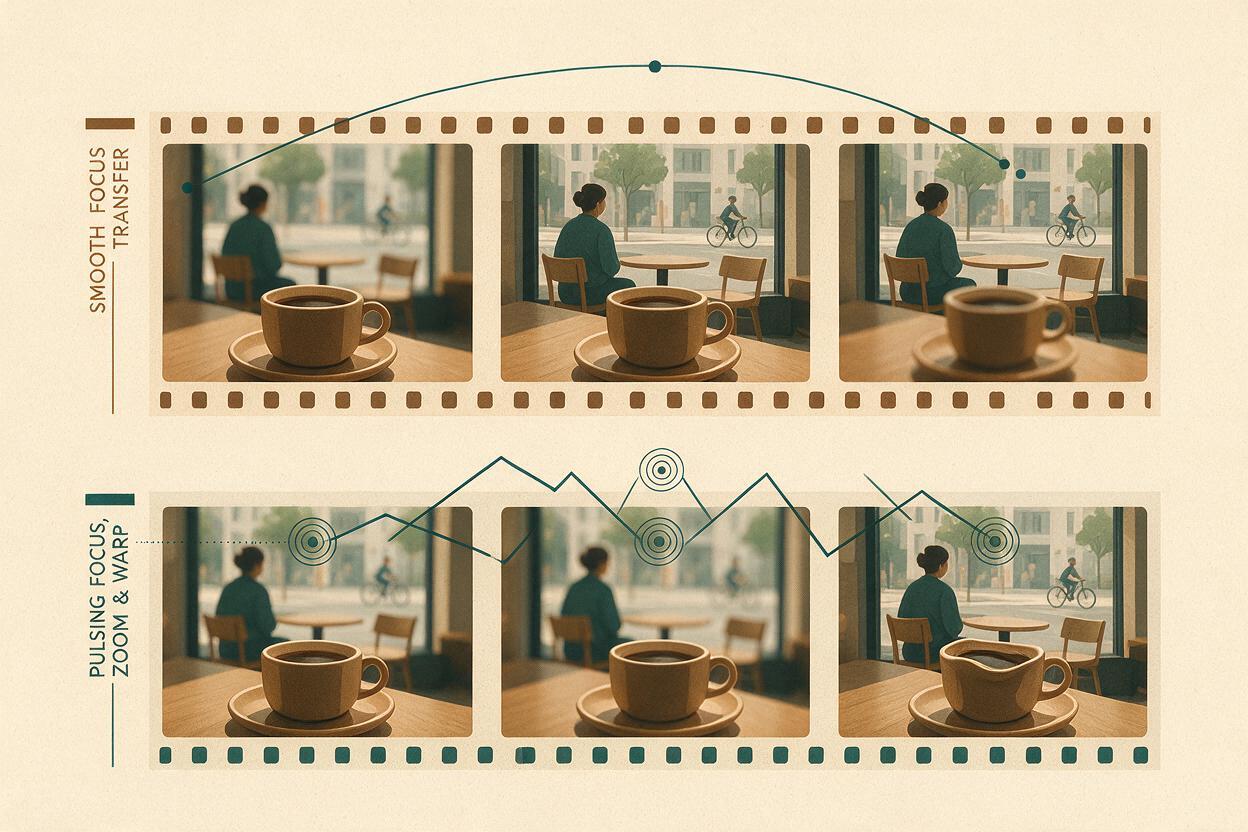
- 焦点抽动:清晰度在主体之间来回振荡,而不是只移动一次。
- 数字变形:模糊主体的形状、服装或面部结构发生变化。
- 意外的摄影机运动:原本要求的焦点拉动变成推进、变焦或推轨镜头。
- 均匀模糊:由于主体没有处于不同的景深平面,整个画面都变得柔软。
- 目标焦点不够清晰:背景主体虽然不再那么模糊,却始终没有真正清晰起来。
- 时序错误:焦点立即发生变化,导致拉焦前后没有可辨识的停留时间。
这些症状通常源于源构图。如果两个主体大小相近、严重重叠,或看起来处于同一平面,模型就缺乏进行真实焦点转移的视觉依据。
创建焦点拉动的三种方式
- 锚点帧图像转视频:先设计景深关系,再为其添加动画。这种方式控制力最强,也是下面的主要工作流程。
- 文本转视频:在一个提示词中描述完整场景和焦点事件。探索速度更快,但可预测性较低。
- 双片段编辑模拟:分别生成一个前景对焦片段和一个背景对焦片段,然后在编辑器中将它们混合。当模型反复出现焦点抽动时,这种方法非常有用。
最佳默认设置:使用一张锚点图像、一个焦点目标、一台静止的摄影机,以及非常轻微的主体运动。
MagicBoat 如何处理焦点受控的 AI 视频
MagicBoat 提供基于一个账户的工作流程,让你无需在不同平台之间重复搭建项目,就能测试图像和视频生成模型。你可以使用 Seedream、Flux 或 GPT Image 等可用图像模型创建锚点帧,然后将同一构图发送给 Seedance 或 Kling 等image to video模型。
这种多模型方法对移焦尤其有用,因为同一个提示词可能产生不同的解读。一个模型可能更好地保留构图,而另一个模型可能产生更明显的焦点转移。在比较输出时,应保持源图像、宽高比、时长和提示词含义不变。
| 工作流程 | 最佳用途 | 主要风险 |
|---|---|---|
| 文本转视频 | 快速探索场景 | 构图和焦点被同时构思 |
| 图像转视频 | 控制景深和主体位置 | 源图像本身可能包含模糊不清的焦点 |
| 双片段混合 | 修复不稳定的焦点行为 | 两个片段之间的运动必须匹配 |
步骤 1 — 定义双平面焦点图
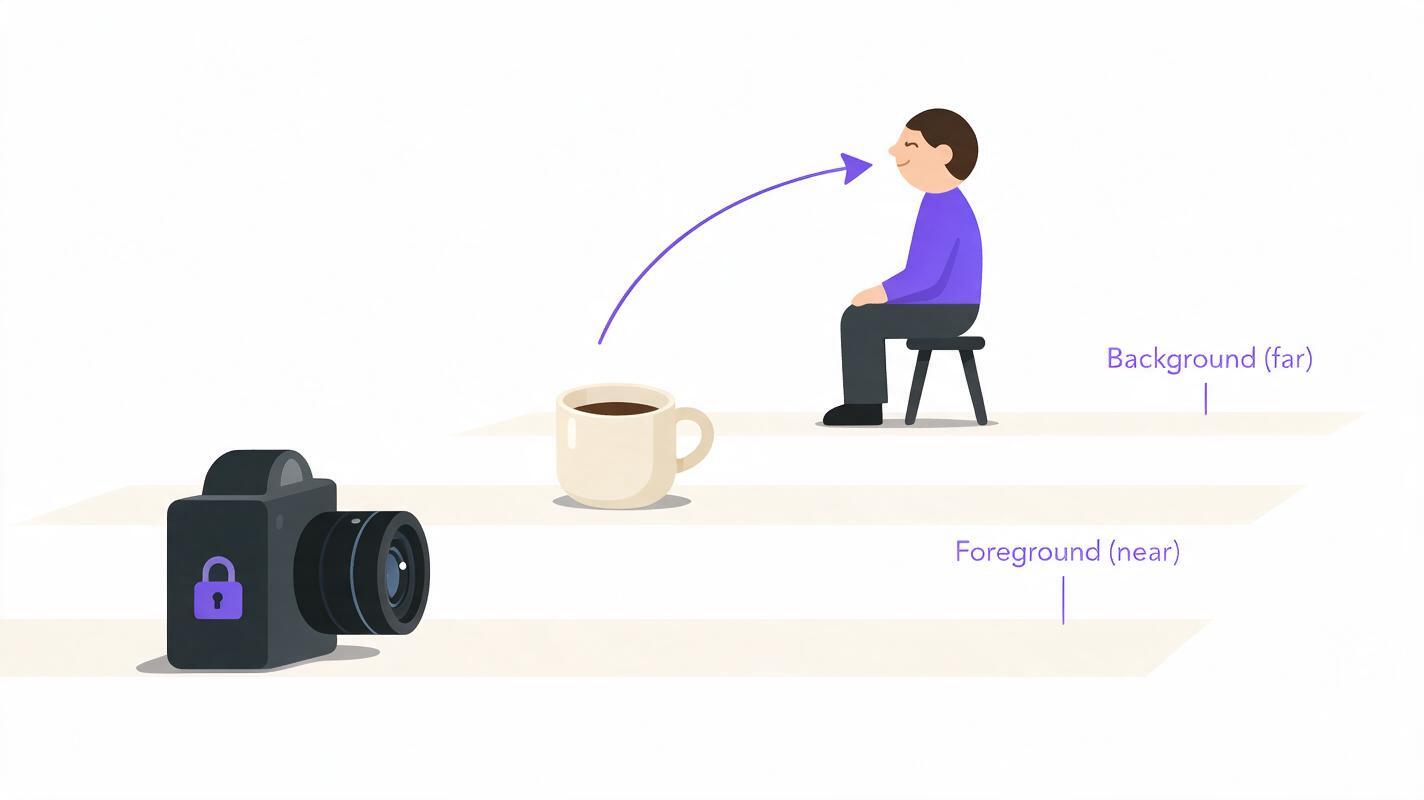
在撰写电影感提示词之前,先将镜头简化为两个明确命名的景深平面。确定开始时什么清晰、结束时什么清晰,以及焦点转移后观众应该注意什么。
使用简洁的规划块:
前景:陶瓷咖啡杯,距离摄影机 25 厘米,开始时清晰
背景:坐在窗边的女性,距离摄影机 3 米,结束时清晰
摄影机:锁定的中远景构图
焦点动作:从前景到背景的一次平滑拉焦
主体运动:女性向咖啡杯轻轻瞥一眼
结束停留:背景保持清晰
选择轮廓不同、物理距离足够分离的主体,让景深关系清晰可辨。花朵、玻璃杯、肩膀、门框或桌面道具等前景物体都很适合。背景目标应保持足够大,以便焦点到达后仍然清晰可读。
预期结果:一份恰好包含两个焦点目标,并且焦点移动方向明确的镜头计划。
步骤 2 — 生成具有明显景深的锚点帧
在尝试制作运动之前,先创建一张静态图像。起始帧应当已经显示出清晰对焦的前景目标,以及柔和模糊的背景目标。使用大小差异、前景局部裁切、地面线条或重叠家具等透视线索。
自然晨光下安静的社区咖啡馆,电影感室内场景。
一个手工陶瓷咖啡杯占据左下方前景,
杯沿清晰,并能看到釉面的纹理。三米之外,一名身穿
橄榄色夹克的女性坐在窗边,面部可辨认,但处于柔和的失焦状态。
锁定的中远景摄影机,真实的浅景深,50mm 镜头质感,
自然比例,克制的色彩调色板,无文字。
不要使用极度模糊。背景目标必须保留足够的结构信息,以便视频模型在焦点变化时重建它。如果面部只是一小块无法辨认的色彩,模型可能会在拉焦过程中凭空生成新的面部细节。
如果咖啡杯遮挡面部、背景主体过小,或两个主体看起来同样清晰,就应舍弃该锚点帧。持续生成替代版本,直到景深关系一眼就能看懂。
预期结果:稳定的起始构图、清晰的前景锚点、可被重建的背景主体,以及可信的空间分离。
步骤 3 — 从提示词中移除竞争性运动
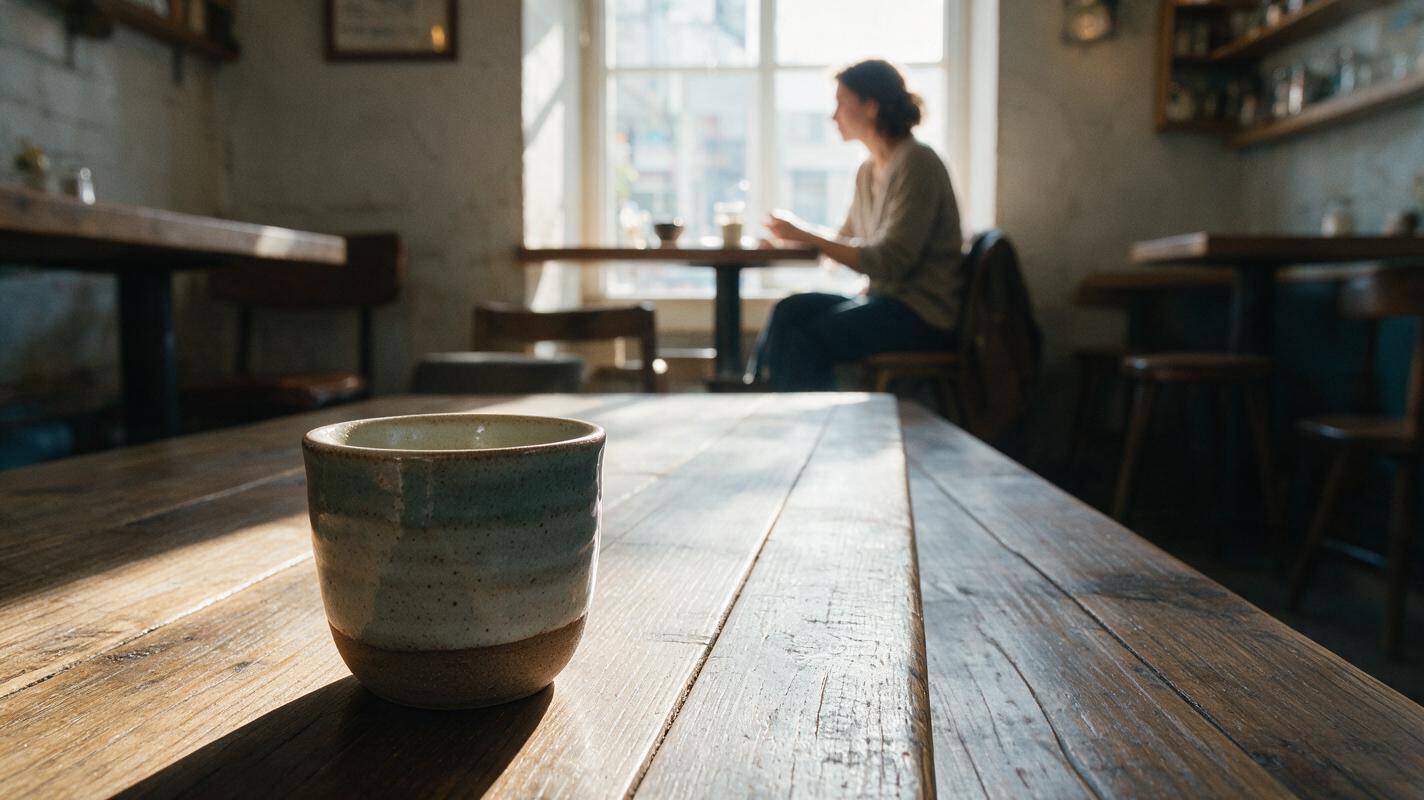
焦点拉动本身已经引入了一个重要的时间变化。第一次测试时,应让其他指令保持克制。避免将其与环绕运动、快速对话、行走、手部互动、天气变化或戏剧性的光线转场结合。
使用运动层级:
- 焦点运动是主要事件。
- 一个微小动作用于增强真实感。
- 摄影机和环境保持稳定。
摄影机始终完全锁定。咖啡杯保持静止。
女性自然地向前景轻轻瞥一眼。
不要变焦,不要推轨,不要摇摄,不要重新构图,不要移动物体。
否定性措辞无法保证模型完美执行,但可以明确哪些视觉变化是不需要的。诸如“锁定摄影机”这样的正向表述,应比一长串禁止事项更具权重。
预期结果:模型将时间容量用于焦点变化和细微生命感,而不是重新设计镜头。
步骤 4 — 将焦点拉动作为有时序的光学事件进行提示
按照时间顺序描述起始状态、转移过程、目标状态和最终停留。应明确命名主体,而不是使用“前面”和“后面”等模糊词语。
锁定的电影感镜头。开始时,陶瓷咖啡杯清晰对焦,
背景中坐着的女性柔和模糊。短暂停留。
从咖啡杯到女性面部进行一次平滑、明确的移焦。
咖啡杯自然变得柔和,同时她的面部逐渐清晰对焦。
稳定保持最终的背景焦点。只有细微的呼吸动作。
不要变焦,不要推轨运动,不要焦点抽动,不要改变场景。
“短暂停留”和“稳定保持最终焦点”会为片段提供便于剪辑的把手。如果没有这些停留,生成的视频可能会从焦点转移的中途开始,或者在目标主体变得清晰之前就结束。
如需反向拉焦,只改变方向:
开始时,女性面部处于清晰的背景焦点,前景
咖啡杯柔和模糊。将焦点只拉动一次到咖啡杯,然后保持咖啡杯清晰。预期结果:一次清晰可读的转移,而不是反复自动重新对焦。
步骤 5 — 使用相同输入比较 Seedance 和 Kling
如果 Seedance 和 Kling 都可用,请将同一锚点帧和语义相同的提示词分别输入两者。第一次比较时,不要为了迎合各自的结果而改写提示词;否则你将无法判断差异究竟来自模型还是措辞。
| 检查项 | 检查内容 | 拒绝原因 |
|---|---|---|
| 构图 | 物体位置和取景 | 推进、裁切变化或摄影机漂移 |
| 焦点路径 | 单向转移 | 清晰度反转或出现脉动 |
| 身份 | 面部、服装和轮廓 | 变清晰时五官发生变化 |
| 前景 | 道具的形状和材质 | 杯沿融化或几何形状发生变化 |
| 最终停留 | 稳定的目标焦点 | 片段在转移过程中结束 |
应评估整个镜头,而不只是模糊效果是否明显。相比伴随面部或物体变形的强烈模糊,几何结构稳定的柔和焦点变化通常更有用。
预期结果:公平地比较模型,找出最实用的片段,而不是视觉效果最激进的片段。
步骤 6 — 在不重建场景的情况下修复不稳定结果
如果镜头接近可用但仍有问题,应一次诊断一个故障。保留锚点帧,并尽量保持大部分提示词不变。
- 如果摄影机变焦:将“锁定摄影机”移到第一句,并删除“展现”“靠近”或“电影感运动”等词语。
- 如果焦点抽动:重复“一次连续的焦点拉动”,并强化最终停留。
- 如果背景面部发生变化:降低锚点图像中的模糊程度,或缩短焦点转移时间。
- 如果没有任何变化:增加景深分离,并明确说明起始主体会变得柔和。
- 如果两个主体都保持清晰:修改静态图像,而不是在运动提示词中堆叠更多镜头术语。
你也可以将镜头拆分为两次短生成。使用中点附近的最佳帧作为后续片段的起始参考,以完成并保持目标焦点。在清晰度、构图和主体姿势最接近的位置裁剪两个片段。
预期结果:针对性的修正,在保留成功构图的同时避免引入新的变量。
步骤 7 — 编辑出可信的焦点节奏
逐帧查看转移附近的片段。删除不稳定的开头帧,保留短暂的起始停留,并让最终焦点稳定后再切走。移焦传达的是思考或发现,因此其编辑时序应与故事节拍相匹配。
细微的声音可以强化注意力转移,而不必直接模仿镜头声音。例如,当背景人物变清晰时,略微降低前景咖啡馆的环境噪声;或者等焦点到达说话者后,再加入一小段安静的对白。
不要用过度的运动模糊掩盖失败的焦点拉动。如果目标从未清晰呈现,就修复或替换该镜头。
预期结果:干净的注意力转移、清晰可读的视觉停留,以及两端都具备明确的剪辑点。
在整个项目中保持一致的焦点语言
为反复出现的场景创建一套简短的焦点词汇。重复使用“锁定摄影机”“一次连续的移焦”“保持目标平面清晰”和“仅有细微呼吸动作”等短语。一致的措辞能让比较更容易,也能减少不同镜头之间的意外变化。
同时维护一份简单的镜头记录,包括源帧、模型、宽高比、提示词、焦点方向和失败记录。目标不是找到一个万能提示词,而是确定哪些景深安排和指令在你的视觉风格中表现可靠。
替代方案:使用两个片段模拟移焦
当光学行为仍然不稳定时,可以从同一构图生成两个克制的片段:一个偏向前景清晰,另一个偏向背景清晰。让主体运动保持最少,并尽量匹配两个片段的首帧。在编辑器中叠加片段,并使用短暂的溶解;如果编辑软件支持,还可以对局部模糊进行动画处理。
这种替代方案在物理上不够纯粹,但能提供精确的时序,并避免反复出现焦点抽动。它最适合静态环境,以及只进行微小动作的主体。
替代方案:使用运动迁移制作以表演为主的镜头
如果背景人物必须完成特定手势,应将表演动作单独优先处理。使用运动迁移建立身体动作,然后选择一个姿势与前景构图相容的克制片段。围绕受控手势添加移焦,比围绕不可预测的全身表演添加移焦更容易。
对于对白覆盖镜头,可以考虑在焦点拉动后剪切到更清晰的近景,而不是要求一个生成镜头同时处理焦点、口型运动、手势和摄影机运动。
这种工作流程的局限
- 生成式焦点不一定遵循物理准确的镜头行为,也不一定能产生真实的散景。
- 严重模糊的面部在变清晰时可能获得新的细节,从而造成身份漂移。
- 透明玻璃、反射、烟雾、头发和细小树叶可能出现不一致的模糊。
- 过长的焦点拉动会给模型更多时间引入摄影机漂移或物体变形。
- 单张源图像无法展现那些从未被足够清晰地表现、因而无法重建的背景细节。
当身份、产品几何形状或光学准确性至关重要时,应将 AI 生成视为制作素材片的步骤,并在传统合成软件中完成焦点效果。
常见问题
移焦应该使用文本转视频还是图像转视频?
当主体位置和焦点方向很重要时,应使用图像转视频。文本转视频适合探索构图,但它要求模型同时构思场景和光学事件。
锚点帧中的背景应该模糊到什么程度?
应足够柔和,以建立景深,但不能模糊到目标主体失去面部结构、服装边界或轮廓。适度模糊能提供更好的重建依据。
我可以在焦点拉动过程中加入摄影机运动吗?
可以,但应先使用锁定摄影机测试焦点。确认可行后,再将缓慢推进或摇摄作为单独变量加入。一开始就把两者结合,会让问题更难诊断。
为什么模型会变焦,而不是改变焦点?
“将注意力引向背景”更容易被视觉化解读为变焦。请明确写出“锁定摄影机”,命名两个焦点平面,并描述前景变柔、背景变清晰的过程。
移焦可以用于两个人吗?
可以。让两人处于明显不同的距离,并避免面部重叠。让非焦点主体的运动保持细微,以免模型在转移清晰度时混合身份。
焦点转移应该持续多久?
没有统一的时长。应优先保证短暂的起始停留、一次清晰可读的转移,以及稳定的结束停留。如果较长的转移造成焦点抽动,就生成更短的事件,并在编辑时调整时序。
创建你的第一个受控焦点镜头
从双平面规划块开始,生成一张景深清晰可读的锚点帧,并在可用模型中测试同一个焦点提示词。在 MagicBoat 上免费创建你的第一个 AI 视频,比较哪个结果最有效地保留了你的构图。
最终检查清单
- 准确选择一个起始焦点平面和一个目标平面。
- 通过景深、大小和构图分离主体。
- 确保目标主体在模糊的锚点帧中仍然可辨认。
- 第一次测试时锁定摄影机。
- 按照时间顺序描述焦点事件。
- 加入起始停留和最终停留。
- 使用相同的源图像和提示词含义比较模型。
- 拒绝焦点抽动、变焦、身份漂移和物体变形。
- 一次只修复一个故障变量。
关键词
图像转视频,AI 视频提示词工程,移焦,焦点拉动,景深布置,Seedance 提示词,Kling 提示词