AI 会说话的婴儿播客生成器:制作安全的虚构短片
了解如何通过人像生成、唇形同步、克制的动作和谨慎的剪辑,将原创婴儿风格角色制作成虚构的短播客视频。本工作流优先确保语音清晰、面部动画稳定、标注诚实,并通过基于证据的质量检查验证效果。
文章目录
分别创建角色、语音和表演
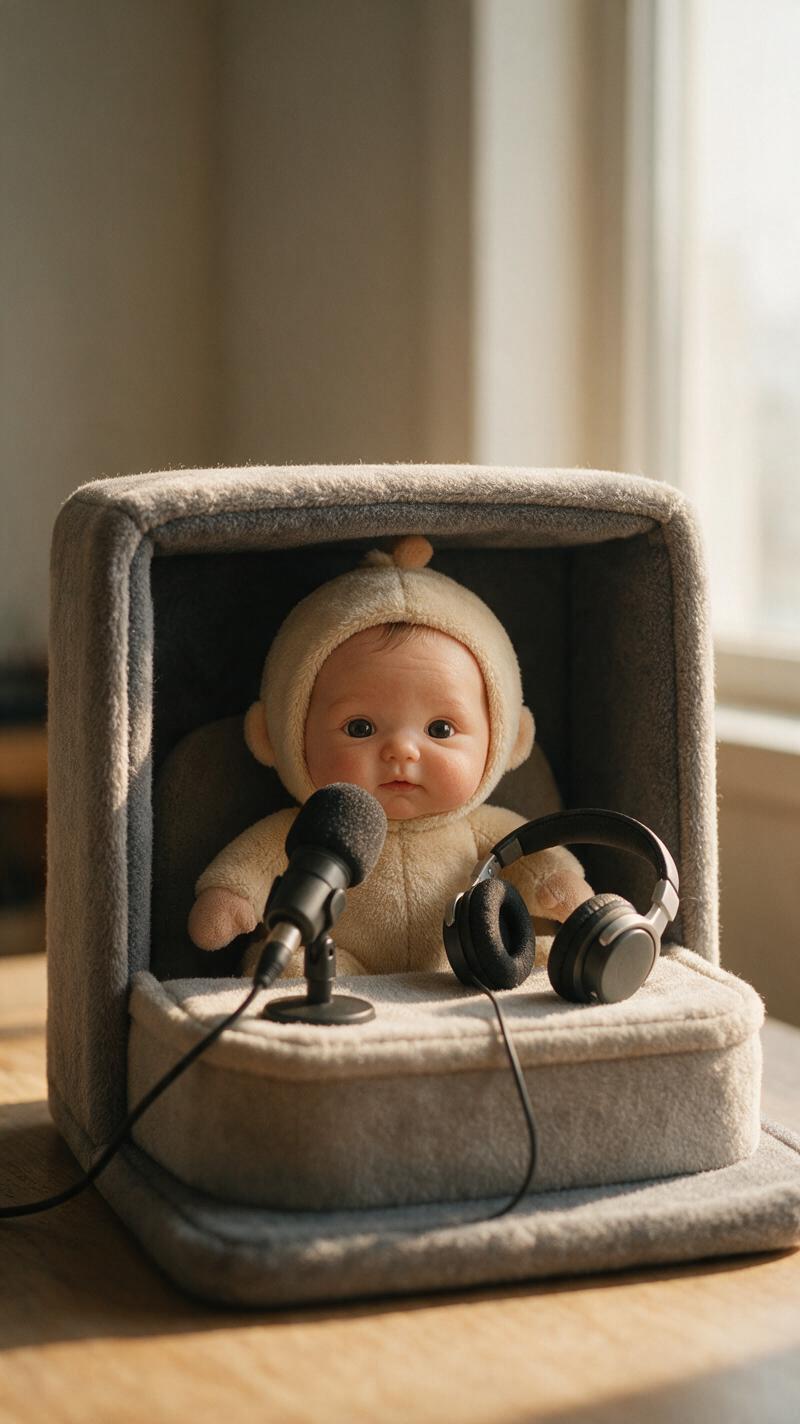
AI 会说话的婴儿播客生成器可以将单张角色肖像转换为轻松有趣的短篇采访、反应片段或虚构独白。最可靠的工作流不会要求一个模型同时完成角色、对白、语音、唇形同步、镜头运动和成片剪辑。
相反,应分阶段以可控方式完成:编写短脚本,创建一个明显虚构的婴儿风格主持人,录制或生成获准使用的音频,让肖像动起来,然后检查导出的视频片段。本教程使用原创角色,而不是现实儿童的影像,从而避免不必要的隐私和身份问题。
目标效果:一段 10–20 秒的竖屏播客片段,内容是一个虚构的婴儿风格角色,配有同步语音、细微手势、稳定的麦克风,以及足够的空白区域用于添加字幕。
步骤 1 — 定义一个虚构的播客场景
从一个可以用两三句话讲完的笑话、观点或反应开始。脚本过长会增加唇形同步偏移的可能性,也会让画面重复更加明显。
安全的创意应当明确属于虚构。不要将敏感、政治、医疗、金融或羞辱性言论放入真实儿童的形象中。为角色设计虚构的外观,并设定一个明确虚构的节目背景。
创意:一位虚构的婴儿风格太空探险家主持一档迷你播客。
主题:为什么应该再讲一个故事之后才睡觉。
时长:15 秒。
基调:好奇、机智、适合全家观看。
构图:竖屏中近景,麦克风清晰可见,上方留出字幕空间。
让口播文案保持对话感。相比绕口令或快速罗列,简短的分句和明显的停顿更容易实现同步。
大家都说睡觉很重要。我同意。
但首先,我们需要再讲一个故事,用于科学研究。
如果研究结果令人兴奋,也许还要两个。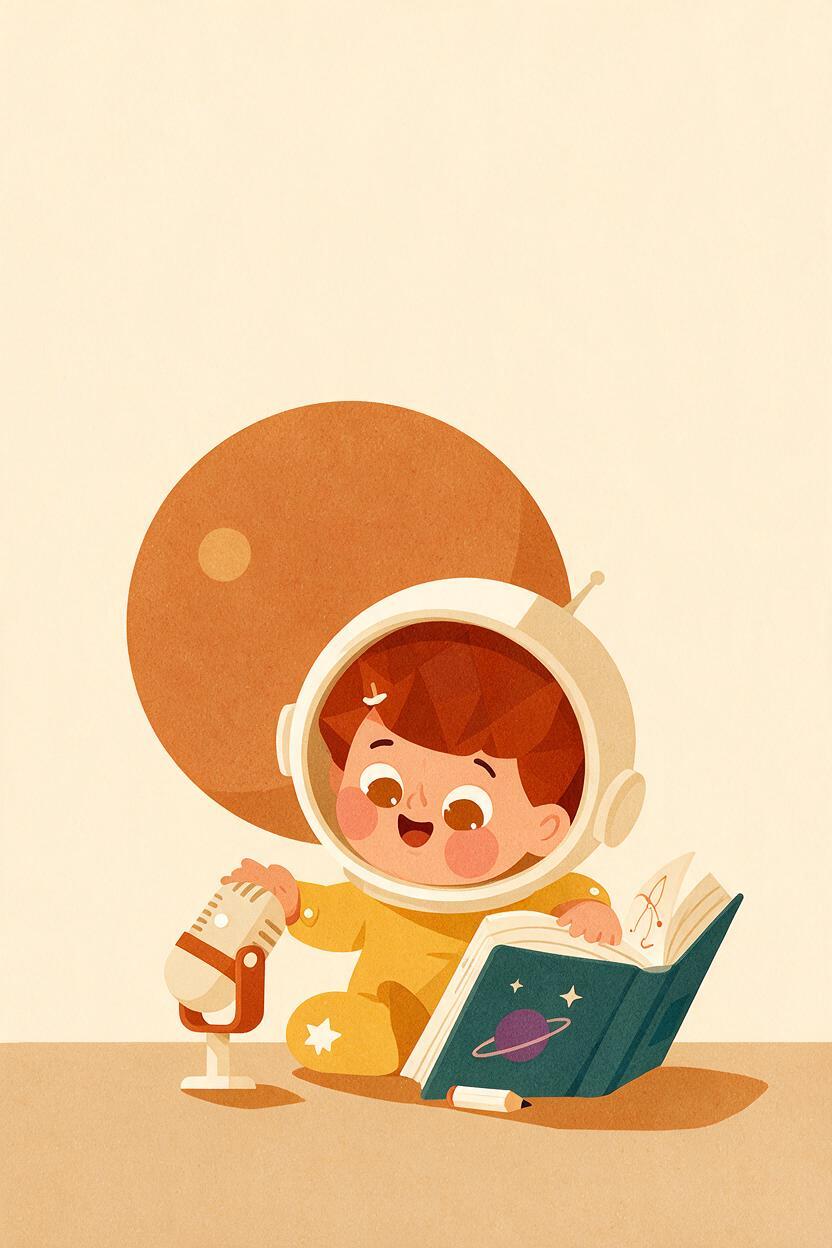
步骤 2 — 构建稳定的角色肖像
创建一张正面或略带四分之三角度的肖像,确保嘴唇清晰可见、光线均衡,并且没有物体穿过下半脸。MagicBoat 的 ai image generator 可用于在动画制作前生成原创角色图像。
使用“风格化的虚构角色”等视觉描述,而不是要求生成真实婴儿的相貌。画面中可以出现麦克风,但应放在嘴部下方,以便动画模型读取完整的唇部区域。
原创的虚构婴儿风格播客主持人,富有表现力的圆脸,
大而好奇的眼睛,坐在小型录音室麦克风后方,
温馨的家庭录音角落,柔和的窗光,中近景,
正面头部,略带四分之三角度,嘴唇完全可见,
竖屏构图,头部上方留出整洁的字幕空间,
适合全家观看的风格化写实效果,无文字,无标志
舍弃有牙齿不对称、手部触碰面部、嘴唇处阴影过重、麦克风部件重复,或头部裁剪过紧的肖像。这些缺陷在静态图像开始运动后通常会更加分散注意力。
步骤 3 — 准备有利于清晰唇形同步的语音
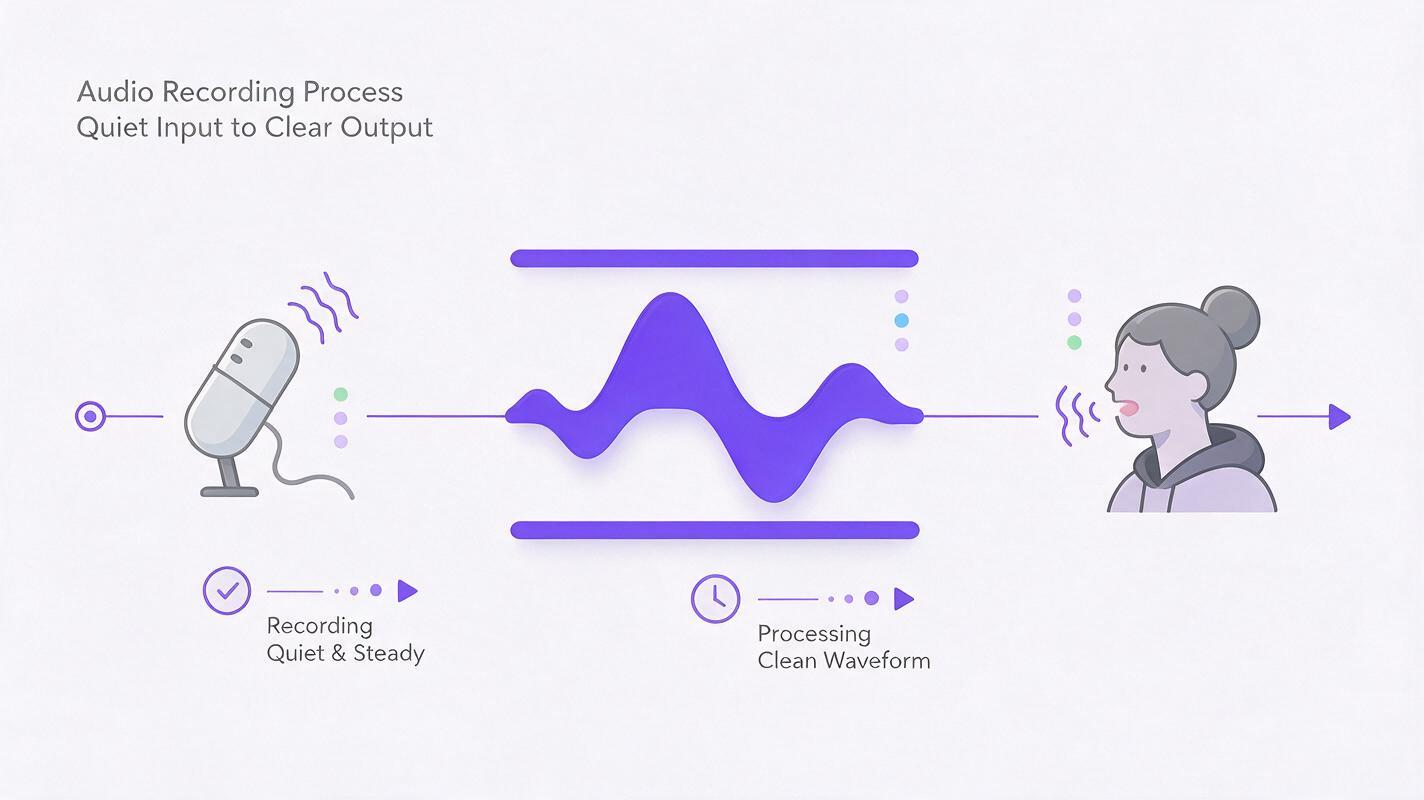
在安静的房间录制对白,或使用你拥有适当权利和同意的声音。未经许可,不要克隆可识别人物的声音。对于虚构角色,明显为合成或表演而成的声音也有助于观众理解场景是虚构的。
在句子之间留出短暂而自然的停顿。在动画制作前,去除过大的呼吸声、削波、音乐和背景噪声,因为唇形同步系统依赖语音轨道。如果需要清理,请使用适度的降噪,并将处理后的音频与原始音频进行比较,以确保辅音仍然清晰。
| 音频问题 | 可能造成的画面后果 | 实际修正方法 |
|---|---|---|
| 音乐盖住辅音 | 嘴部动作松散或延迟 | 使用干声对白制作动画,之后再添加音乐 |
| 语速过快 | 嘴型动作过度或出现跳帧 | 放慢朗读速度并加入短暂停顿 |
| 降噪过重 | 音节边界不清晰 | 降低处理强度并保留发音细节 |
| 峰值削波 | 语音刺耳且时间点不可靠 | 重新录音或降低输入增益 |
步骤 4 — 使用克制的动作让肖像动起来
将确认无误的肖像和清理后的对白导入唇形同步或虚拟形象工作流。MagicBoat 的 talking photo ai 是将静态角色和语音转换为会说话肖像的最直接相关功能。
在添加戏剧性动作之前,优先确保唇形同步。如果所选模型接受动作指令,请要求偶尔眨眼、轻微点头,并固定摄像机。大幅转头可能使脸颊变形或遮住嘴部,而过于激烈的动作模仿可能与由音频驱动的面部动画产生冲突。
保持角色身份、服装、麦克风和背景完全一致。
自然的、由语音驱动的嘴部动作,偶尔轻柔地眨眼,
第一句话结束后轻轻点头一次,细微呼吸,
肩膀保持稳定,摄像机固定,不缩放,不转头,
不添加新物体,无文字,背景不移动。
如果有负面提示词字段,请使用一份专注于可见故障的简短列表:
嘴部变形,多余牙齿,重复的麦克风,眼睛漂移,
大幅转头,摄像机抖动,服装变化,背景移动
与其生成一段很长的表演,不如生成多个短片段。选择嘴部时间点最清晰、身份最稳定的片段,不一定要选择动作最多的片段。
步骤 5 — 在剪辑中增加播客氛围
通过剪辑,而不是过度生成,可以让会说话的肖像更具吸引力。将选定的片段放入 9:16 时间线,剪掉无意义的停顿,添加易读字幕,并在句子交界处使用一两次适度的推进裁切。
- 让字幕远离嘴部:使用上下安全区域,避免遮挡面部动作。
- 在唇形同步之后添加音乐:将音量保持在足够低的水平,确保每个词都能听清。
- 用剪切隐藏不理想的瞬间:短暂改变裁切范围可以遮盖尴尬的眨眼或嘴部过渡。
- 保留麦克风:避免添加看起来会从麦克风后方或中间穿过的动画叠加元素。
对于双角色对话,应分别为每位说话者制作动画。在剪辑器中交替使用不同片段,而不是要求一张图像同时管理两张独立说话的面孔。
步骤 6 — 只修复观众看得见的缺陷
ai video enhancer 不能替代干净的源肖像。当最终导出存在轻微模糊、嘴唇周围有压缩痕迹,或深色背景中出现明显噪点时,增强功能很有用;但过度处理可能会使牙齿变得不自然锐利,或抹平皮肤纹理。
当你使用 AI 增强视频时,测试一段包含语音、眨眼和麦克风边缘的五秒片段。在最终交付尺寸下比较原始版本和处理版本。只有当增强版本改善了明确指出的缺陷,且没有引入光晕、冻结纹理或面部闪烁时,才保留它。
剪辑规则:用新的动画片段修复时间同步问题,在剪辑器中修复构图,并且只在解决分辨率、噪声或压缩问题时使用增强功能。
步骤 7 — 记录前后对比证据
不要根据暂停时的精美画面判断结果。保存源肖像、第一版原始动画和最终剪辑导出文件。检查这三个版本,以便将变化归因于正确的制作阶段。
| 检查点 | 之前 | 之后 | 通过条件 |
|---|---|---|---|
| 唇形时间 | 原始动画 | 选定或重试的片段 | 句子的开始和结束与音频一致 |
| 身份一致性 | 源肖像 | 最终运动画面 | 眼睛、脸型、服装和麦克风仍然清晰可辨 |
| 动作 | 第一次生成 | 克制动作版本 | 没有分散注意力的转头、摄像机抖动或背景漂移 |
| 清晰度 | 未处理的导出文件 | 最终编码导出文件 | 在观看尺寸下,嘴唇和麦克风边缘仍然清晰 |
检查开头画面、语速最快的短语、每次眨眼以及最后一帧。还要在不观看画面的情况下听一遍,并在静音状态下观看一遍。第一次检查可以发现音频问题;第二次可以暴露重复动作和面部不稳定。
步骤 8 — 负责任地标注并发布虚构片段
当合成内容的性质可能不明显时,应在字幕或描述中说明角色由 AI 生成或属于虚构。对于逼真的修改内容或合成媒体,各平台可能有不同的披露要求,因此请查看视频片段发布平台的当前政策。
不要暗示是现实中的儿童说出了这些话,也不要在没有适当授权的情况下上传未成年人的个人图像或录音。对于频道品牌建设,应在各集内容中保持虚构角色的姓名和外观一致,同时改变脚本、反应时机和构图。
肖像和获准使用的音频准备好后,免费试用此提示词,先生成一个短测试,再决定是否制作完整系列。
常见问题
可以使用真实婴儿的照片吗?
虚构的生成角色是更安全的默认选择。如果使用真实儿童的图像或声音,请获得父母或法定监护人的授权,避免敏感场景,并遵守适用的隐私和平台规则。
为什么嘴部看起来变形了?
常见原因包括嘴部被遮挡、头部角度极端、语音嘈杂、语速过快或动作过度。请改用正面肖像,清理对白,并以克制的动作生成更短的片段。
应该让麦克风和背景动起来吗?
通常不应该。稳定的麦克风和静态背景更容易发现面部错误,也能减少模型需要保持一致的元素数量。
动作模仿能让角色更有表现力吗?
如果工具支持动作参考,它可以提供身体节奏,但夸张的参考动作可能会干扰唇形同步流程。使用带有小幅点头且肩膀稳定的表演,然后确认嘴部仍然与语音同步。
第一次测试应该多长?
使用一个大约 10–20 秒的完整想法。这一长度足以包含多种嘴型和一次停顿,同时如果出现错误,也便于重新生成。
来源
最终检查清单
- 主持人是原创且明确虚构的婴儿风格角色。
- 源肖像中的嘴唇没有被遮挡。
- 对白简短、清晰,并且获准使用。
- 面部动作细微,摄像机保持稳定。
- 音乐和字幕在动画制作完成后添加。
- 以前后导出文件在交付尺寸下进行比较。
- 帖子包含适当的合成媒体披露。
关键词
ai talking baby podcast generator, ai avatar video generator, animate image to video, motion mimic, ai video enhancer, enhance videos with ai, ai video tools
结论:发布 — 本文介绍了独特的虚构角色播客工作流,并提供了实用的安全、同步和验证指导。