脚本转视频 AI:在不复制角色的情况下直接呈现人群场景
当 AI 模型必须在一次生成中设计每个人、每个动作和每个镜头决策时,人群场景往往容易失败。本教程将展示如何把人群场景脚本转换为分层故事板图层、受控运动片段和可合成镜头,同时避免复制主角。
文章目录
分层构建人群,而不是依赖一个提示词
指导 AI 人群场景的可靠方法,是将主角表演、重点背景动作和无特定身份的人群运动拆分为不同的视觉图层。一个提示词若要同时生成二十个可辨认的人物、协调的走位、对白和移动镜头,就会让模型一次性面对过多的连续性决策。
本教程使用一个虚构的铁路站台片段:Mara 是一名身穿芥末黄色雨衣的快递员,她穿过晚高峰通勤人群,同时寻找一个撑着红伞的男人。这种方法适用于集会、派对、车站大厅、学校礼堂、市场,以及其他需要让一个重要角色在繁忙画面中保持清晰的场景。
核心规则:先锁定主角,再确定地点,只有当镜头在没有人群时仍然易于理解后,才增加人群密度。
封面复现提示词:写实照片级电影感编辑摄影,一名身穿芥末黄色雨衣的女性,在雨水浸暗的铁路站台上逆着晚间通勤人流前进,人群中远处可见一把红伞,实用型车站照明,可信的服装多样性,自然的人体间距,背景行人带有轻微运动模糊而主角保持清晰,无文字、标志、界面元素或品牌标记,横向 16:9。
步骤 1——明确镜头必须识别谁
在使用 script to video 工作流之前,将演员分为三个层级。这样可以避免无特征的群众演员与主角争夺注意力。
- 主角:面部、服装和动作必须保持一致的人物。
- 重点群众演员:通过一个鲜明的视觉信号被识别、且与故事相关的人物,例如一把红伞。
- 氛围人群:用于提供规模感和运动感,不需要持续保持固定身份的人。
只为主角,以及那些会在多个镜头中清晰出现的重点群众演员制作参考表。不要为每一名通勤者创建详细身份。你分配给人群的命名视觉属性越多,生成时发生角色融合的机会就越大。
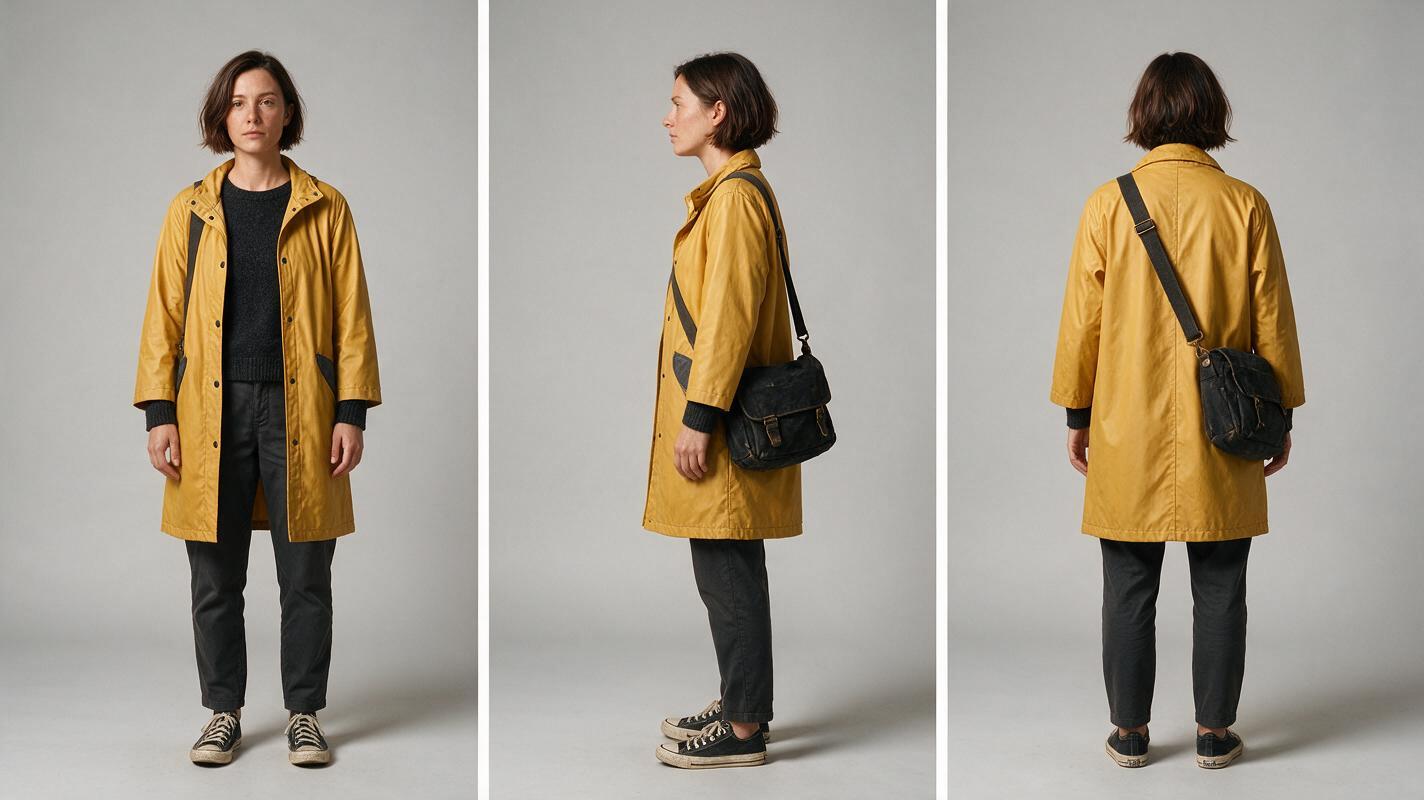
角色参考——MARA
30 岁出头的女性,椭圆脸,短款深棕色波波头,头发别在左耳后,棕色眼睛,芥末黄色及膝雨衣,炭灰色毛衣,深色长裤,旧黑色皮质邮差包从右肩斜跨至左胯。

每个视角都必须保持:脸部比例、发型、雨衣颜色和长度、包的形状及肩带方向。

排除:雨伞、帽子、珠宝、重复人物、不同款式的外套、文字、标志。视觉复现提示词:照片级写实的三联角色参考表,展示同一名女性的正面、严格左侧面和背面视图,短款深棕色波波头,芥末黄色及膝雨衣,炭灰色毛衣,深色长裤,旧黑色邮差包从右肩斜跨至左胯,三个面板中的服装和比例完全一致,中性站姿和表情,中性浅灰色无缝摄影棚背景,均匀柔光,全身可见,强制镜头:视平线高度、类似正交投影的参考视图,最大限度减少透视变形,强制布局:横向 16:9 画幅中的三个等宽竖直面板,无文字、标签、标志、UI 或其他人物。
步骤 2——将场景转换为走位图
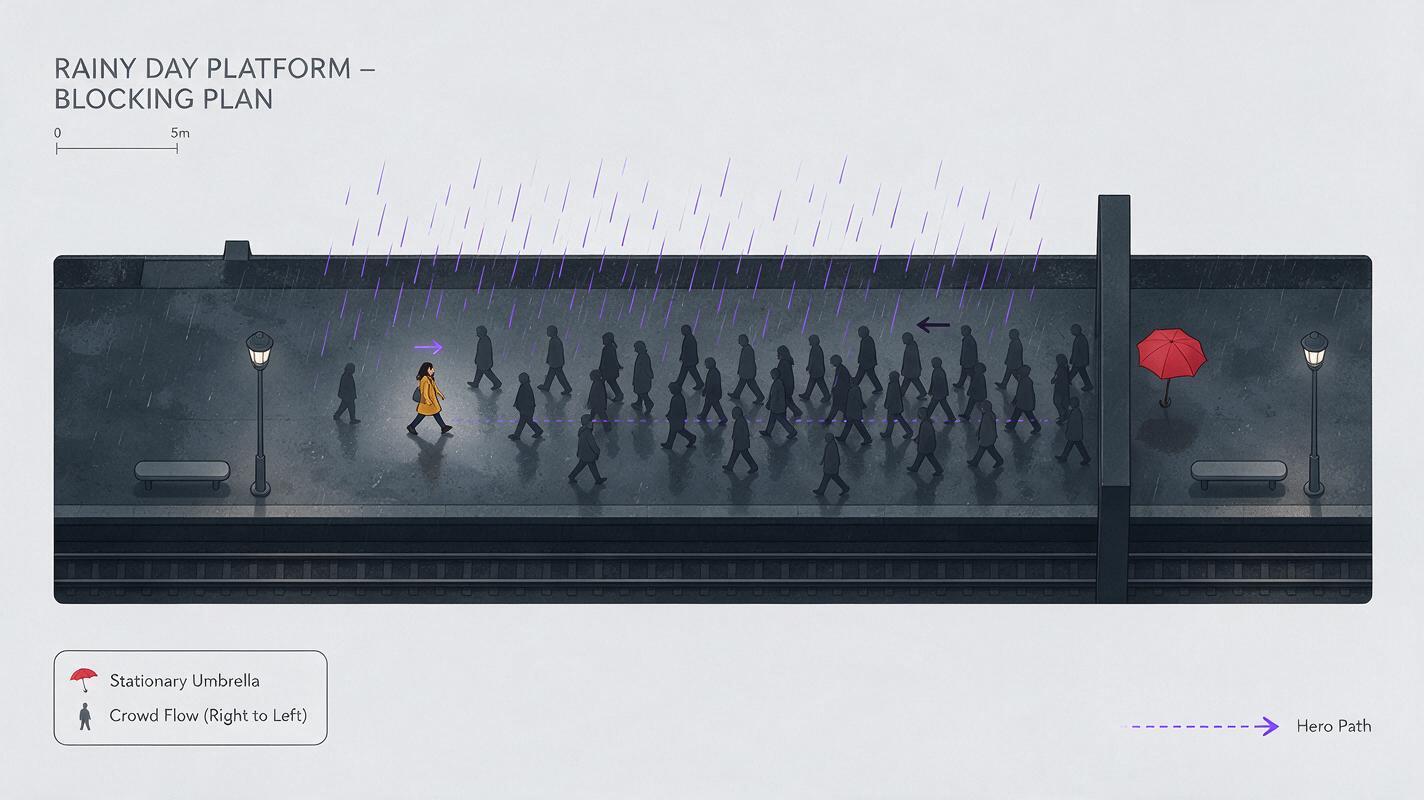
在生成精修画面之前,先将剧本段落转换为运动路线。一张实用的走位图需要回答四个问题:主角从哪里进入?人群朝哪个方向流动?重点群众演员在哪里出现?主角在哪里停下或改变方向?
对于铁路场景,让 Mara 从左向右移动,让主要人群从右向左流动,并将撑伞者安排在站台柱子旁的固定位置。这种相向运动能让 Mara 保持可见,而不需要每个群众演员都执行独特动作。
| 图层 | 画面方向 | 故事作用 | 连续性锁定项 |
|---|---|---|---|
| Mara | 从左向右 | 寻找并前进 | 雨衣、包、面部 |
| 主要人群 | 从右向左 | 制造阻力 | 总体密度即可 |
| 红伞 | 基本静止 | 提供目标 | 颜色和位置 |
| 前景路人 | 横穿镜头 | 为隐藏剪辑提供动机 | 轮廓,而非身份 |
使用 ai storyboard 通过静帧测试这种空间关系。如果观众无法在静态画面中识别 Mara 和红伞,增加运动也无法修复构图。
视觉复现提示词:电影感俯视走位可视化,雨水浸暗的铁路站台,搭建成逼真的微缩电影布景,一名身穿芥末色外套的女性从左向右移动,数名普通通勤者从右向左流动,一把红伞在结构柱旁保持静止,行进路线清晰开放,间距自然,强制镜头:真正的 90 度正上方俯视,强制布局:宽幅横向 16:9 构图,主角路线穿过人群流向,无箭头、标签、文字、标志、UI 或品牌标记。
步骤 3——设计能够隐藏人群不稳定性的镜头覆盖
人群场景不必由一个连续的大全景组成。通过镜头覆盖来构建场景,让每次生成只承担有限的任务:
- 建立镜头素材:用简短的宽幅视图确定站台规模和人群方向。
- 主角中景:Mara 向前挤行,只有部分通勤者穿过前景。
- 目标插入镜头:红伞出现在肩膀之间,或柱子旁边。
- 反应特写:Mara 认出目标,背景变得柔和且不具特征。
- 离场镜头:一名路人短暂填满画面时,Mara 改变方向。
前景遮挡尤其有用。一件贴近镜头掠过的深色外套,可以遮住两个独立生成片段之间的剪辑。这样,剪辑看起来是由人群推动的,而不是技术修正造成的。
故事板画面提示词
Mara 穿着芥末色雨衣,在朝相反方向移动的晚间通勤者中从左向右挤行。胸口高度的中景。Mara 是唯一面部完全清晰可读的人物。两名前景行人被画面边缘裁切,并带有柔和的运动模糊。一把合拢的红伞在远处背景中、柱子旁边若隐若现。潮湿的站台,实用型荧光车站灯光,克制的电影感写实风格。

强制镜头:胸口高度的中景跟拍构图,等效 50mm 镜头。
强制布局:Mara 位于左侧三分之一处,右侧留有开放的行进空间。
避免:重复的 Mara、重复面孔、身体融合、人群看向镜头、可读标牌、标志、文字。
步骤 4——在添加运动前生成干净素材
针对每个重要镜头角度,生成一张干净的场景素材、一张以主角为核心的画面,以及一张人群素材。保持镜头高度、镜头观感、光线方向和建筑标志的一致。干净的场景素材可以作为恢复素材:如果后续生成中出现不需要的人物或变形的前景物体,就能用它进行修复。
用受控的分组来生成适度人群密度,而不是要求“巨大的人群”。有用的描述包括“中景距离的六名通勤者”“镜头附近两道被裁切的轮廓”或“留有明显间隙的松散队列”。明确的间距可以减少身体意外融合,也让画面更容易进行合成。
在第一次渲染时,免费试用这些模型,比较哪种输出最能保留锁定的主角、地点空间关系和人群间距,然后再决定是否用于全部镜头。
素材规则:保存最简单且成功的画面。克制的人群素材比包含连续性错误但视觉效果惊艳的画面更易复用。
步骤 5——一次只制作一个运动图层
使用 image to video,从已批准的故事板画面出发,而不是仅凭文字重新生成每个镜头。为每个片段分配一条主要运动指令。
- 对于主角镜头:Mara 向前行进,镜头在她身旁跟拍。
- 对于人群素材:通勤者以不同步行速度向相反方向缓慢移动。
- 对于插入镜头:列车驶过站台时,红伞随风轻微倾斜。
- 对于反应镜头:Mara 停下,视线越过镜头聚焦,并有控制地呼吸一次。
如果表演时机很重要,motion transfer AI video 可以帮助定义具体的转身、停步或肩部动作。保持源表演简单并与画面匹配。包含快速旋转、交叉四肢或多个互动表演者的参考素材,可能会引入更多歧义,而不是减少歧义。
运动提示词——主角镜头
保持 Mara 的身份、芥末色雨衣、邮差包、身体比例和画面位置不变。她从左向右稳定行走,同时将视线转向远处的红伞,但身体不要完全转过去。镜头在她身旁平稳跟拍。背景通勤者以克制、自然的动作从右向左移动。

运动优先级:Mara 的行走和视线变化。
镜头:平滑横向跟拍,不缩放,不环绕。
保持固定:面部结构、外套设计、包带、车站建筑。
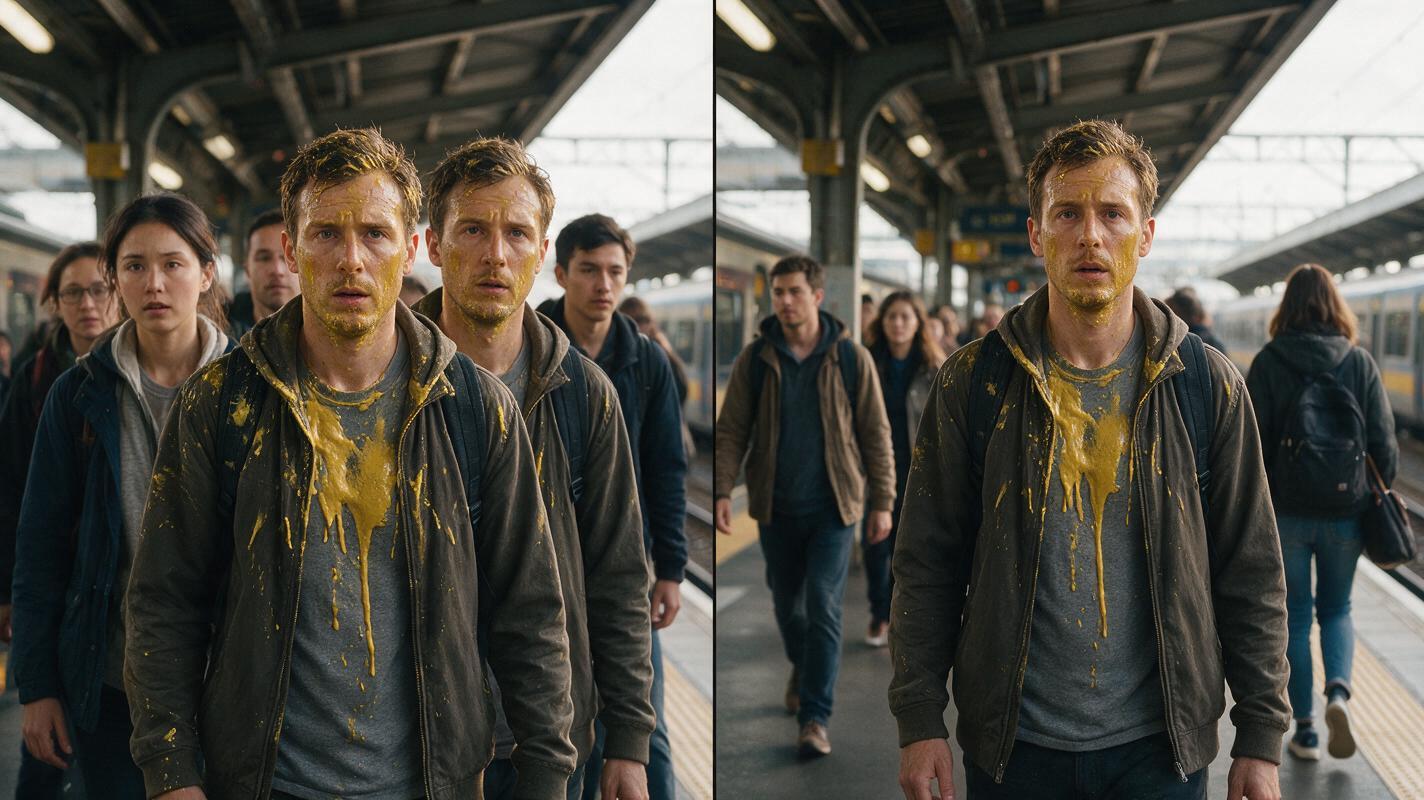
避免:重复主角、面部替换、人群碰撞、额外肢体、镜头突然加速。视觉复现提示词:同一铁路站台上的照片级写实电影感失败与修正并排对比,左半部分显示两名意外重复的身穿芥末色外套的主角,以及数名肩部融合的通勤者;右半部分显示一名清晰保留的主角,以及间距自然、彼此分开的行人;两半使用匹配的光线和镜头角度,强制镜头:视平线高度的中广角视图,等效 50mm 镜头,强制布局:横向 16:9 等分左右屏对比,无字幕、文字、标志、UI、分隔标签或品牌标记。
步骤 6——合成、剪辑,并按身份进行检查
根据最干净的图层组装片段,不要只因为运动效果戏剧性强就选择某个片段。一种实用的剪辑可以先以宽幅人群素材开场,切到 Mara 的中景跟拍镜头,插入红伞,回到她的反应镜头,最后利用一件前景外套遮住转场。
使用人群声音连接不同片段。脚步声、远处广播、行李滚轮声、雨声和列车刹车声,可以让独立生成的镜头像处于同一个连续环境中。让重要对白或呼吸声与环境音保持清晰区分。
以三种不同目的检查最终场景:
- 身份检查:只观察 Mara 的面部、头发、外套和包。
- 空间关系检查:检查画面方向、柱子位置和红伞的位置。
- 瑕疵检查:检查画面边缘、前景手部、融合的肩膀、重复面孔和人群突然消失的问题。
替换失败镜头,而不是修复整个片段。由于镜头覆盖采用分层设计,一个不稳定的人群片段不应迫使你重新制作主角表演。
最终检查清单
- 主角拥有一张锁定服装细节的三视图参考表。
- 重点群众演员通过一个明确无误的视觉信号进行定义。
- 主角运动和人群流动使用不同的画面方向。
- 每个镜头都有一条主要运动指令。
- 宽幅镜头建立规模感;近景镜头保护角色身份。
- 前景路人为隐藏剪辑提供有动机的位置。
- 已保存干净的场景素材和人群素材,以便恢复。
- 完成的剪辑通过身份、空间关系和瑕疵检查。
常见问题
为什么 AI 人群有时会复制主角?
模型可能将重复出现的服装或面部描述理解为把同一身份分配给多个人物的指令。只定义一次主角,对背景人物进行泛化描述,并避免让群众演员使用主角的独特颜色或配饰。
第一版故事板中应该出现多少人?
使用传达规模和流动所需的最少人数。先从彼此清晰分开的中景人物开始,确认构图后,再仅在场景需要的地方增加前景或远景密度。
每个群众成员都应该有参考图吗?
不需要。参考表最适合主角和反复出现的重点群众演员。无名群众成员应当在视觉上保持多样,但在叙事上不具备具体身份。
一个生成片段能处理整个人群场景吗?
可以,但单个长片段会给身份、运动、走位和镜头错误更多累积时间。基于镜头覆盖的短片段更容易指导、替换,也更容易在剪辑中隐藏问题。
人群中的主角最安全的镜头运动是什么?
克制的横向跟拍或缓慢推进通常比快速环绕更容易控制。无论选择哪种运动,都要让相邻镜头中的主角方向和地点主要标志保持一致。
来源
关键词
script to video AI,AI 故事板生成器,根据脚本创建 AI 视频,指导 AI 短片,motion transfer AI video,AI 电影制作器,AI 片段制作器