PixVerse 课程虚拟形象:修复唇形同步和僵硬动作
课程虚拟形象可以节省录制时间,但不匹配的嘴部动作、僵硬的表情和过度的头部运动很快会分散学习者的注意力。本指南将介绍如何准备清晰的人像,使用 PixVerse 创建克制的动作,同步短段旁白,并检查最终效果的清晰度和可访问性。
文章目录
创建一个说话时不会分散学习者注意力的课程虚拟形象
说话的课程虚拟形象应该将注意力引向课程内容,而不是飘忽的嘴唇、机械的眨眼,或不停转动的头部。最可靠的方法是将任务拆分为两个可控环节:使用 PixVerse 创建克制的基础表演,然后同步短小且节奏合理的旁白片段。与让一次生成同时自行设计面部、动作、语音和镜头行为相比,这种方式能让课程创作者获得更多控制权。
这种方法适用于课程欢迎语、模块过渡、培训提醒、词汇演示和简短的回顾片段。它最适合用于虚构的引导者、获得授权的演讲者,或明确披露身份的数字角色。
为什么课程虚拟形象的唇形同步看起来不对
唇形同步错误并不总是由同步工具造成的。问题往往始于人像、动画或旁白。每个输入中的小问题叠加起来,就可能形成明显不自然的表演。
- 嘴巴太小:距离较远的脸部会让系统缺少足够的可见像素,难以呈现清晰的发音动作。
- 基础片段中的嘴唇已经在动:随机的嘴部动作会干扰同步后的表演。
- 旁白语速太快:信息密集的句子、缩略词和突然的停顿会造成难以处理的时间过渡。
- 头部转开:侧脸或四分之三侧脸会遮挡重要的嘴形。
- 片段太长:细小的时间误差可能逐渐累积,并在片段末尾变得更加明显。
- 表情与课程内容冲突:在安全、合规或评估说明中,持续微笑可能显得不合适。
对于教育视频而言,可信的克制通常比戏剧化的表演更有用。学习者必须能够听清信息、阅读字幕,并理解演讲者,而不会受到视觉干扰。
准备有助于清晰发音的人像
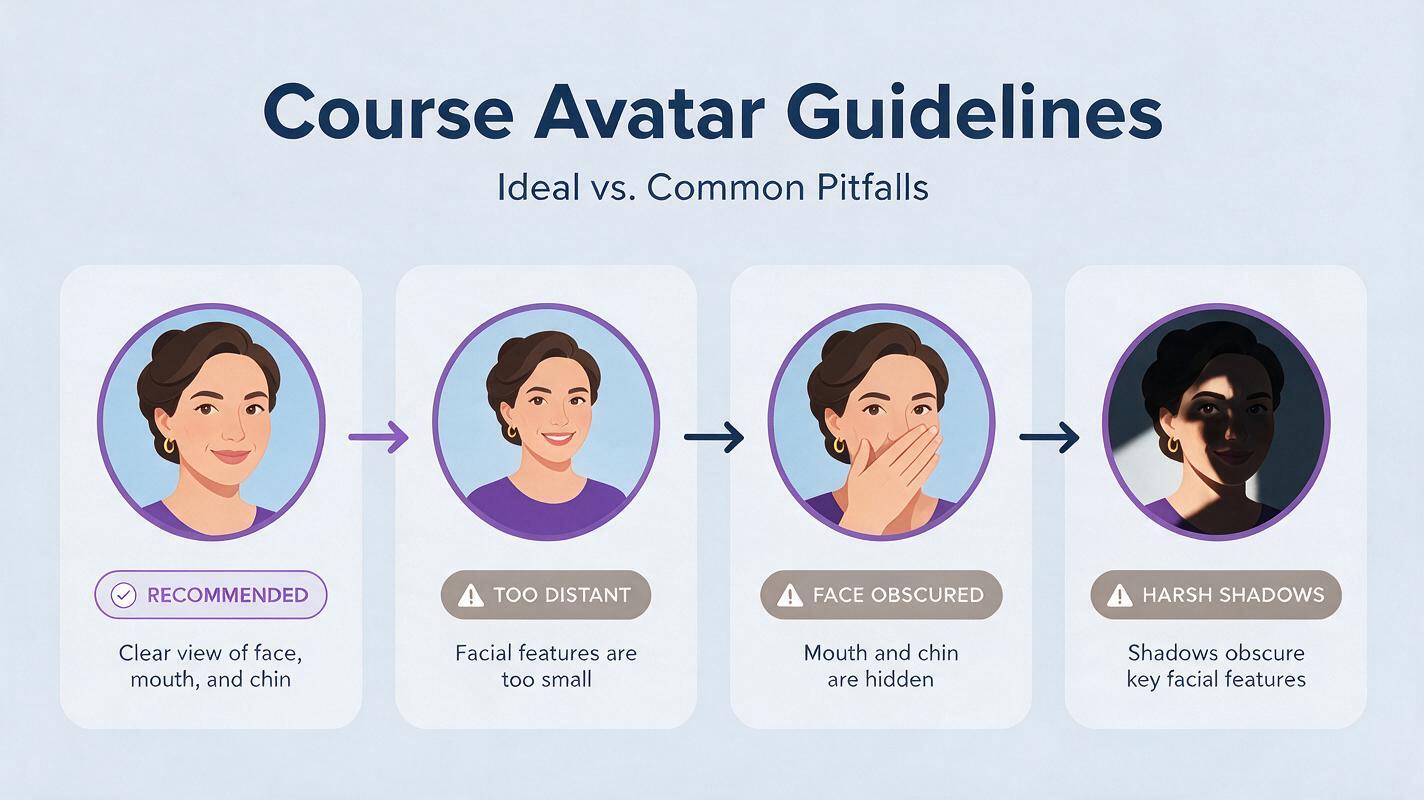
从正面或略带四分之三角度的人像开始。确保整个嘴部清晰可见,在下巴周围留出空间,并避免手、麦克风、围巾或头发遮挡嘴唇。中近景通常能在清晰的面部动作与字幕空间之间取得良好平衡。
表情应当专注且积极自然。避免在源图像中使用张大嘴的笑容,因为这会减少动画形成闭口音的空间。使用柔和的正面光线,让唇部轮廓保持清晰,同时避免产生生硬的阴影。
如果需要生成演讲者人像,请具体说明构图和教学场景,而不是只要求生成一个普通虚拟形象:
创建一名虚构的成年课程引导者,采用中近景构图,面向镜头,表情平静而专注,嘴唇自然闭合,双眼清晰可见,肩膀放松,穿着简洁的藏青色教学服装,柔和的正面影棚灯光,干净的暖灰色背景,真实的面部比例,嘴部和下巴无遮挡,肩膀下方为字幕留出空间,16:9 构图。不要包含文字、徽标、麦克风、靠近脸部的手或夸张的情绪。在预期的显示尺寸下检查人像。如果嘴部在移动端预览中变得模糊不清,请在创建任何动作之前先进行更近的裁剪。
使用 PixVerse 生成克制的基础表演
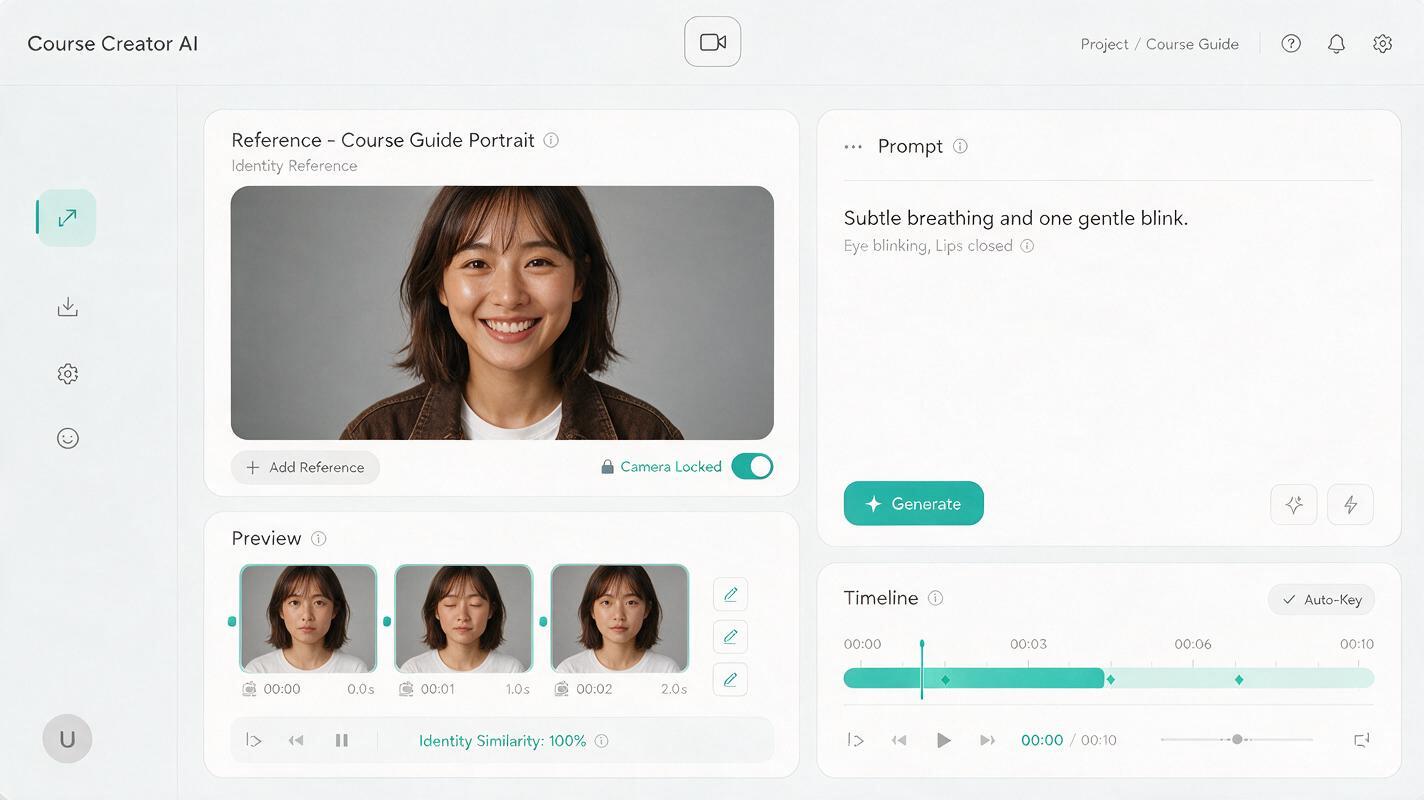
使用 PixVerse 的图像转视频功能,并将人像作为视觉参考。在这一阶段,目标不是让角色说话,而是生成安静的聆听姿态,包括细微的呼吸、偶尔自然的眨眼和极少的头部运动。保持嘴唇闭合或基本不动,可以为后续同步处理提供更干净的基础。
课程引导者始终直视镜头。细微而自然的呼吸,轻轻眨眼一次,非常小幅度的姿势调整,保持沉稳专业的状态。头部基本保持居中,嘴唇保持闭合。固定镜头,不缩放,不改变场景,不做手势,不出现戏剧化表情,不做说话动作。先生成一个较短的片段。舍弃出现面部变形、视线游移、连续眨眼、肩部扭曲、镜头漂移或自发嘴部动作的结果。与在添加语音后再修复这些问题相比,重新生成一个质量不佳的基础片段更快。
改写旁白,让说话动作清晰且便于教学
书面课程介绍看起来可能很简洁,但同步起来仍然很困难。按照自然的语义边界拆分长句,将标点密集的表达改为口语化语言。按照学习者应当听到的方式读出缩写,并提前确定数字、符号和专业术语的读法。
| 较难同步的表达 | 更适合口头表达的版本 | 原因 |
|---|---|---|
| “完成 A 到 C 部分,然后提交 Q4。” | “完成 A 到 C 部分。然后提交第四题。” | 消除含义不明确的符号,并加入清晰的停顿。 |
| “PPE 必须在使用前检查。” | “使用前请检查个人防护装备。” | 展开缩略词,并改善节奏。 |
| “在本模块中,我们将分析、比较、评估并应用……” | “在本模块中,我们将比较两种方法。然后应用更安全的方法。” | 减少列表密度,并明确学习行动。 |
一个实用的片段应包含一个教学要点和一个自然停顿。尽可能分别录制或生成每个片段。这样也更容易在句子发生变化时替换单个片段,而不必重建整个介绍。
分段同步语音
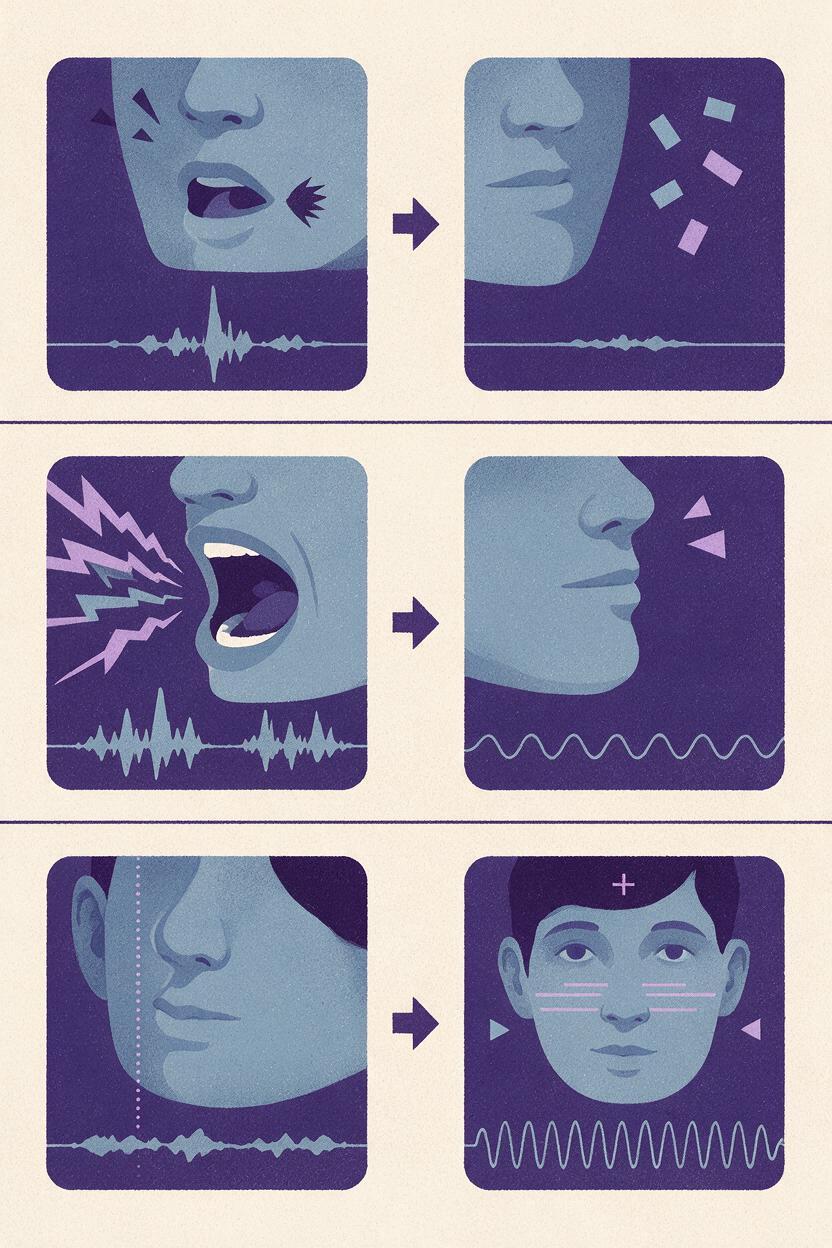
一次只对一个简短的旁白片段应用 ai lipsync。使用没有背景音乐、房间回声或音效的干净音频。在口述句子前后各留出一小段安静的余量,让嘴部能够自然开始动作并恢复静止。
先关闭声音观看第一版结果。嘴部动作应该有明确目的,而不是持续活动。然后只听音频、不看画面,确认节奏仍然易于跟上。最后以正常速度并在小屏幕上同时检查画面和声音。
不要认为更强烈的面部动作一定能提升真实感。如果嘴形准确但结果仍然不自然,请先减少头部动作和表情强度,再调整声音。稳定的上半脸通常能让同步后的嘴部动作看起来更可信。
重新生成前先诊断问题
| 可见问题 | 可能原因 | 针对性修正 |
|---|---|---|
| 语音开始前嘴部就动了 | 开头的静音不足,或基础片段中已有嘴部动作 | 在音频开头增加一小段引入静音,或重新生成嘴唇闭合的基础片段。 |
| 说话内容出现延迟 | 音频包含延迟起音、回声或较长的呼吸声 | 在再次同步前裁剪并清理音频。 |
| 下巴动作过大 | 语速太快,或表情强度过高 | 略微放慢旁白,并使用更平静的源表情。 |
| 说话过程中面部发生变化 | 头部动作幅度过大,或基础生成不稳定 | 回到固定镜头、正面朝向的基础片段。 |
| 眨眼看起来很机械 | 要求的微动作过多 | 删除眨眼指令,或只要求一次细微的眨眼。 |
| 同步在片段末尾变差 | 片段太长 | 在句子边界处分割旁白,并分别渲染片段。 |
每次测试只改变一个变量。例如,在测试较慢的旁白时,保持人像和基础片段不变。如果同时更改图像、动画、音频和同步设置,就无法判断究竟是哪项修正确实有效。
将虚拟形象整合到实用的学习内容中
让虚拟形象保持简短且目标明确。课程引导者可以欢迎学习者、介绍学习目标、说明导航方式、提出思考问题,或总结下一步行动。当图表、演示、原始视频素材或教师讲解能更直接地传授概念时,不应让虚拟形象取代这些形式。
- 添加经过编辑的字幕,不要直接依赖未经审核的自动文本。
- 将字幕放在远离嘴部和重要屏幕控件的位置。
- 手动检查专业术语、姓名、单位和缩略词。
- 让背景音乐低于旁白音量;对于信息密集的说明,也可以省略背景音乐。
- 在学习场景适合披露时,标明演讲者为合成角色。
- 使用真实人物的脸部或声音前,先取得许可。
在组装完整介绍之前,分别导出每个已批准的片段。这样可以保留可替换的单元,便于未来更新课程。当你准备好比较克制的基础动画与同步语音时,可以亲自测试这个提示词。
最终检查清单
- 演讲者是虚构角色、获得授权的人员,或已按照要求披露身份。
- 嘴部和下巴无遮挡,且尺寸足够大,便于检查。
- PixVerse 基础片段中的头部和嘴唇动作极少。
- 每个旁白片段都传达一个清晰的教学要点。
- 音频开头和结尾都留有一小段干净的余量。
- 已在开启和关闭声音的情况下检查唇形时序。
- 字幕已针对术语和可读性完成编辑。
- 虚拟形象是在支持课程,而不是取代更好的视觉讲解。
关键词
PixVerse 课程虚拟形象,AI 唇形同步,说话的课程虚拟形象,课程介绍视频,培训视频虚拟形象,图像转视频,学习内容