如何在一个 AI 视频场景中保持两个角色的一致性
在一个 AI 视频中保持两个角色一致性的最可靠方法,是在同一张参考图中设计他们,锁定各自的位置和识别特征,然后以克制的动作让这张图动起来。本教程将展示如何构建参考图、编写能够区分角色的提示词、比较不同视频模型,以及使用 MagicBoat 修复身份漂移问题。
文章目录
简而言之:从包含两个角色的单帧画面开始
要可靠地保持两个角色的一致性,请创建一张干净的参考图,让两个人已经拥有清晰不同的面部、服装、位置和轮廓。然后使用低复杂度动作、稳定的摄像机,以及为每个角色分别指定一个动作的提示词,将该画面转换为ai video。
不要要求纯文本视频提示词同时凭空创造两个详细身份和复杂的舞蹈编排。将角色设计与动画分开,可以减少模型在每一帧中需要做出的决策。
为什么两个角色的一致性会崩溃
视频模型不会把“Mara”和“Jon”这样的名字视为永久的身份记录。它会综合解读当前画面、提示词、动作和视觉上下文。当两个人拥有相似特征或彼此交错时,模型可能会在他们之间重新分配这些特征。
常见问题包括:
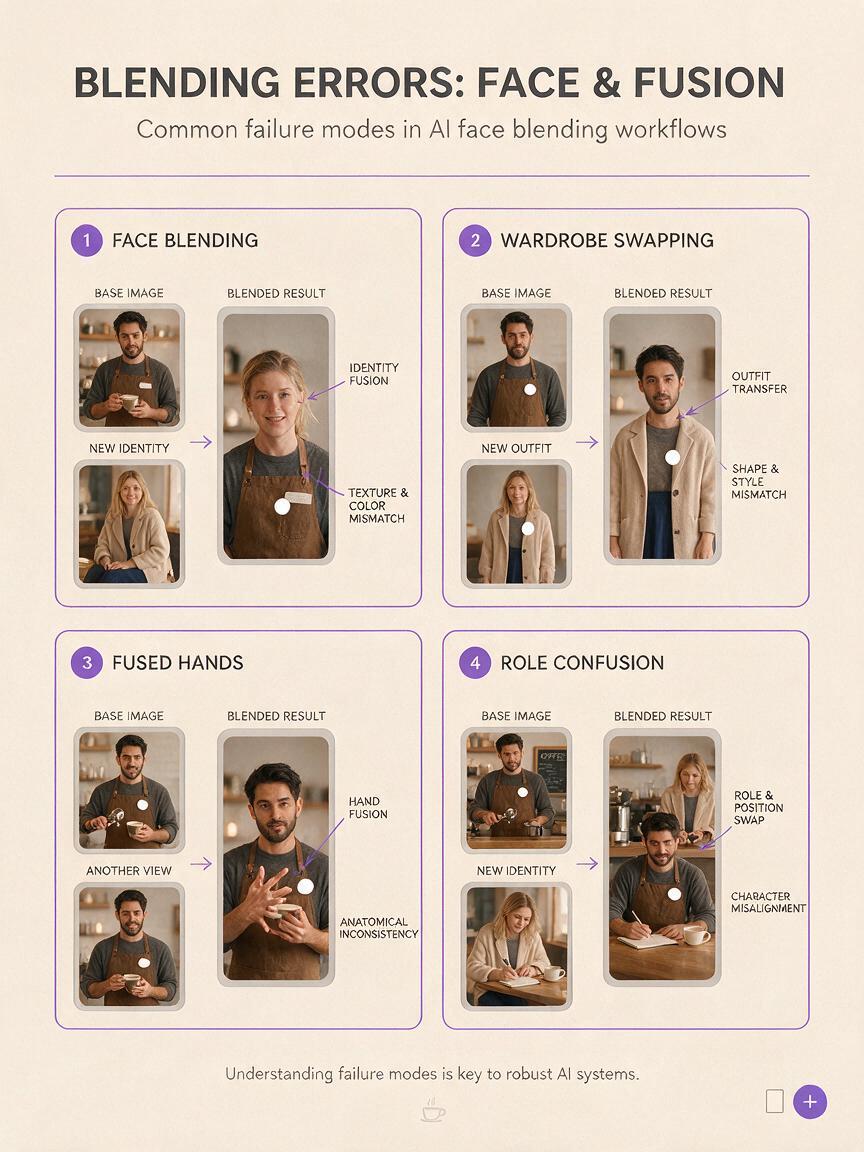
- 面部融合:一个角色逐渐获得另一个角色的眼睛、发型或脸型。
- 服装互换:经过剪切、转身或遮挡后,红色夹克从左侧角色移动到了右侧角色身上。
- 身体融合:当角色站得太近时,肩膀、手或手臂会融合在一起。
- 角色混淆:由于提示词使用了含糊的代词,错误的人执行了某个动作。
- 风格漂移:一个角色变得比另一个更写实、更像插画、更年轻或更年长。
- 连续性丢失:当摄像机移动到物体后方,或显示出侧面视角时,角色的外观发生变化。
核心规则很简单:在要求动作之前,先让身份在视觉上变得一目了然。服装颜色、位置、轮廓、年龄、发型和配饰都应帮助区分角色。
创建双角色场景的 3 种方式
| 方式 | 最适合的用途 | 主要风险 |
|---|---|---|
| 文本生成视频 | 快速概念测试和远景角色 | 模型必须同时创造两个身份和整个场景 |
| 单张参考图生成视频 | 对话、反应、产品场景和受控调度 | 大幅度动作仍可能改变面部或服装 |
| 独立角色素材加合成 | 重复出现的角色和精确的制作工作 | 需要更多准备和编辑 |
本教程重点介绍第二种方式,因为它在速度、视觉控制和可重复性之间提供了最佳平衡。独立素材方式将在后文作为高级替代方案介绍。
MagicBoat 如何处理多模型角色工作流
MagicBoat 将图像和视频生成模型整合到同一个账户中,因此你可以先使用图像模型制作静帧,再通过多个视频模型进行测试,而无需从头重建概念。根据当前可用情况,工作流可以使用 Seedream、Flux 或 GPT Image 等图像生成选项,以及 Seedance、Kling 或 Veo 等视频生成选项。
实际流程是:生成双角色关键帧,以原尺寸检查,然后将其传入image to video,比较当前可用模型如何解读同一个动作提示词。模型可用性和支持的控制项可能会变化,因此创建项目时请使用 MagicBoat 中显示的选项,而不要依赖固定的模型列表。
Runway 风格的工作流在这里可作为一种通用制作模式:建立一张强大的源图,制作一个短镜头,选出最佳结果,然后组装多个受控镜头,而不是期待一次较长的生成就完成整个场景。
生成前需要准备什么
- 对每个角色固定视觉特征的简短描述。
- 一个让角色之间有足够空间的简单地点。
- 每个角色一个动作。
- 预先规划好的摄像机角度和画幅比例。
- 让两个角色在同一镜头中始终可见的合理原因。
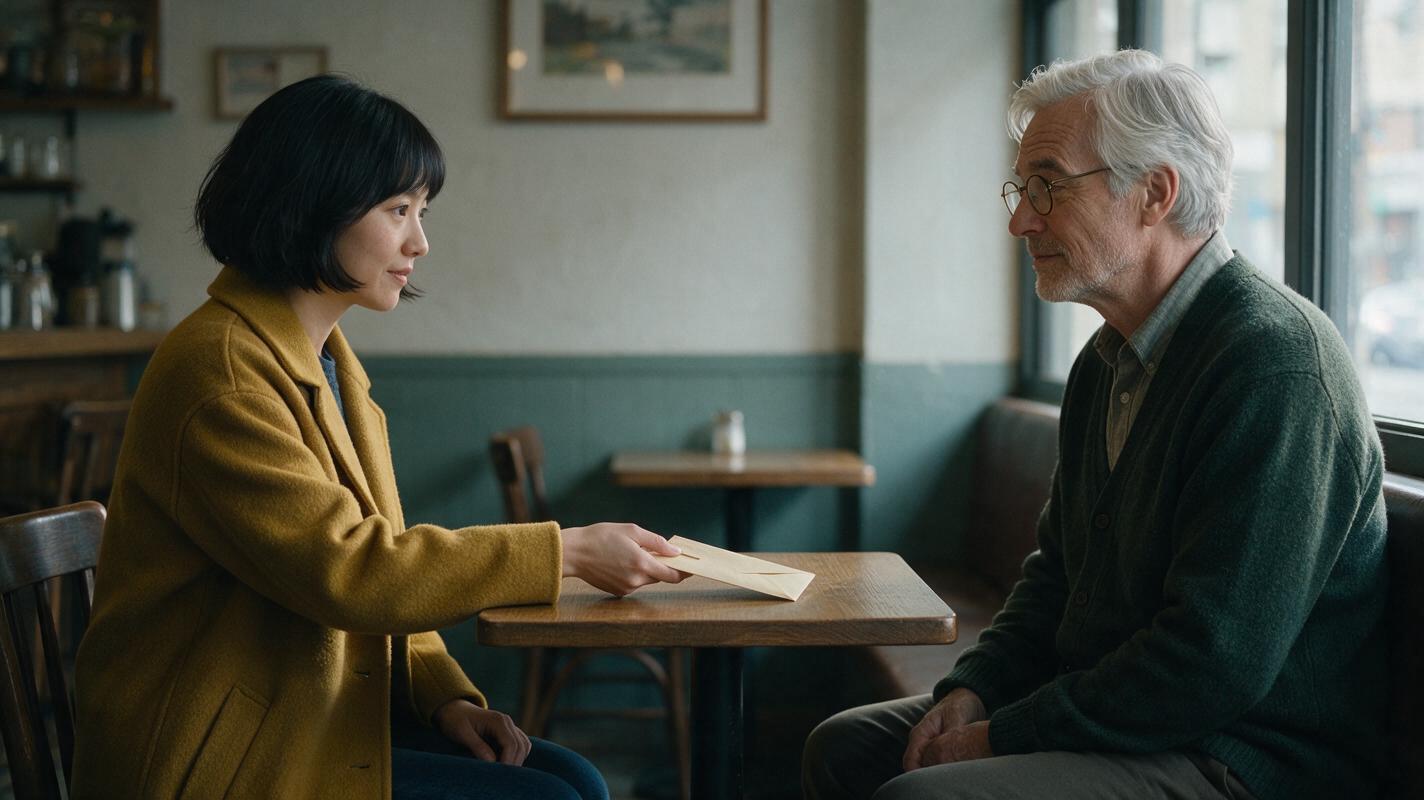
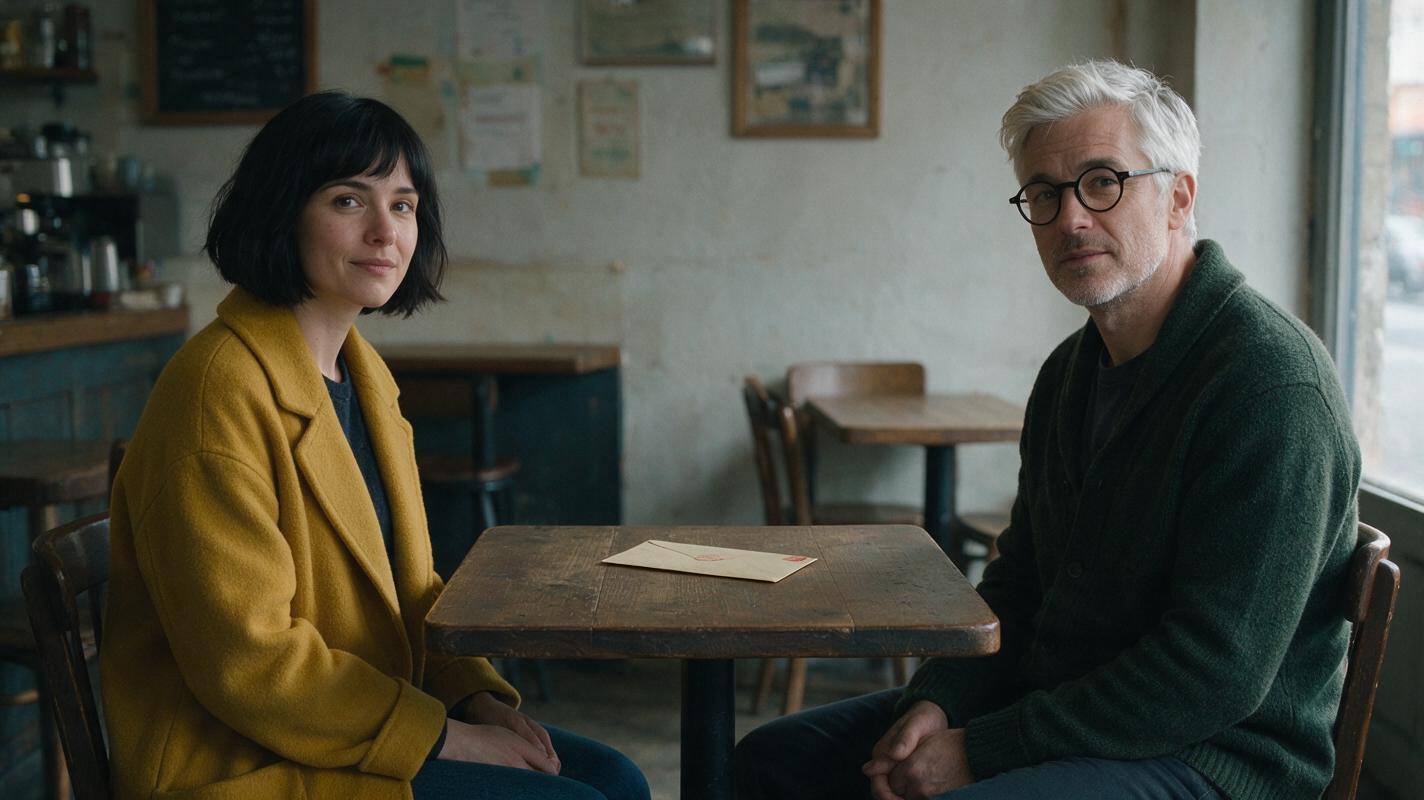
在下面的示例中,角色 A 是一位留着黑色短波波头、穿芥末色外套的女性。角色 B 是一位留着银发、戴圆框眼镜、穿深绿色开衫的男性。他们坐在一张小咖啡桌两侧,角色 A 将一个密封信封推向角色 B。
第 1 步——编写简洁的角色锁定描述
用三到五个可见特征定义每个身份。优先选择在中景中仍然清晰可辨的特征。细小的首饰、微妙的眼睛颜色和隐藏的纹身都是较弱的识别标记;轮廓、头发、外套和眼镜则是较强的识别标记。
角色 A
三十岁出头的女性,黑色直短波波头,
芥末黄色羊毛外套,窄脸,不戴眼镜。
始终位于画面左侧。

角色 B
四十多岁的男性,银色短发,
黑色圆框眼镜,深绿色开衫,宽脸。
始终位于画面右侧。
避免在角色锁定描述中加入过多性格、传记或不可见事实。“不信任权威的前侦探”或许能指导剧本,但无法稳定面部。稍后将性格转化为可见行为,例如防备的姿势或犹豫的手部动作。
预期结果:两段不容易彼此混淆的描述,即使面部尺寸较小也能区分。
第 2 步——创建锁定的参考图
使用可用的图像模型同时生成两个角色。相比极近特写,中景双人镜头更安全,因为它可以确立服装、身体位置、桌面几何结构和空间分隔。
安静的社区咖啡馆内的电影感中景双人镜头,
柔和阴天的清晨光线。画面左侧,一位三十岁出头、留着
黑色直短波波头、穿芥末黄色羊毛外套的女性端坐着。画面右侧,
一位四十多岁、留着银色短发、戴黑色圆框眼镜、
穿深绿色开衫的男性坐在她对面。一张小木制
咖啡桌将两人隔开。两人的面部都完全可见,彼此 distinct,
自然真实。统一的写实摄影风格,50mm 镜头,
中性表情,克制的色彩搭配,前景中没有其他人。
如果模型支持排除项或负面提示词,请添加简洁的限制条件,而不是列出很长的清单:
不要出现重复人物,不要面部融合,不要相同服装,
不要多余的手,不要身体重叠,不要文字。
生成多个候选结果,选择角色分隔最清晰的一张,而不只是光线最漂亮的一张。拒绝任何包含部分隐藏的手、重叠的肩膀、比例不一致或面部相似的画面。
预期结果:一张可用于制作的关键帧,观众可以立即识别两个角色。
第 3 步——动画生成前验证画面
以完整分辨率检查选中的图像。动画往往会放大小缺陷,因此静帧中变形的眼镜或多出的一根手指,在运动后可能会变得更加明显。
检查以下区域:
- 面部边界:发际线、耳朵、眼镜和下颌线应当清晰。
- 手部:如果计划中的动作会用到手,应让手部清晰可见且彼此分开。
- 服装:确认每种颜色和服装只属于一个角色。
- 空间深度:桌子和椅子的几何结构应当可信。
- 画面方向:角色 A 必须已经位于左侧,角色 B 位于右侧。
- 动作准备:如果信封会在镜头中移动,那么它应当已经出现在画面里。
如果重要道具缺失,请重新生成或编辑静帧,而不是要求视频模型在运动过程中创建它。新出现的物体经常会导致手部变形和连续性变化。
预期结果:一张只需要添加动作、而不需要进行结构修复的参考画面。
第 4 步——使用受控动作让参考图动起来
将参考图传入可用的视频模型。从短片段、固定或轻微移动的摄像机,以及一个明确分配的动作开始。第一次测试应当确认模型能否保护两个角色的身份。
画面左侧的女性用右手缓慢地将密封信封推过桌面。
画面右侧的男性保持坐姿,注视信封,并轻轻点头一次。
两个角色的面部特征、发型、服装、年龄和画面位置
均与参考图保持一致。自然且克制的动作。锁定的中景双人镜头。
不要切镜,不要身体交叉,不要出现新人物。
在初始描述之后,这个提示词使用具体名词和画面位置,而不是“她”和“他”。这种冗余是有意的,它会持续提醒模型每个动作属于谁。
对于 Seedance prompt 或 Kling prompt,也要保留相同结构:主体分配、动作、身份锁定、摄像机指令和排除项。不要假设相同措辞在不同模型中会产生完全相同的动作;比较输出结果,并保留最能维持参考图效果的版本。
预期结果:一次简单的互动,两个角色始终清晰可辨,信封在没有切镜的情况下移动。
第 5 步——只有在身份稳定后才添加摄像机运动
锁定镜头运行良好后,再测试一个包含单条轻微摄像机指令的版本。合适的选择包括缓慢推近、轻微横向移动或细微的手持呼吸感。第一次尝试时,避免同时加入环绕、快速变焦、甩镜和角色移动。
画面左侧的女性将密封信封推向画面右侧的男性。
他低头看信封,然后再看向她。
非常缓慢的电影感推近,在整个镜头中保持两人的面部可见。
保留他们完全一致的面部、头发、眼镜、服装、
身体比例以及左右位置。连续镜头,
不要切镜,不要遮挡,不要有背景人物穿过画面。
摄像机部分应同时描述运动方式和构图保护。“缓慢推近”单独使用时,可能会变成一个裁掉其中一名角色的特写。“保持两人的面部可见”则为摄像机运动提供了边界。
预期结果:在不牺牲双人镜头构图的情况下,让画面更具电影感。
第 6 步——生成针对性变体,而不是全部重写
如果结果已经接近目标,请保留角色描述区块,每次生成只改变一个变量。这样更容易诊断失败原因。
| 问题 | 可测试的修改 | 保持不变的内容 |
|---|---|---|
| 推近过程中面部发生漂移 | 恢复锁定摄像机,或减少摄像机运动 | 参考图和角色描述 |
| 手部在信封周围变形 | 缩短滑动距离,或从手已经接触信封的状态开始 | 面部、服装、构图、光线 |
| 角色互换动作 | 重复画面左侧和画面右侧的角色分配 | 摄像机和场景设计 |
| 一个角色消失 | 要求连续的中景双人镜头,并让两人的面部都可见 | 核心动作和身份 |
| 动作显得没有生命力 | 添加一个微反应,例如点头或瞥视 | 主要手部动作和摄像机 |
将成功的参考图和完整提示词一起保存。只有当图像、措辞、构图和动作设计保持为一个匹配的整体时,角色一致性才更容易复现。
预期结果:一组可比较的短片段,用于判断哪个模型和动作强度最能保护角色身份。
让同样的角色出现在不同项目中
为每个人创建一份可复用的角色表,其中包含正面中性视图、四分之三侧面、侧面、全身和特写。保持光线朴素,服装不变。这些图像可以指导未来的关键帧,不过不同模型对多张参考图的支持程度各不相同。
同时保存一份简短的连续性记录:
永久特征:脸型、年龄、发型、发色、眼镜、
身高关系、标志性外套。

场景特定:地点、情绪、道具、摄像机角度、光线。

不要同时改变:发型 + 服装 + 年龄。
仅在必要时改变:表情、姿势、背景。
对于较长的连续内容,为远景、中景和近景分别建立参考画面。试图将一张远景图转换为所有摄像机角度,可能会迫使视频模型凭空创造未展示的面部细节。
替代方案:使用动作迁移处理复杂表演
当场景依赖舞蹈、打斗或精确的身体节奏时,可以录制或获取一段干净的驱动表演,并在可用的情况下使用动作迁移。源表演可以提供比冗长文字描述更清晰的节奏。
让驱动素材中的两位表演者保持分离,避免四肢交叉,并使用轮廓对比明显的服装。动作迁移可以改善舞蹈编排,但不会自动解决身份漂移;高质量的角色源图仍然至关重要。
替代方案:使用换脸修复一个角色的身份
如果动作效果很好,但其中一个面部发生变化,换脸可以作为后期处理选项。使用角度和光线相近、清晰且经过授权的源图像。只有在选定最终动作片段后再进行处理,这样就不必在已经放弃的版本上重复修复。
在严重模糊、完全侧面、面部遮挡或快速转头时,面部替换的可靠性会降低。它也无法修复服装互换、身体融合或手部变形。只能使用你获准处理的图像和素材,并且不要以欺骗方式使用面部替换。
该工作流的局限
- 长时间遮挡仍然很难处理。如果一个人走到另一个人身后,模型可能会错误重建被遮挡的面部。
- 复杂的手部接触会提高失败率。握手、拥抱、摔跤和传递小物体会同时考验解剖结构和身份追踪。
- 侧面会暴露缺失的信息。正面参考图无法完整定义耳朵、鼻子的突出程度或发型后部。
- 长片段会累积漂移。多个受控的短镜头通常比一个包含大量动作的连续长场景更容易管理。
- 模型行为各不相同。相同的参考图和提示词,在不同模型中可能产生不同的面部稳定性、动作强度或摄像机解读。
- 名字不是身份锁定。重复虚构名字有助于提示词的可读性,但不能替代视觉参考。
常见问题
没有参考图,文本生成视频能保持两个角色的一致性吗?
简单或远景场景可以做到,尤其是当两个角色外观差异很大时。对于对话、特写或需要反复出现的身份,共享参考帧通常更容易控制,因为两人的外观及其空间关系已经预先确定。
我应该分别生成每个角色吗?
当你需要可复用的角色素材或精确合成时,可以分别生成。对于一个简短的共享场景,同时在同一关键帧中生成两个角色,通常能带来更协调的光线、比例、透视和视线关系。
两个角色之间应该相隔多远?
在他们的头部、肩膀和手之间留出可见的负空间。桌子、门口、过道或前景物体可以强化分隔,但要避免物体在运动过程中遮住面部。
角色名字能提高一致性吗?
名字有助于组织提示词,但视觉描述和画面位置发挥着更实际的作用。在分配动作时,请重复“画面左侧穿芥末色外套的女性”,而不要只依赖名字或代词。
我应该使用哪个模型?
使用 MagicBoat 中可用的视频模型,测试同一张源图和同一个提示词。根据实际镜头进行选择:某个模型可能更擅长保持面部,而另一个模型可能生成更自然的动作,或更准确地遵循摄像机指令。
我可以制作交替特写的对话吗?
可以,但应将其制作成独立镜头。先创建双人镜头参考图,然后为每位说话者分别创建专用特写参考图,同时保持相同的角色描述、服装、光线和环境。
创建你的双角色场景
先构建一张强大的参考图,首先制作最简单的动画版本,只有在两个身份保持稳定后再增加动作。免费创建你的第一个 AI 视频,并使用相同的参考图和提示词比较可用模型。
最终检查清单
- 为每个角色设置不同的轮廓、发型和服装颜色。
- 将两个角色放在同一张干净的参考图中。
- 使用画面左侧和画面右侧标签,而不是含糊的代词。
- 为每个角色分配一个主要动作。
- 从锁定摄像机和短片段开始。
- 只有在身份保持稳定后才添加摄像机运动。
- 测试不同变体时,每次只改变一个提示词变量。
- 只有在基础工作流需要针对性修复时,才使用动作迁移或换脸。
关键词
角色一致性,ai 视频教程,图像生成视频,seedance 提示词,kling 提示词,提示词工程,ai 视频工作流