如何使用图像生成视频创建稳定的 AI 人群场景
通过设计一个清晰易读的锚点画面、将人物划分到不同运动区域,并只为其添加短促且受控的动作,创建稳定的 AI 人群场景。这套图生视频工作流可以减少面孔融合、肢体重复、行人滑动,以及主要角色出现不必要变化等问题。
文章目录
简要总结:先构建人群,再为其添加动画
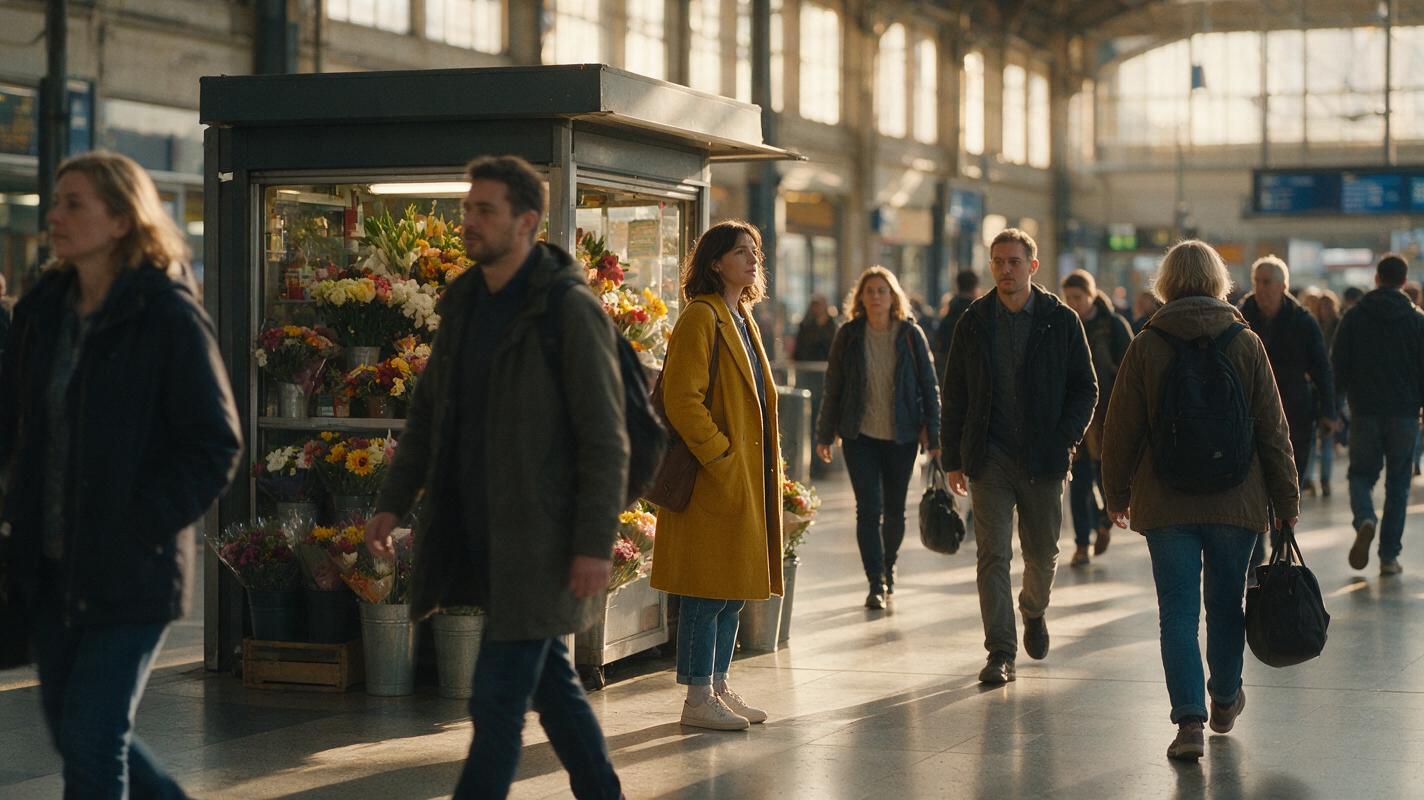
生成繁忙 AI 人群场景最可靠的方法,是先创建一张干净的锚点图像,将人物分为前景、中景和背景运动区域,然后以克制的动作让画面动起来。不要要求每个人都执行不同动作,而是使用 图像生成视频,设置一个主要动作、几个次要手势,以及背景中的环境运动。
让每次生成保持较短时长,逐帧检查面部和肢体,并在不稳定现象出现前及时切换镜头。如果场景需要更多活动,不要强行把整个序列放进一次生成中,而应创建多个受控镜头。
为什么人群场景在 AI 视频中容易出错
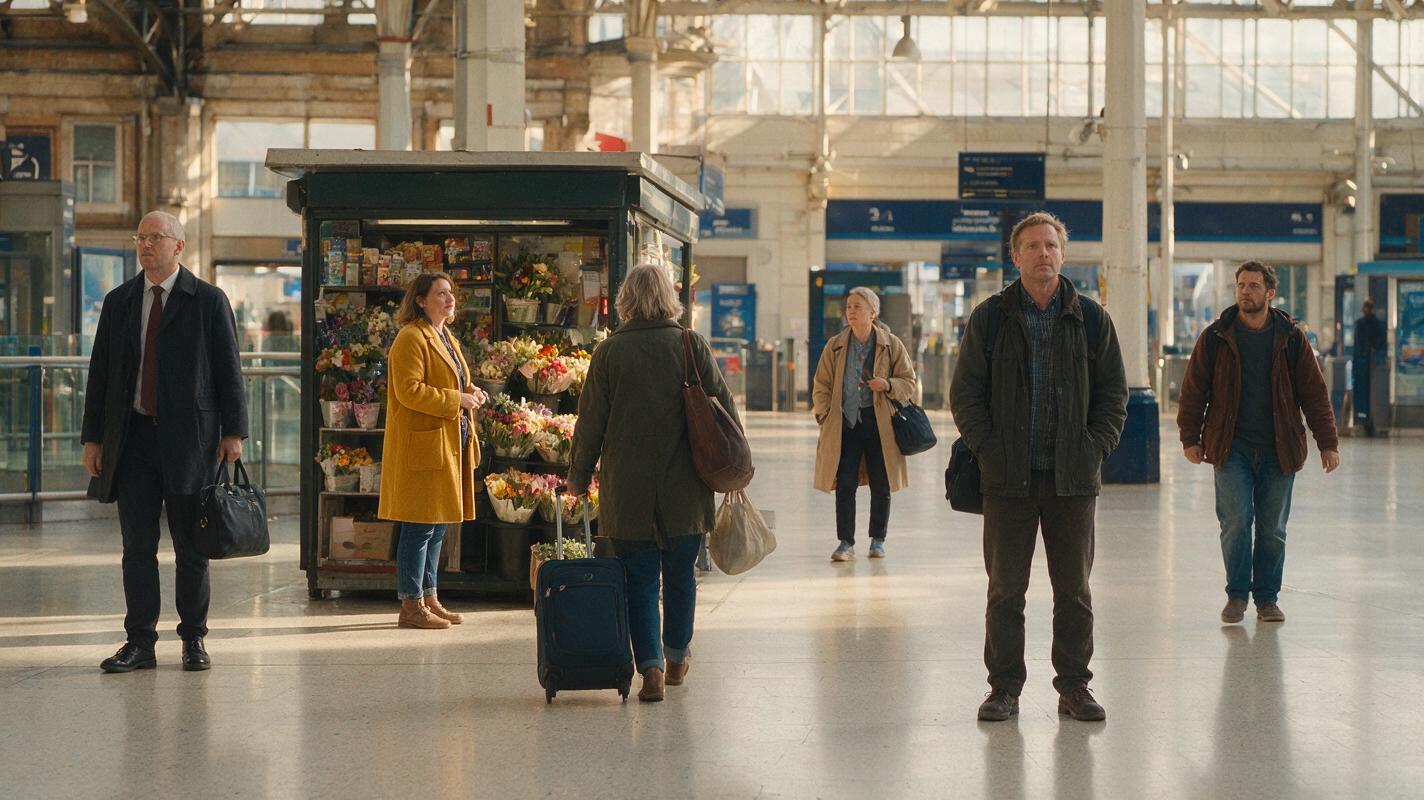
人群场景很难生成,因为模型必须在估算深度、遮挡、运动和摄影机透视的同时,保持许多部分可见的人体结构。诸如“一个充满行人、大家朝不同方向行走的热闹市场”这样的提示词听起来自然,但它留下了太多需要同时解决的决策。
常见问题包括:
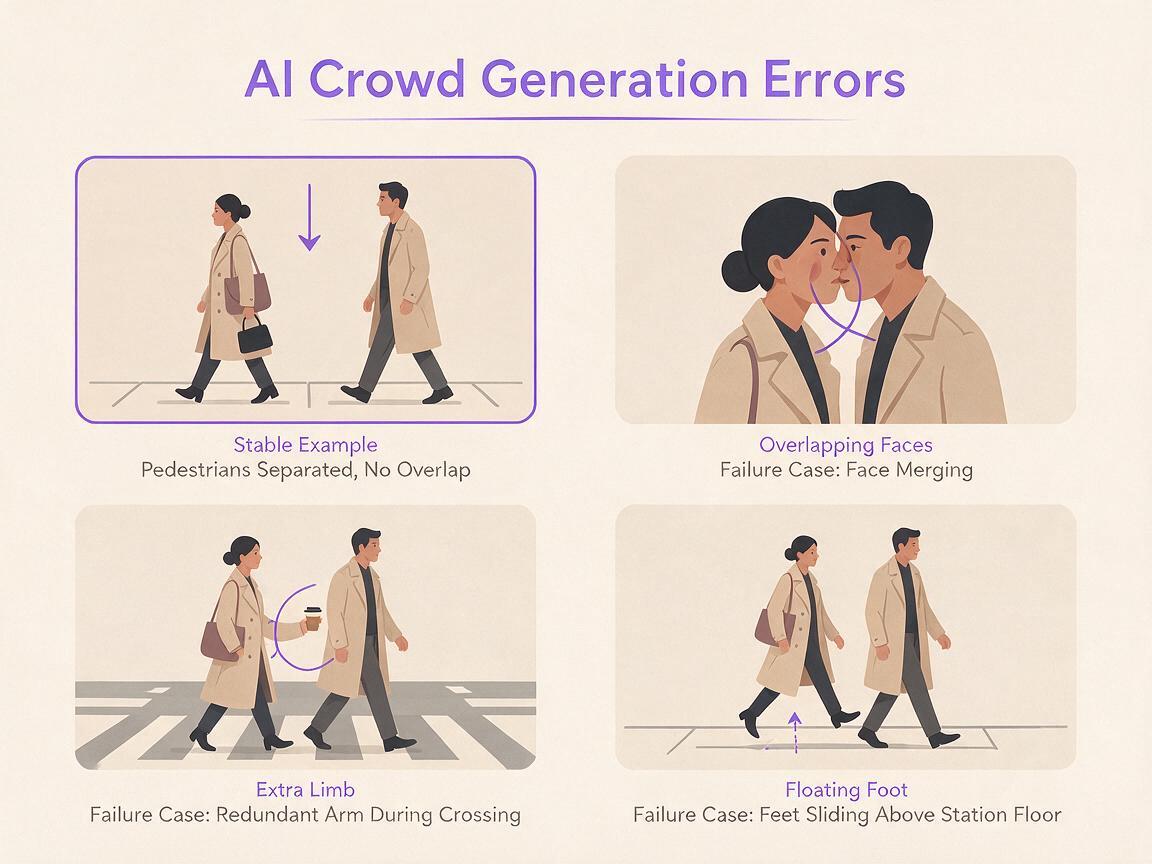
- 交汇处的面孔融合:两名行人近距离经过时,他们的侧脸短暂融合成一张脸。
- 肢体重复或缺失:一只手臂出现在错误的人体后方,或者背景行人多出一条腿。
- 双脚滑动:人物在地面上移动,却没有可信的行走循环。
- 身份漂移:人群移动时,主要角色的发型、服装、年龄或面部结构发生变化。
- 人数不稳定:背景人物在不同帧之间出现、消失,或变成其他人物。
- 景深坍缩:远处行人突然变得和前景人物一样大。
稳定的人群不一定是静止的人群。它是一个根据景深、重要性和可见度分配运动的场景。
最大的错误,是赋予所有人同等的叙事重要性。观众通常会关注一个主体或一个局部事件。其余人群可以通过较小的动作营造氛围,例如转头、调整重心、浏览摊位,或穿过远处背景。
生成 AI 人群场景的三种方式
- 锚点画面动画:先生成一张完整静态图像,再为其添加动画。这种方式对构图、服装、人群密度和主要角色拥有最强控制力。
- 文本驱动的建立镜头:通过文本提示词生成整个场景。这适合探索,但人物身份和人群的具体位置不够可预测。
- 分层式剪辑覆盖:分别生成广角人群镜头、中景角色镜头和多个细节插入镜头。通过剪辑营造大型事件的感觉,而不要求每个人在同一个片段中始终保持完美。
本教程将第一种方式作为主要工作流;当单次人群生成变得过于不稳定时,再加入分层式镜头覆盖。
MagicBoat 如何处理多模型人群工作流
MagicBoat 将图像生成模型和视频生成模型整合到同一个账户中,便于在多个阶段测试同一场景。可以使用 Seedream、Flux 或 GPT Image 探索锚点画面,再使用 Seedance 和 Kling 对比动画效果。文本生成视频流程也可以帮助你在确定详细参考图像前探索摄影机角度。
重要的优势并不是永久选择某一个模型。人群场景包含多个独立问题,不同模型在构图、人物细节或运动处理方面可能各有不同。比较输出时,应保持提示词、参考图像、画面比例和预期动作一致。这样,模型选择就变成了受控测试,而不是一系列互不相关的猜测。
| 制作任务 | 建议方法 | 主要评估指标 |
|---|---|---|
| 探索场景地点 | 文本驱动的图像或视频生成 | 景深、光线、摄影机角度 |
| 锁定人群构图 | 生成详细的锚点图像 | 人体分离度、清晰易读的轮廓 |
| 为克制的活动添加动画 | Seedance 或 Kling 图生视频测试 | 面部稳定性、脚部接触、遮挡 |
| 修复剪辑 | 生成替代镜头覆盖 | 不稳定帧周围的连续性 |
第 1 步——确定一个视觉重点
确定观众必须首先注意到什么。它可以是穿过车站的快递员、走进节日现场的歌手,或在夜市为顾客上菜的厨师。用一句话描述故事,不要罗列所有背景动作。
主要故事节拍:一名身穿芥末黄色外套的女性在花摊旁停下,而通勤者继续从她身后经过。然后将演员分为三个优先级:
- 主要主体:一个人物,其外貌和动作必须清晰可辨。
- 辅助人物:两到四个人,执行简单且彼此不同的动作。
- 环境人群:远处人物主要通过轮廓、间距和低细节运动来表现。
预期结果:建立清晰的层级,避免提示词把二十名行人当成二十位主演。
第 2 步——构建一张适合人群场景的锚点画面
先生成静态图像,再要求添加运动。优先选择具有明显景深、相邻头部之间留有空间,并且主要主体周围遮挡较少的摄影机角度。三分之四视角通常比一整面正对摄影机的人墙更容易看清。
可以使用这样的构图提示词:
纪录片风格的广角镜头,阳光照耀的火车站大厅,一名身穿芥末黄色外套的女性站在左侧中景的花亭旁,轮廓清晰分离,五名附近的通勤者分布在不同景深位置,更多远处旅客以小型自然人物呈现,真实的地面透视,清晰可见的行走通道,温暖的窗光,克制的色彩方案,35mm 镜头,自然的人体比例,无人看向摄影机。如果第一张结果过于拥挤,不要只是添加“禁止人物重叠”。应减少人物数量,并明确指定开放通道或可见间隙。避免让主要主体正好位于穿着相似颜色的人前方,因为他们的轮廓可能难以被视频模型区分。
以原尺寸检查画面:
- 主要角色的双手是否容易理解?
- 能否追踪每个附近人物的躯干和双腿?
- 头部是否尽可能保持分离?
- 地面是否提供清晰的透视关系和接触点?
- 背景人物是否小于前景人物?
预期结果:即使不依靠动画修复人体结构或构图,这张静态图像本身也已经可信。
第 3 步——将画面转换为运动区域
在编写视频提示词之前,为图像的不同部分分配不同的运动强度。这样可以营造出鲜活人群的感觉,而无需让每个人都执行复杂编舞。
| 区域 | 建议运动 | 应避免 |
|---|---|---|
| 主要主体 | 一个明确的手势或短促动作 | 同时走路、转身、挥手和说话 |
| 附近人物 | 缓慢穿过、浏览、调整重心 | 在主要主体附近发生交叉路径 |
| 远处人群 | 细微的横向流动和轻微头部运动 | 逐一描述人物表演 |
| 环境 | 轻微的布料、蒸汽、植物或光线变化 | 大幅结构变化 |
将计划写成简短的节拍图:
0–2 秒:女性保持静止,望向花摊。
2–4 秒:她略微伸手靠近一束花。
全程:两名通勤者在远处背景中缓慢穿过;其他旅客只做细微自然的动作。
摄影机:锁定的广角镜头,几乎无法察觉的手持呼吸感。预期结果:一份受边界控制的运动计划,其中主要动作易于识别,背景运动也不会与其争夺注意力。
第 4 步——编写描述运动而非静态图像的提示词
参考画面已经包含地点、服装、光线和人群布局。在运动提示词中重复所有这些细节,可能会引入相互冲突的指令。应集中描述随时间发生的变化,以及必须保持不变的内容。
身穿芥末黄色外套的女性停下脚步,将视线稍微转向花卉展示区,并用右手做出一个小幅度的伸手动作。两名远处的通勤者在她身后从右向左缓慢行走。其余人群只做细微的重心转移和自然的头部运动。保持每个人的服装、面部外观、身体比例以及景深位置不变。保持花亭和车站建筑不变。锁定的广角摄影机,真实且克制的运动,不要突然出现或离开的人物。对于 Kling 提示词,直接描述物理动作是一个实用起点:明确谁在移动、移动方向和动作幅度。对于 Seedance 提示词,也可以测试相同的时间节拍结构。这些并不是严格固定的模型公式;目标是通过保持相同的运动简报,让比较更加公平。
如果不必要的变化仍然存在,先简化正向提示词,再添加一长串禁止项。“主要主体做一个小幅度的伸手动作”比先要求一段拥挤的连续场景、再禁止几十种可能的问题更加清晰。
预期结果:一份聚焦运动的提示词,能够保留锚点图像,而不是要求模型重新解读它。
第 5 步——生成短促且受控的人群运动
使用同一张锚点图像至少进行两次测试,最好保持预期时长和取景一致。第一次尝试的时长应足够短,让一个动作能够自然完成。片段越长,人物越容易交叉、融合,或偏离最初的设计。
测试两种运动级别:
- 保守测试:锁定摄影机、一个主要手势,以及细微的环境人群运动。
- 中等测试:在相同手势基础上,加入一名远处行人经过,以及轻微的摄影机呼吸感。
不要只根据预览是否令人兴奋来判断。检查主要角色的面部、双手、外套边缘以及与地面的接触。然后检查附近行人在最大程度重叠时的表现。
最佳版本通常是故事节拍最清晰的片段,而不是运动量最大的片段。
预期结果:得到两个可以直接比较的片段,明确显示构图在视觉稳定性下降之前能够承受多少运动。
第 6 步——分三轮检查片段
一次性检查所有内容,容易漏掉小缺陷。可以分三轮进行:
- 身份检查:只关注主要角色的面部、头发、服装和身体比例。
- 互动检查:检查人物交叉、双手、双脚、遮挡以及人体之间的间隙。
- 环境检查:检查标识、建筑、花亭边缘、阴影和地面透视。
记录缺陷第一次变得干扰观感的帧。片段不必一直使用到生成终点。如果前 3 秒都很干净,而第 4 秒出现了融合的行人,就应在问题出现前剪掉。
预期结果:得到精确的可用范围,而不是笼统地判断整个生成成功或失败。
第 7 步——通过增加镜头覆盖扩展场景,而不是制造更多混乱
如果故事需要更大的规模,应创建独立镜头,而不是增加同时发生的动作数量。一个实用的镜头序列可以包括:
- 一个用于建立人群和地点的广角镜头。
- 一个展示主要角色开始关键手势的中景镜头。
- 一个花朵或主要角色手部的细节镜头。
- 一个展示远处通勤者的反打镜头。
- 一个简短的环境插入镜头,例如出发信息牌或滚动的行李箱。
在不同锚点图像中重复使用主要角色参考图、服装描述、光线方向和地点描述。除非辅助人物承担叙事作用,否则背景人群不必做到逐人匹配。
预期结果:剪辑后的序列看起来人群密集,同时每个生成镜头只承担可控的视觉任务。
让同一个主要角色贯穿不同人群镜头
在制作其他角度前,保存一张主要角色的中性肖像和一张全身参考图。重复使用一段简洁的身份描述,将固定特征与镜头专属动作区分开:
固定身份:三十岁出头的女性,椭圆脸,短黑色波浪发,小型银色圆环耳环,芥末黄色羊毛外套,炭灰色长裤,黑色皮质短靴。
镜头动作:在花亭旁停下,望向一束花。
连续性:面部、发型、外套、身体比例和年龄与参考图保持一致。
不要在每个镜头中用同义词重写身份描述。除非有意改变服装,否则“芥末色羊毛外套”不应变成“金色宽大夹克”。
替代方案:使用动作迁移完成前景表演
当主要角色需要执行可识别的舞蹈、演示或全身手势时,动作迁移可能比完全用文本描述表演更容易控制。让一名表演者在清晰背景前录制动作,确保全身可见、画面稳定,并且没有其他人物从前方经过。
先将该动作迁移到主要角色身上,再将单独生成的人群镜头作为切换镜头或背景使用。复杂的动作迁移与密集的行人互动放在同一画面中,仍可能造成遮挡问题,因此应让表演区域保持视觉上的开阔。
替代方案:使用换脸修复漂移的面部
如果身体运动、服装和人群互动都很成功,但主要角色的面部发生漂移,可以使用换脸,在不重新生成整个片段的情况下保留有效动作。使用清晰且经过授权的参考图像,并仅在需要修复身份的位置应用校正。
换脸无法修复人体融合、错误景深、消失的肢体或糟糕的编舞。这些问题需要更干净的锚点画面、更少的运动或不同的剪辑方式。
这套工作流的局限
- 近距离的行人交叉仍然存在风险。当两个大型人物连续数帧发生重叠时,轮廓和身份仍可能融合。
- 小型背景面孔不适合作为可靠肖像。应将其视为环境人物,而不是可识别的重复角色。
- 清晰可读的文字可能发生变化。标牌、信息牌、标签和印刷在服装上的文字可能在动画过程中发生变化。
- 复杂的群体编舞需要拆分。协调舞蹈、打斗或体育比赛更适合拆分为聚焦镜头,或使用动作参考来处理。
- 完美的第一帧并不代表结果有保证。每个片段仍需逐帧检查,因为时间维度上的错误可能在开头干净之后出现。
常见问题
锚点图像中应该包含多少人?
只使用传达场景所需的人数。限制附近人物的数量,并让他们彼此清晰分离;远处人物可以在无需逐个看清面部的情况下体现更大的规模。
人群场景中应该移动摄影机吗?
从锁定摄影机或非常克制的推进开始。大幅摄影机运动会改变每个人物的遮挡关系和透视,从而增加人体结构和景深错误的可能性。
可以让所有人同时行走吗?
可以提出这个要求,但同步的全身运动会显著增加处理难度。更好的方法是设置一到两名清晰可辨的行走者,同时让其他区域保持细微的环境运动。
应该使用 Seedance 还是 Kling?
使用同一张锚点图像和相同的运动简报测试两者。应根据身份稳定性、干净的遮挡关系、自然的脚部接触,以及对环境的保留程度来选择结果,而不是只凭对模型的偏好。
如何阻止新人物出现?
使用固定的锚点图像、受控的摄影机运动,并加入“保留现有人群布局”和“不要突然出现或离开的人物”等措辞。如果问题仍然存在,应缩短片段并减少环境运动。
换脸可以修复人群中的每个人吗?
不能。换脸最适合用于清晰可见的主要角色,并且需要使用经过授权的参考图像。背景人群的问题通常更适合通过剪辑、替代镜头覆盖或重新生成来隐藏。
创建你的第一个稳定人群场景
从一张清晰易读的锚点画面、一个主要动作和克制的背景运动开始。免费创建你的第一个 AI 视频,使用相同提示词比较兼容的模型,并保留能够让人物保持稳定、而不是单纯增加最多运动量的版本。
最终检查清单
- 选择一个主要主体和一个主要故事节拍。
- 分离相邻人物,并保留开放的行走通道。
- 在生成运动前构建干净的锚点画面。
- 根据景深和重要性分配不同的运动级别。
- 在视频提示词中描述一个主要动作。
- 比较保守和中等运动测试。
- 分别检查身份、互动和环境。
- 在第一帧不稳定之前进行剪辑。
- 使用额外镜头覆盖,而不是让一个片段承担过多内容。
关键词
图像生成视频,AI 人群场景,角色一致性,AI 视频教程,Seedance 提示词,Kling 提示词,提示词工程