如何使用图像生成视频 AI 创建稳定的群像场景
稳定的 AI 群像场景源于将演员阵容设计为视觉层,而不是要求模型一次生成许多同等重要的人物。先构建一张受控的调度画面,将主角与近景及背景群众分开,然后使用克制的图像生成视频运动;出现结构性错误时重新生成,而不是事后尝试修复。
文章目录
TL;DR
创建可信群像的最快方式,是先生成一张经过精心调度的静帧,然后只为少数几个运动层添加动画。
要制作稳定的群像场景,应使用 图像生成视频,而不是要求文本生成视频 AI 同时虚构地点、演员阵容、身份、姿势和动作。让一个主角获得视觉优先级,将附近的临时人物限制为彼此不同的剪影,把远处人物简化为背景纹理,并让第一轮动画保持克制。
为什么 AI 群像场景会生成重复人物
“一座挤满通勤者的繁忙车站”这样的提示词对人类来说很清楚,但它让视频模型面临数十个尚未解决的决定。模型必须决定有多少人、每个人的身体从哪里开始到哪里结束、哪些四肢可见、每个人如何移动,以及一个人从另一个人身后经过后是否仍应保持为同一个人。
常见问题包括:
- 身份重复:同一件外套、同一张脸或同一种发型出现在多个临时人物身上。
- 身体融合:两个人擦肩而过时,短暂共享一条手臂、一个肩膀或一具躯干。
- 人数闪烁:新人物在帧与帧之间凭空出现,或从细小物体后面消失。
- 主角漂移:主角的脸发生变化,因为模型将所有可见的脸都视为同等重要。
- 运动冲突:人群向多个方向移动,同时镜头也在摇摄,从而加剧时间稳定性问题。
实际解决方案不是编写更长的描述性提示词,而是建立更简单的视觉层级。
构建更稳定群像的三种方式
- 参考图优先的动画:先创建一张经过有意安排、间距合理的关键帧,然后为其添加动画。
- 分层合成:当单次生成仍不稳定时,将主角、近景临时人物和远处人群作为独立视觉层分别生成。
- 受控动作迁移:当场景需要精确的群体时序,而不是宽泛生成的动作时,使用源表演素材。
本教程采用第一种方法,因为它在速度、构图控制和可重复性之间实现了最佳平衡。其他方法将在后文介绍。
MagicBoat 如何处理以群像为重点的 AI 视频工作流
MagicBoat 允许你通过一个账号试用多个图像和视频模型。一种实用的工作流是使用 Seedream、Flux 或 GPT Image 制作调度画面,然后在 Seedance、Kling 或 Veo 中比较同一张画面,而不是围绕某一个模型重新构建项目。
静态图像控制人数、服装、间距和地点几何结构。图像生成视频阶段则添加克制的环境与人物运动。这种分离也让问题诊断更容易:如果两个身体在静帧中就已经融合,应修复静帧;如果它们只在动画后融合,则简化运动提示词或测试另一个视频模型。
| 制作任务 | 适用模型组 | 主要目标 |
|---|---|---|
| 主角参考图 | Seedream、Flux、GPT Image | 锁定脸部、发型、服装和身材比例 |
| 地点与调度画面 | Seedream、Flux、GPT Image | 控制人群位置和景深 |
| 细微群像动画 | Seedance、Kling、Veo | 保留画面,同时添加运动 |
| 针对性修正 | 换脸或重新生成关键帧 | 修复身份,同时保留良好的动作 |
步骤 1——确定一个主角和一套人群语法
选择一个必须保持可识别身份的人物。其他人只应通过角色、服装系列和剪影来描述,而不是为其编写详细的面部背景。这可以避免提示词将十张脸赋予同等的视觉重要性。
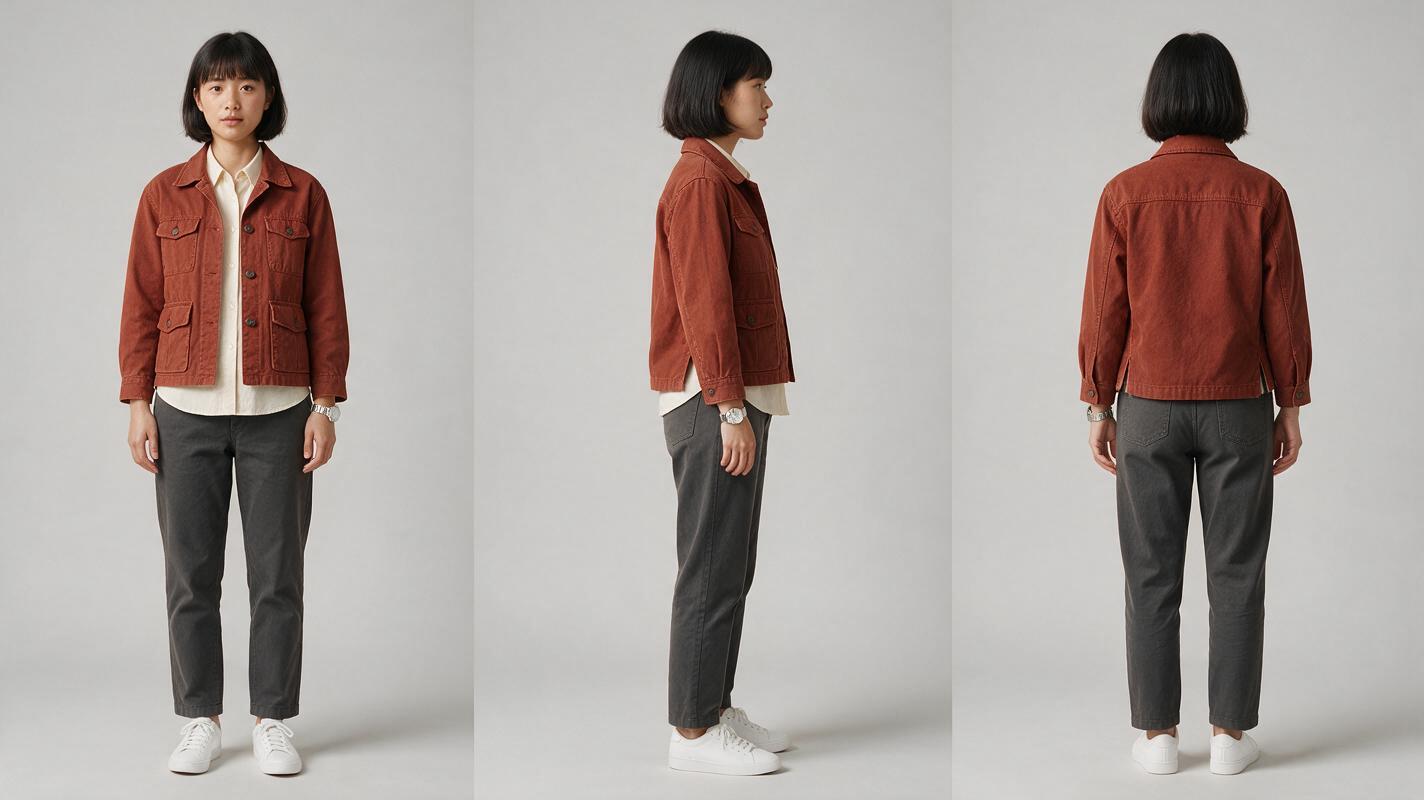
在构建群像场景之前,先为主角创建一张三视图参考表。让服装实用且具有辨识度:一件容易识别的夹克、一种发型和一件配饰,比复杂的织物图案更容易被保留。
写实风格的三联面板人物参考表,每个面板中都是同一名28岁东亚女性,椭圆脸,齐下巴的直发黑色波波头,发尾齐平,深棕色眼睛,铁锈红色短款工装夹克,内搭奶油色圆领衫,炭灰色直筒裤,白色低帮运动鞋,纤细的银色腕表;所有面板中均完整显示全身;左侧面板为正面视图,中间面板为完全左侧面视图,右侧面板为背面视图;三种视图中的服装、发型、身体比例和中性表情完全一致;中性浅灰色无缝摄影棚背景;柔和均匀的编辑风格摄影棚光线;真实的皮肤和织物纹理;无道具、无文字、无其他人物。强制相机设置:平视相机,正交参考表效果,所有面板中的主体比例相同,无广角畸变。强制布局:横向16:9,三个间距均匀的垂直面板,从头到鞋完整显示人物,并保持清晰分隔。预期结果:一张可重复使用的身份参考表,没有夸张姿势、环境阴影或服装变化。如果三个面板看起来像亲戚而不是同一个人,请在继续之前重新生成。
步骤 2——构建带有运动通道的地点底图
先设计地点,再添加人物。实用的群像地点应具有明显的深度、开放的行走通道,以及能够自然分隔画面的物体。长椅、柱子、店面和地面标线有助于让人物处于不同的空间区域。
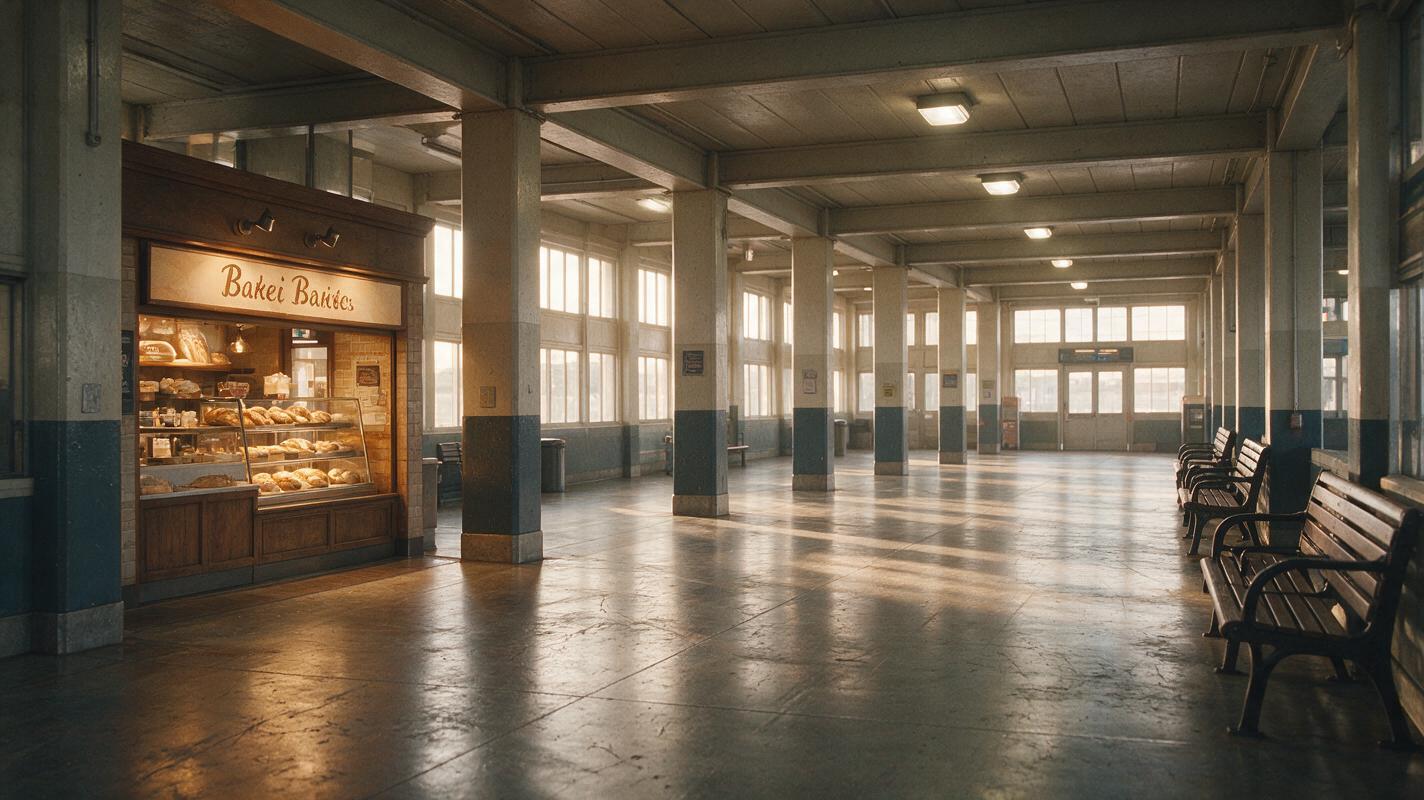
在本例中,使用一座通勤铁路大厅:前景有清晰的横穿通道,中间是主角区域,背景则是较柔和的等候区域。
一张电影感编辑写实风格照片,展示清晨充满生活气息的城市通勤铁路大厅,经过抛光的石材地面带有细微磨损,左侧是温暖的面包店店面,远处背景有时刻表看板但不含可读文字,结构柱形成清晰的纵深通道,右侧墙边排列着长椅,高大的窗户让柔和的阴天日光进入,实用的顶灯仍然亮着,真实的反射和日常磨损,完全没有人物,可作为干净的地点底图使用。强制相机设置:从大厅前右侧进行平视的真实三分之四视角,35毫米镜头,锁定相机,垂直线保持笔直,中等景深。强制布局:横向16:9,为主角留出开放的中央路径,前景横穿通道无遮挡,深处背景区域预留给柔和的人群层。预期结果:一个具有三个清晰纵深区域、可信的地点。避免使用充满镜子、重复玻璃面板或狭窄栏杆的地点;这些细节可能在动画过程中产生额外反射和碎片化身体。
步骤 3——构建有人物的调度画面
将主角和人群作为一张静态图像添加到地点中。让主角靠近画面中间三分之一的位置,只使用三到四个清晰可见的近景临时人物,并以整体方式描述远处人物。每个近景临时人物都应具有不同的色块和朝向。
不要要求“二十个独特且细节丰富的通勤者”。应要求少数彼此分隔的前景人物,以及一群柔和、不突出的背景人群。
将提供的铁路大厅地点作为确切环境,并将提供的三视图女性作为主角身份。将主角置于中景中央,朝镜头左侧行走,铁锈红色夹克完整可见,脸部呈三分之四角度。添加四个彼此清晰分隔的近景临时人物:最左侧一名穿海军蓝色大衣、背对镜头走远的年长男性;右侧长椅旁一名穿芥末黄色雨衣的年轻女性;前景中一名穿灰色连帽衫、高大且面朝另一方向横穿画面的男性;面包店附近一名穿森林绿色外套的通勤者。在柱子后方添加稀疏的远处人群,以小型柔和剪影呈现;不要重复服装,不要相同的脸,不要身体接触,不要头部重叠,不要双胞胎。根据景深保持真实比例,并在近景人物之间保留可见的开放地面。电影感编辑写实风格,自然晨光,克制的调色。强制相机设置:完全匹配地点底图,平视,35毫米镜头,锁定构图。强制布局:横向16:9,主角是唯一具有明显视觉主导性的脸,四个近景临时人物占据彼此不重叠的独立区域,远处人群保持次要地位。预期结果:画面读起来很繁忙,但不会变得视觉拥挤。以全尺寸检查每个剪影。一个变形的静止人物在动画后通常会变得更糟。
步骤 4——一次只为一个运动层添加动画
先进行一轮短时、锁定相机的测试。主角可以平静地走两步,近景临时人物则进行小幅度的独立动作。让远处人群保持柔和而缓慢。第一轮测试中不要同时加入行走、挥手、搬运行李、镜头环绕和快速前景横穿。
Seedance 风格提示词
锁定相机的电影感群像镜头。铁锈红色夹克的女性朝镜头左侧自然地走两步,同时保持相同的脸部、发型、服装和身体比例。年长男性继续缓慢地背对镜头走远。长椅旁的女性做一次轻微的重心转移。灰色连帽衫的前景通勤者平稳横穿画面,但不要挡住主角的脸。远处通勤者进行细微移动,并保持为柔和的背景人物。保留参考图中完全相同的车站建筑、人群数量、服装颜色和空间分隔。自然的行走节奏,稳定的解剖结构,不要出现新人物,不要重复人物,不要镜头移动,不要变形。Kling 风格提示词
锁定的35毫米车站镜头。穿铁锈红色夹克的主角向左平静地走两步,身份和服装不变。四名彼此分隔的近景通勤者进行极少量的自然动作;远处人群缓慢移动。保留每个人的位置、比例和服装颜色。不要出现新人物,不要双胞胎,不要身体融合,不要镜头移动。预期结果:一段克制的短片,其中原始构图仍然清晰可辨。在完全重写之前,先将同一张调度画面交给多个模型处理;群像稳定性可能因场景、遮挡模式和要求的动作而异。
步骤 5——检查重复、解剖结构和运动
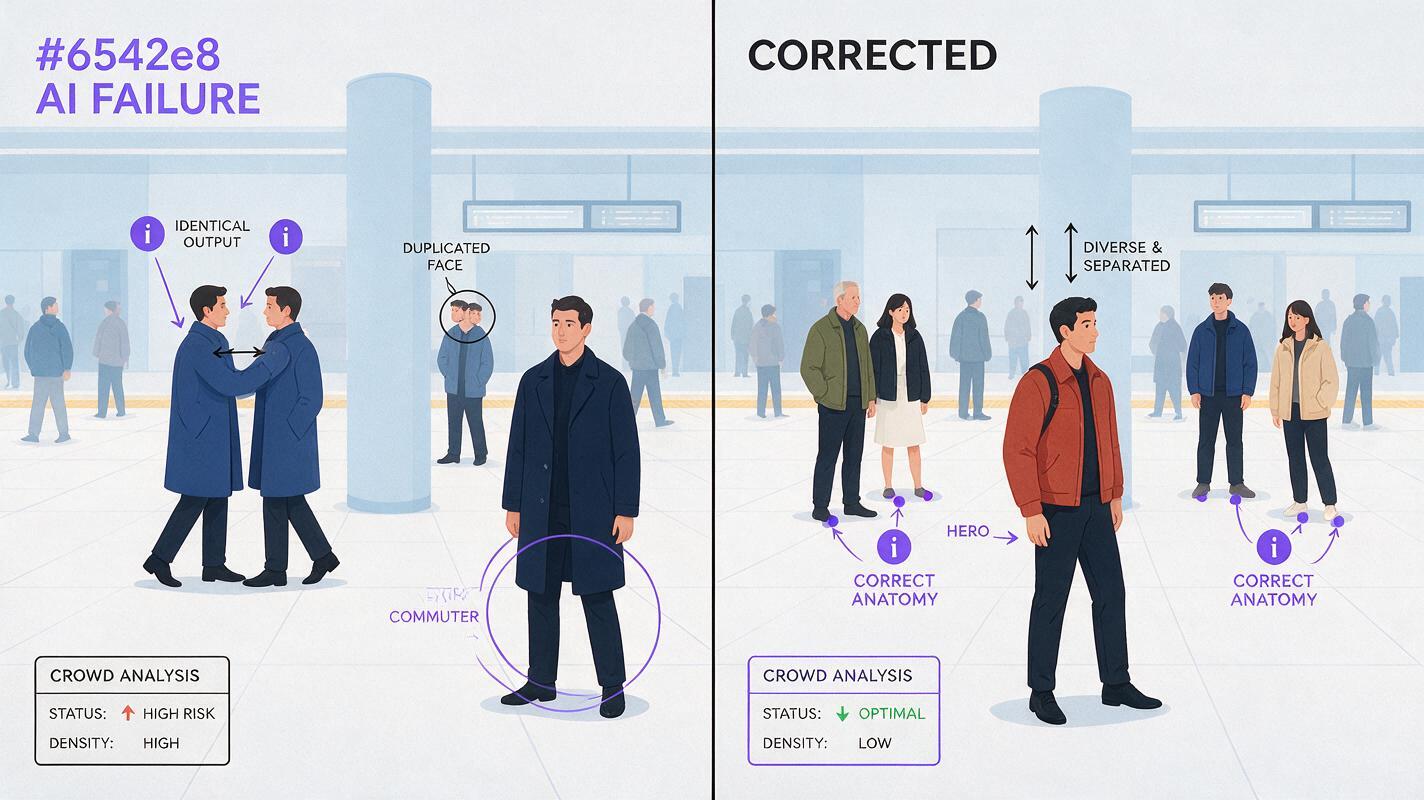
分三轮检查短片。第一轮忽略主角,从头到尾统计可见人物数量。第二轮检查主角的眼睛、下颌、发际线和夹克。第三轮在每次遮挡处暂停,尤其要关注一个人从另一个人身后经过或离开画面的时刻。
同一通勤大厅和相同相机角度的双面板写实电影画面对比;左侧面板展示失败的 AI 群像,其中有两个相同的海军蓝大衣男性、一处融合的肩膀、背景中一张重复的脸,以及一名凭空出现的通勤者;右侧面板展示修正后的场景,其中有一名穿铁锈红色夹克的主角、四名穿不同颜色服装且彼此清晰分隔的近景通勤者、稳定的解剖结构、开放的地面间隙,以及稀疏柔和的背景人群;真实的清晨车站光线和一致的建筑。强制相机设置:平视、锁定的35毫米视角,两侧面板构图完全一致。强制布局:横向16:9,平均分为左侧失败和右侧修正两部分,无界面、无标识、无装饰性图形,缺陷可见但不过于怪诞。| 问题 | 最佳应对方式 | 原因 |
|---|---|---|
| 主角脸部漂移,但动作良好 | 应用针对性换脸 | 保留成功的表演 |
| 两个身体融合 | 减少横穿动作或重新生成 | 面部修复无法恢复身体几何结构 |
| 出现额外人物 | 加强人数和进入限制 | 这是时间性错误,而非外观问题 |
| 背景闪烁 | 减少背景运动或弱化景深 | 细小的远处人物很难被持续追踪 |
| 整个画面扭曲 | 使用相同输入测试另一个模型 | 参考画面本身可能没有问题 |
预期结果:一段人数保持稳定、人物分隔清晰且没有明显身份重复的短片。重新生成结构性错误;后期处理应仅用于局部身份问题。
在不同项目中保持相同的人群语言
在主角参考图和地点底图旁保存一份简洁的“人群语法”。记录服装色板、近景临时人物的最大数量、首选相机高度、运动方向和景深结构。重复使用这套语法,即使每个背景临时人物并非完全相同,也能形成具有辨识度的视觉世界。
- 主角:一个受保护的身份和一种标志性色彩。
- 近景临时人物:三到五个彼此分隔、具有不同色块的剪影。
- 背景:柔和、稀疏且不突出。
- 相机:在身体运动稳定之前保持锁定。
- 遮挡规则:每个镜头中重要的横穿动作不超过一个。
替代方案:为更密集的场景使用分层生成
如果单张调度画面无法容纳更大规模的人群,可以分别生成干净的地点、主角、近景临时人物和远处人群。然后将这些元素合成为一张关键帧,再进行动画处理。虽然准备工作更多,但这种方式可以让你独立控制比例和重叠关系。
确保每个图层的光线方向和相机透视完全一致。从平视角度拍摄的前景人物,无法自然融入从高角度视图生成的底图。
替代方案:使用动作迁移实现精确的群体时序
当人物必须完成同步编舞、协调训练或时间精准的入场时,可以使用动作迁移。录制或寻找一段全身清晰可见、构图稳定且遮挡有限的表演素材。源素材本身应包含你需要的间距和时序;动作迁移无法可靠地凭空创造被其他表演者遮挡的缺失四肢。
替代方案:使用换脸替代主角漂移
当主角的身体动作、光线和服装正确,但面部身份发生变化时,换脸非常有用。使用角度和表情相近的干净参考图。不要用它来修复重复的身体、错误的头部朝向、严重模糊,或被另一个人挡住的脸。
这一工作流的局限
非常密集的人群仍然很难处理,因为细小的脸部和四肢提供的视觉信息有限。快速手持镜头也会放大身份和人数漂移。反射、雨伞、旗帜、自行车和带轮行李会引入更多交叉关系,需要模型在时间维度上进行追踪。
稳定的关键帧可以提高成功概率,但不能保证时间上完全无瑕。对于需要精确重复出现的临时人物,应将他们作为独立角色生成,或分别拍摄不同的动作层,而不是把他们视为匿名人群。
常见问题
第一次测试群像时应该加入多少人?
从一名主角、三到四名清晰可辨的近景临时人物,以及一层柔和的背景人群开始。只有在这一结构能够可靠地完成动画后,再增加密度。
每个临时人物都需要详细的人物提示词吗?
不需要。为每个人编写详细的身份描述会相互争夺模型的注意力。应通过剪影、服装颜色、朝向和位置来定义近景临时人物;详细的身份锚点留给需要反复出现的角色。
文本生成视频适合群像场景吗?
如果是探索性镜头,且不在意确切人数和身份,它可以发挥作用。但对于可重复的构图,参考图优先的图像生成视频工作流能让你更好地控制间距和层级。
为什么镜头移动时会出现人物?
镜头移动会暴露新的图像区域,而模型必须合成这些区域。它可能会以不一致的方式填充这些区域。先使用锁定相机,只有在身体运动稳定后,才测试缓慢推镜或摇摄。
换脸能消除重复人物吗?
不能。它可以修正一个可见的脸,但重复的身体和融合的剪影需要重新生成、合成或采用更简单的调度方式。
我应该使用哪个模型?
没有哪个模型能在所有群像布局中都占据优势。固定调度画面和提示词,比较可用模型,并从人数、遮挡处理、主角身份和建筑稳定性等方面进行评估。
最终检查清单
- 为主角创建一张中性的三视图参考图。
- 构建地点,明确划分前景、中景和背景通道。
- 限制细节丰富的近景临时人物数量,并为每人提供独特剪影。
- 动画前检查有人物的静帧,确认没有融合的解剖结构。
- 先用锁定相机为一个主要动作添加动画。
- 在短片开始、中间和结束时统计人数。
- 重新生成身体问题;仅对局部身份漂移使用换脸。
准备好测试分层人群方法了吗?使用 MagicBoat 免费创建你的第一个AI 视频,并在多个模型中比较同一张参考画面。
关键词
图像生成视频、AI 群像场景、AI 视频工作流、角色一致性、Seedance 提示词、Kling 提示词、提示词工程