如何使用 GPT Image 为无脸故事视频制作角色一致的角色形象
让无脸故事视频中的重复角色在每张静态图像中都保持易于识别。本教程将介绍如何创建参考图像、规划不同镜头、使用 GPT Image 生成场景,并在剪辑前发现连续性错误。
文章目录
让同一个角色在不同场景中都保持易于识别
你的无脸故事视频需要一个重复出现的角色,但每生成一张新图片,角色的脸、外套或发型就会发生变化。解决方法是先创建一张清晰的角色参考图,然后在这张参考图的基础上构建每个故事镜头,只改变场景和动作。这个 GPT Image 工作流可以帮助你制作出连贯的故事序列,而不是一组彼此无关人物组成的幻灯片。
你不需要一个完美的角色模型才能开始。你需要的是一份简短的可识别特征清单、一张可用的参考图,以及一种在图片进入时间线前检查连续性的方法。
步骤 1 — 在生成任何内容前规划镜头
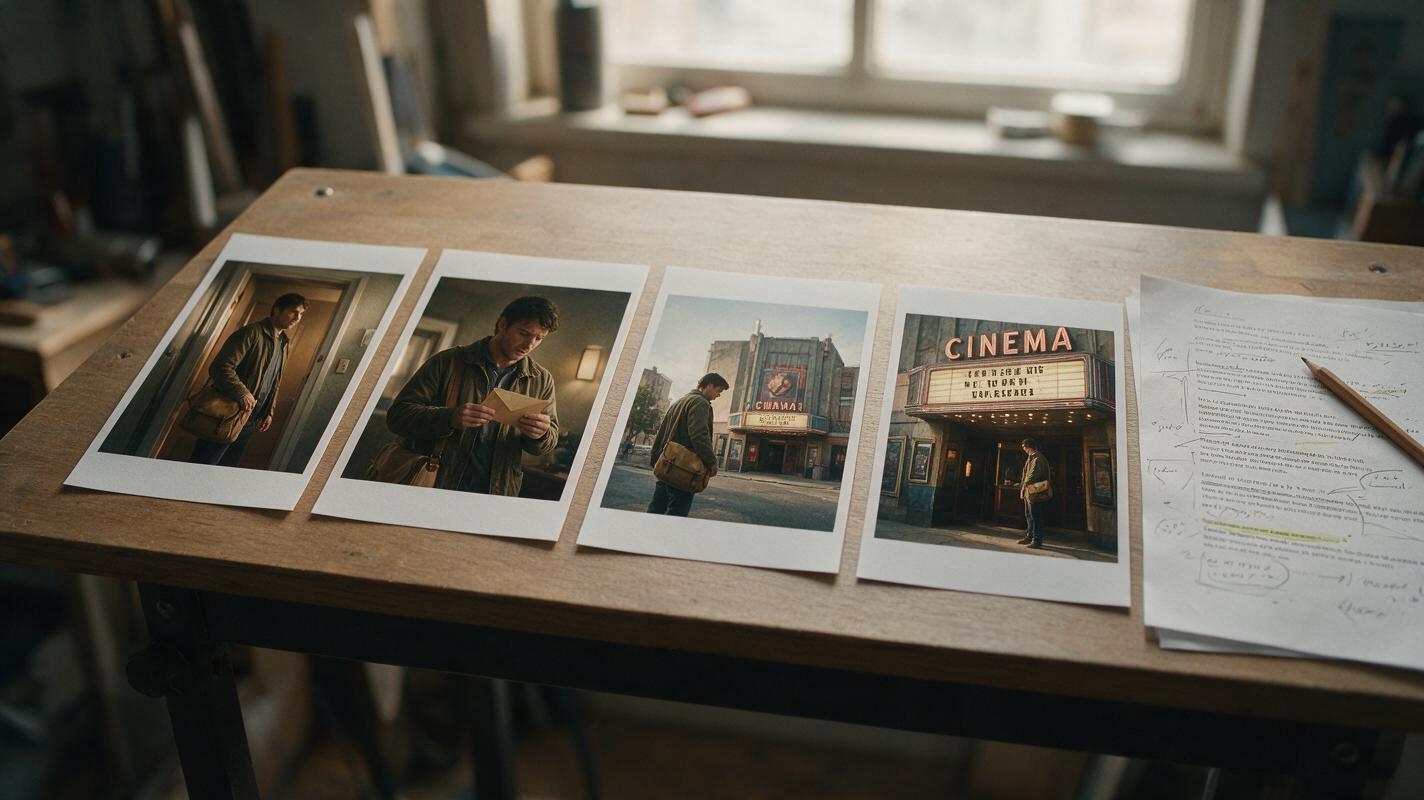
先从脚本中选出四到六个关键时刻。为每个时刻安排不同的叙事任务:交代地点、引出线索、展示决定、揭示后果。如果每个提示词都只是说“角色看起来很担心”,生成的图片可能会保持一致,但在视觉上会非常重复。
举个例子,想象一个无脸悬疑视频:一名快递员收到一封寄往一座废弃电影院的信封。这个角色会出现在多个镜头中,但镜头不必每次都展示他们的脸。
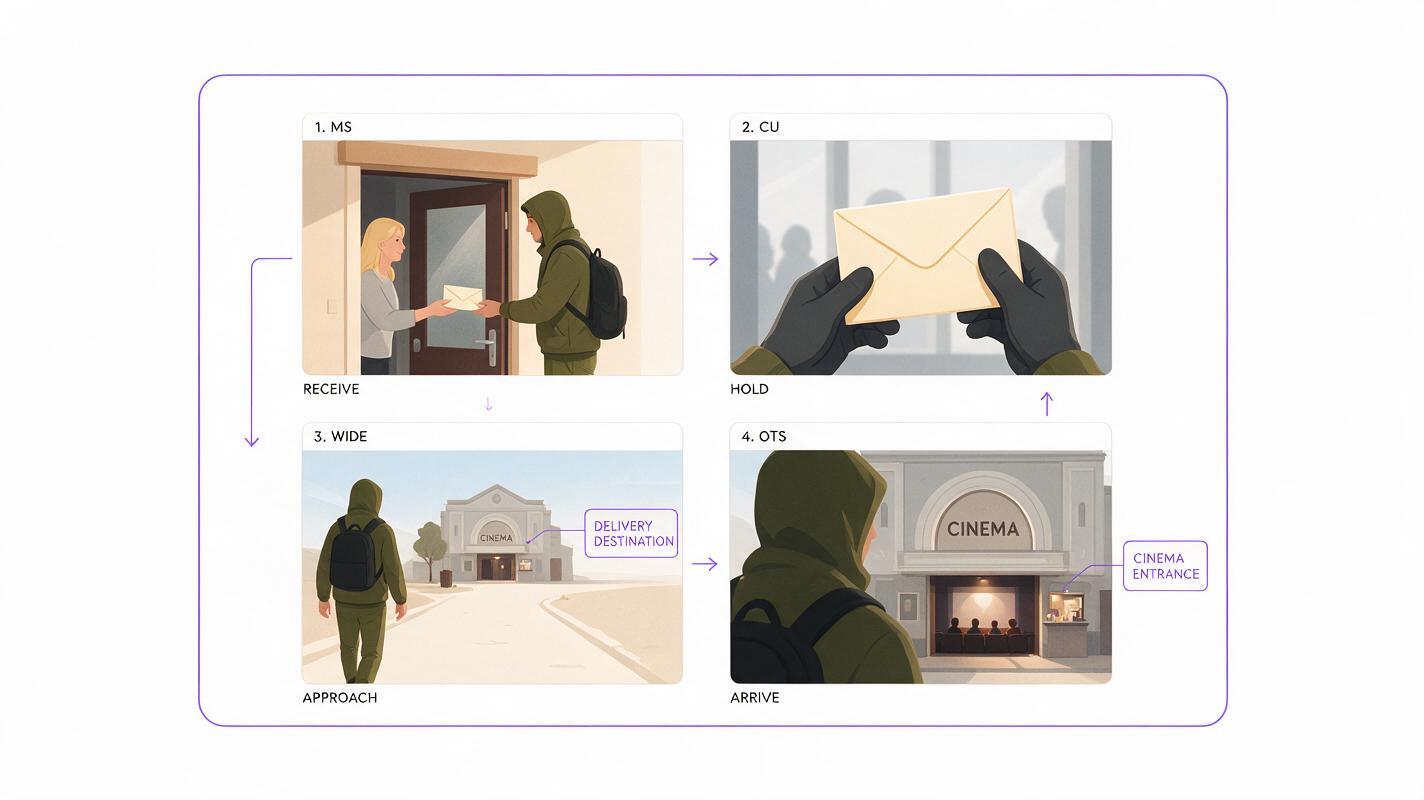
| 镜头 | 故事目的 | 构图 | 必须保持一致的内容 |
|---|---|---|---|
| 1. 投递 | 引出信封 | 门口的中景 | 快递员、夹克、挎包 |
| 2. 地址 | 揭示目的地 | 手和信封的特写 | 夹克袖子、挎包肩带 |
| 3. 抵达 | 营造紧张感 | 电影院外的远景 | 快递员的身影和服装 |
| 4. 决定 | 以问题收尾 | 入口处的越肩镜头 | 头发、夹克、挎包 |
这份镜头清单还会告诉你哪些地方需要展示脸部。手部特写和背面视角可以承载两个情节点,而不必强迫模型在每一帧中都重现面部细节。
步骤 2 — 制作可重复使用的角色参考图
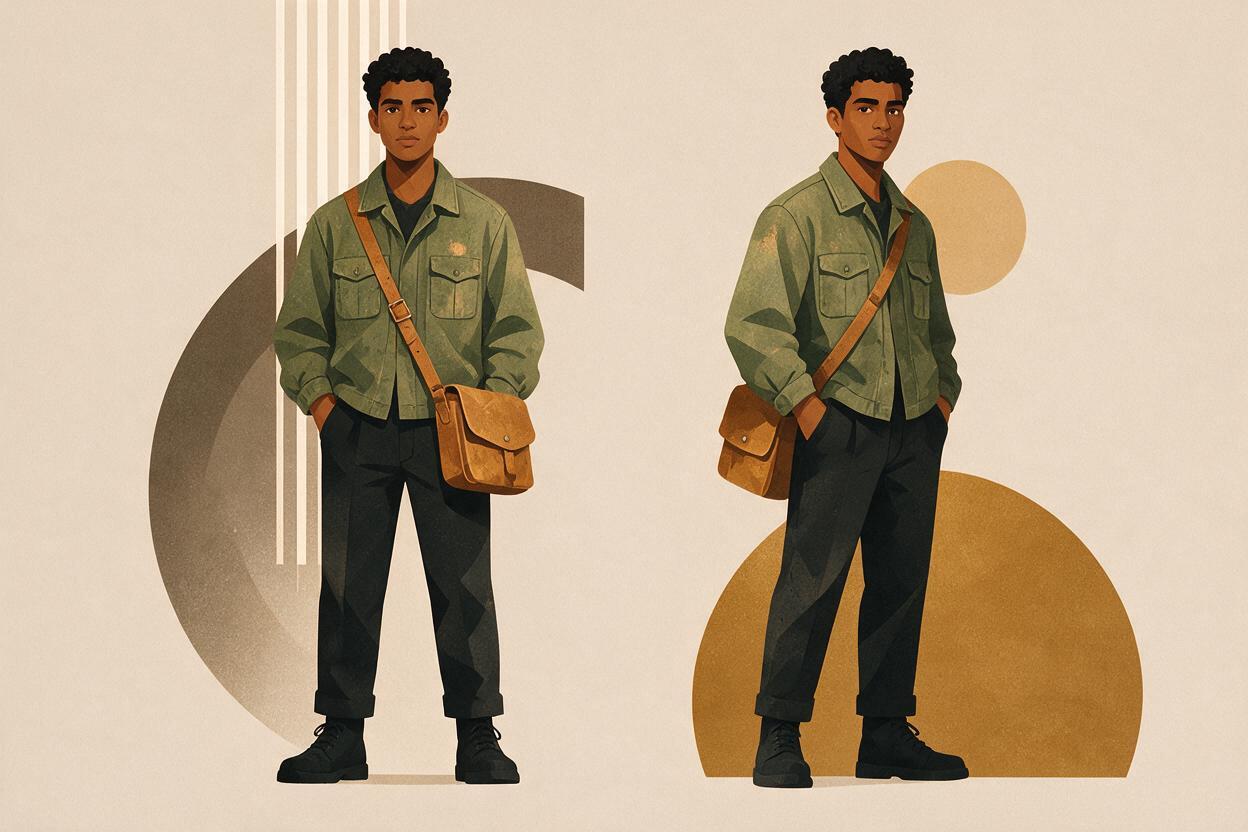
在要求生成电影感场景之前,先使用AI 图像生成器创建一张简洁、易读的角色参考图。在 GPT Image 中,先以简洁的全身像或四分之三身像作为起点,背景要整洁、不杂乱。选择那些在视频尺寸下也容易识别的特征:特定的发型、一件有辨识度的服装,以及一个道具。
对于这名快递员,描述要足够简短,方便重复使用,同时避免前后矛盾:
为一名原创虚构快递员创建一张写实的角色参考图,年龄约 30 岁,留着短而卷曲的深色头发,脸型偏窄,穿一件褪色的橄榄绿色工装夹克、深色长裤,背着一个磨旧的棕褐色斜挎包。画面中只有一个人,自然站立在简洁的中性背景前,取景范围从头部到大腿中部。柔和的日光,清晰展示脸部、头发、夹克和挎包。不要文字、徽标、其他人物或戏剧化灯光。将效果最好的结果保存为你的主参考图。检查轮廓是否清晰、服装细节是否可见,以及脸部是否没有被阴影遮挡。如果夹克颜色或挎包不对,现在就修正参考图;不要围绕一张你本来就打算替换的图片去构建四个场景。
让参考图实用起来:一张清晰的图片比一份复杂的角色传记更有用。屏幕上可见的特征,才是后续提示词能够帮助你保留的特征。
步骤 3 — 使用同一张参考图生成每张故事图片
对于每个镜头,都通过支持图像输入的界面将主参考图提供给 GPT Image。要求它将参考图中的人物作为角色参考,然后描述新的构图。保持身份和服装说明不变,只改变地点、摄像机角度和动作。
下面是第一个故事镜头的提示词:
使用附带的快递员图片作为角色参考。保持同一个人、短而卷曲的深色头发、褪色的橄榄绿色工装夹克、深色长裤,以及磨旧的棕褐色斜挎包不变。创建一张写实的电影感静帧:快递员站在一扇公寓门口,手里拿着一个刚从画外某人手中收到的、已经封好的奶油色信封。中景,下午晚些时候的自然光,安静而神秘的氛围。画面中只能看见快递员一人。信封上不要出现可读文字,不要徽标,不要字幕。对于抵达电影院的镜头,重复使用参考图和相同的身份描述句,但改变镜头内容:
使用附带的快递员图片作为角色参考。保持同一个人、短而卷曲的深色头发、褪色的橄榄绿色工装夹克、深色长裤,以及磨旧的棕褐色斜挎包不变。创建一张写实的宽幅电影感静帧:黄昏时分,快递员正走近一座古老而关闭的电影院。从背后拍摄快递员,让其在画面中占比较小,同时清晰展示前方的电影院入口。棕褐色挎包和橄榄绿色夹克要保持易于识别。不要其他人物,不要可读的标牌,不要字幕。注意哪些内容保持不变,哪些内容发生了变化。角色描述保持不变。第二个提示词改变了摄像机距离、场景、一天中的时间和故事动作。这种区分会让修改变得更容易:如果场景太亮,你可以调整灯光,而不会意外重写角色。
在生成完整视频之前,先用这组提示词测试一个两镜头序列。比较夹克、挎包、头发,以及在可见时的脸部。如果这些特征发生漂移,就在继续之前强化参考图和身份说明。
步骤 4 — 一次修正一个连续性错误
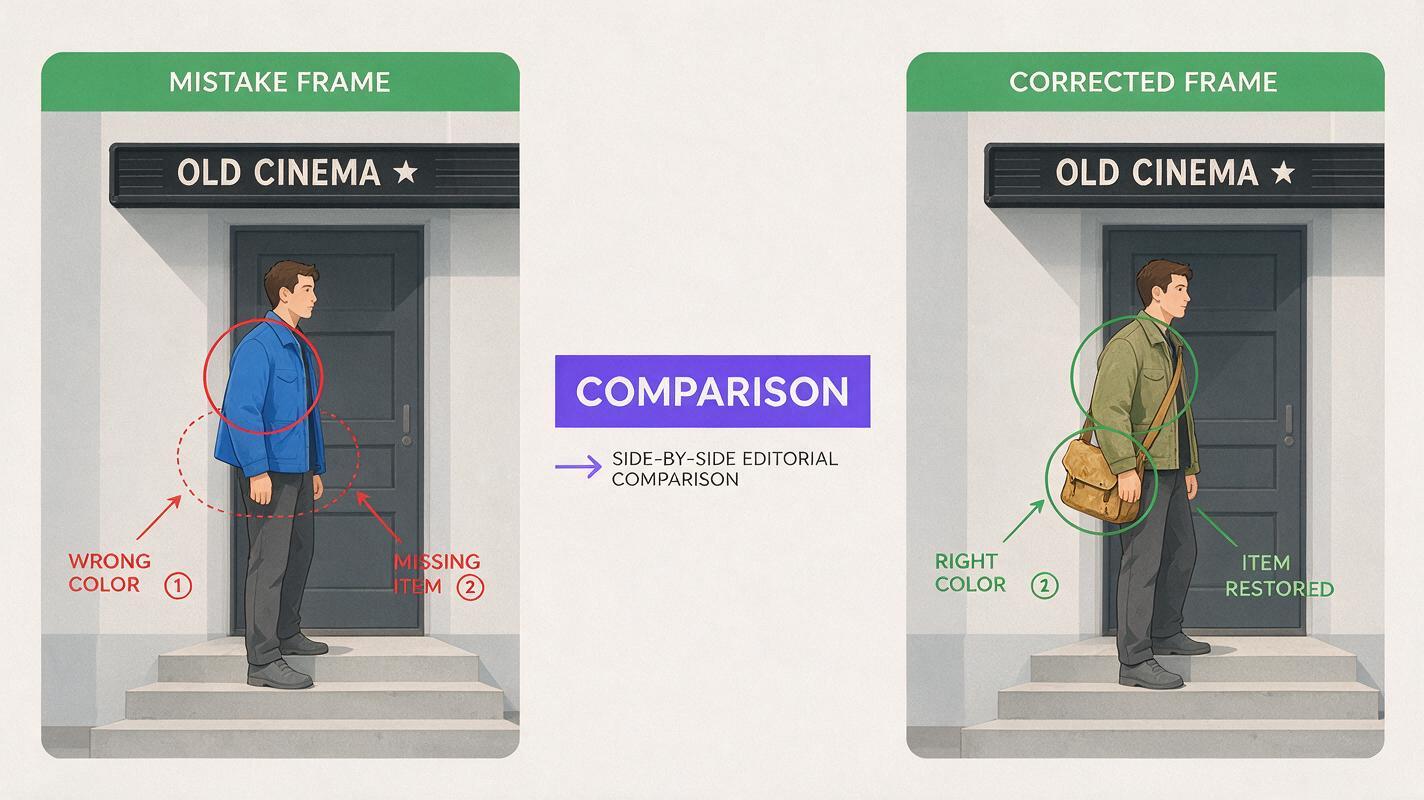
不要因为某个场景看起来很有电影感就直接接受它。将其与主参考图以及前后镜头进行对照。常见问题有不同的解决方法:
- 脸部不同:再次提供原始参考图,并要求更贴近参考图中的面部特征。如果这一情节点并不重要,可以改用越肩视角或背面视角。
- 服装发生变化:在修改提示中明确说明夹克的颜色和类型,以及挎包的颜色。避免使用“相同服装”这类模糊指令。
- 多出人物或道具:明确指定人物数量,并指出该镜头所需的唯一道具。
- 醒目但无法读取的文字:为地址或线索预留空间,然后在视频编辑器中添加准确文字,而不要依赖生成的文字。
- 每一帧看起来都一样:回到镜头清单。改变构图或动作,同时保持角色特征不变。
只修改失败的图片,而不是整个序列。如果镜头只需要展示打开信封的双手,就要求生成这样的裁剪画面,不要花时间去匹配观众根本看不到的脸部。
步骤 5 — 将图片剪辑成故事,而不是幻灯片
按照脚本顺序将静帧放入时间线,并对照画面朗读旁白。每张图片都应该回答一个问题,或引出下一个问题。门口镜头交代了投递;特写将注意力引向信封;电影院远景揭示了快递员前往的地点。
使用克制的运动效果,例如缓慢裁剪或平移,引导观众注意静帧中的重点。如果之后使用图像转视频为选定帧添加运动,请让运动服务于叙事节点:夹克在风中摆动,或镜头缓慢靠近电影院入口。在将其插入静帧之间之前,检查快递员的服装和轮廓是否发生变化。
对于信封地址、电影院名称或最后的悬念台词,请在合成时添加可编辑文字。这样可以确保重要的故事信息清晰易读,也方便修改,而不必重新生成图像。
最终检查清单
- 每个镜头都有明确的故事目的和独特的构图。
- 每个重复出现的镜头都使用同一张主角色参考图。
- 整个序列中的头发、夹克、挎包和可见面部特征保持一致。
- 所有重要文字都以可编辑文本的形式添加,而不是交给图像生成。
- 在添加运动或特效之前,先确认整个序列配合旁白能够讲通。
关键词
一致的 AI 角色、无脸故事视频、GPT Image、角色参考图、AI 故事图片、YouTube 故事讲述