创建短剧的最佳 AI 工具:实用工作流
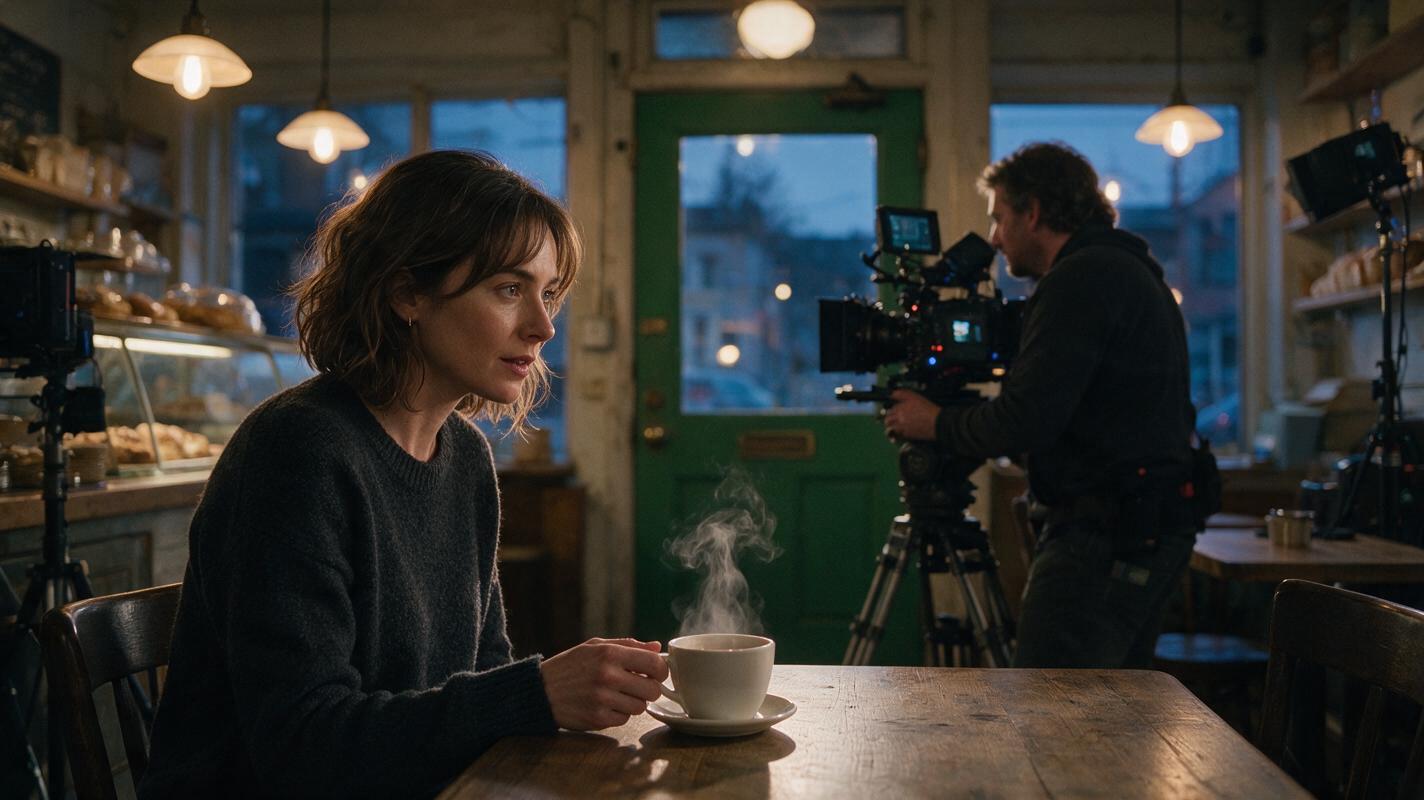
最佳的 AI 短剧方案将策划、参考图生成、受控视频生成、声音制作和传统剪辑结合起来,而不是依赖单一模型。本指南对比实用工具,并展示如何从短剧本推进到连贯性可靠的试播集。
文章目录
简短回答
创建短剧的最佳 AI 工具,是那些能够融入受控制作链的工具:先规划剧集,锁定反复出现的角色,生成经过审核的场景画面,制作短镜头动画,完成对白和声音制作,最后在专用时间线上完成剪辑。
作为一体化起点,ai short drama工作区可以让剧本创作、视觉开发和生成流程更紧密地结合在一起。Runway、Kling AI 和 Luma Dream Machine 都是实用的视频生成选项;Adobe Firefly 支持在更广泛的创意生态中进行图像和视频创作;ElevenLabs 负责声音制作;DaVinci Resolve 则提供细致的剪辑控制。
最佳实用配置:选择一个策划工作区、一个主图像模型、一个主视频模型、一个声音工具和一个剪辑器。在试播集稳定之前添加更多模型,通常只会让连贯性问题更难排查。
哪些 AI 短剧工具最适合不同工作?
| 工具 | 最适合的用途 | 实用能力 | 需要注意 |
|---|---|---|---|
| MagicBoat | 一体化短剧制作 | 免费入门、多种模型,以及在一个工作区中完成从剧本到制作的能力 | 在确定整部系列的视觉方法之前,先测试一个完整场景 |
| Runway | 定向视频生成和后期制作 | 基于参考图的生成、视频工具和编辑功能 | 复杂互动可能仍需要拆分成多个镜头或进行合成 |
| Kling AI | 以图像为基础的电影感镜头 | 支持通过镜头和运动提示词进行文生视频与图生视频 | 在每个剪辑边界检查面部、手部、道具和背景特征是否一致 |
| Luma Dream Machine | 快速视觉探索 | 用于测试运动创意的视频生成和变换工具 | 探索性输出不应自动成为连贯性参考 |
| Adobe Firefly | 代理机构和设计工作流 | 与 Adobe 应用连接的图像和视频生成能力 | 针对每个客户项目,核查当前方案、使用条款和输出内容资格 |
| ElevenLabs | 对白、旁白和声音 | 语音生成、声音设计和音效工具 | 仅使用你拥有必要权利和许可的声音 |
| DaVinci Resolve | 最终剪辑和精修 | 在一个应用中完成剪辑、调色、音频、字幕和交付 | 镜头首尾相接后,更容易发现生成错误 |
没有哪一行工具会自动成为赢家。正确选择取决于你的瓶颈究竟是故事策划、反复出现角色的连贯性、物理运动、对白,还是最终交付。
第 1 步——在生成视频前建立制作资料包
从一个试播场景开始,而不是整季内容。实用的制作资料包应包含剧集目标、演员描述、场景规则、道具状态、服装状态和镜头清单。每个镜头都应传达一个可见的故事事件。
例如,设想一集悬疑剧:Maya 进入一家已经打烊的面包店,发现一只刚被使用过的咖啡杯,并听见有人打开后门。镜头资料包可以包含:
- 镜头 A:Maya 走进店内,注意到房间出乎意料地温暖。
- 镜头 B:特写显示咖啡杯上升起蒸汽。
- 镜头 C:听见门锁声后,Maya 看向后门。
- 镜头 D:门把手开始转动;在访客出现前切断。
将主观文字转化为可见证据。“Maya 感觉到了危险”无法直接演绎,但停下的脚步、收紧的手、转移的视线和转动的门把手都可以。
将下面的场景转换为短剧镜头资料包。
对于每个镜头,返回:
- 一个可见的故事事件
- 角色和道具的连贯性状态
- 构图和摄影机位置
- 起始姿势和结束姿势
- 允许的运动
- 对白或声音提示
- 计划中的剪辑点

让每个生成镜头聚焦于一个动作。
不要虚构新的角色、服装、道具或地点。

场景:
[在此粘贴场景]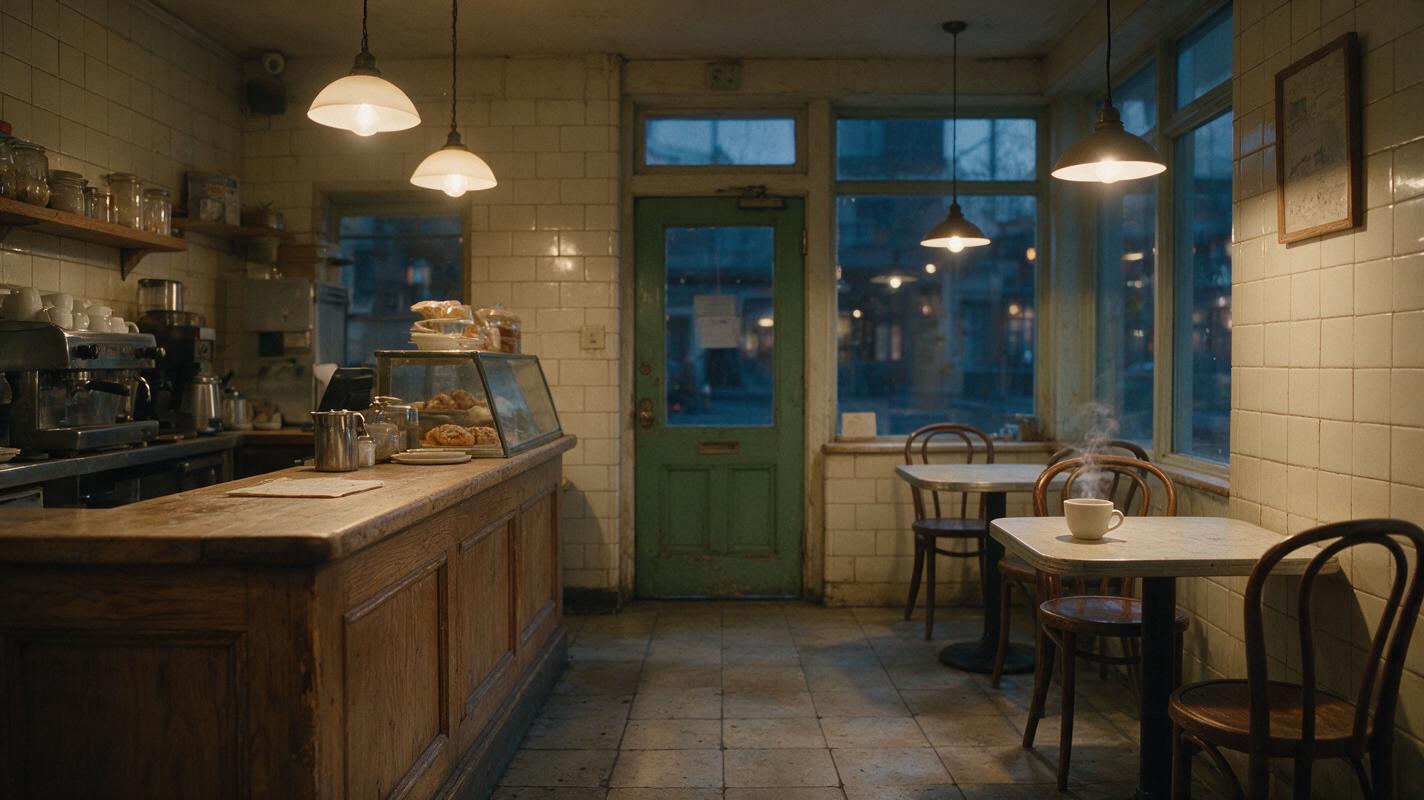
第 2 步——用参考图锁定反复出现的角色
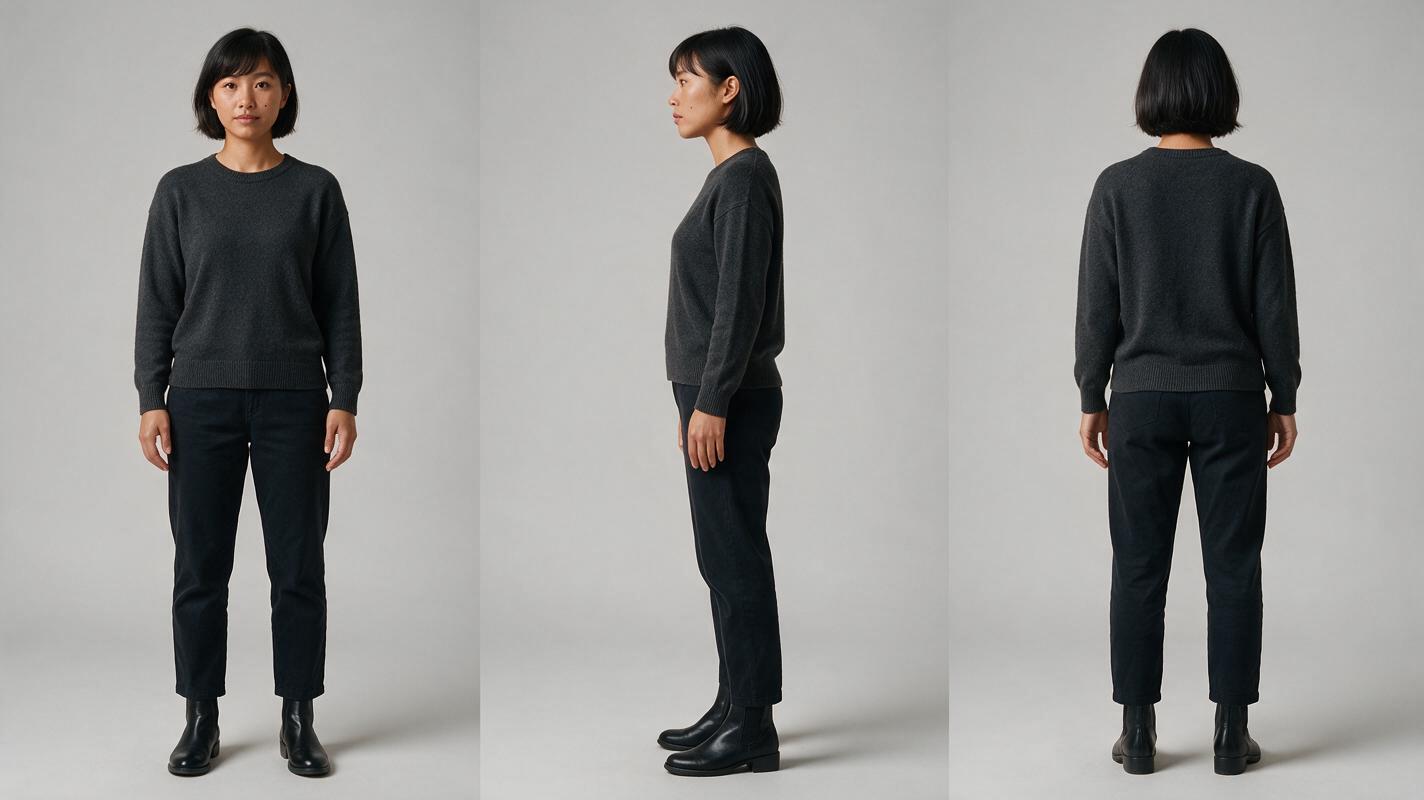
在将主角放入戏剧化场景前,先创建一张中性的参考表。记录应在每个场景中保持一致的身份特征:大致年龄、脸型、头发轮廓、皮肤细节、身体比例和基础服装。不要将临时情绪、光线、天气和摄影机效果加入这张主参考图。
在每次图像生成请求中使用同一张经过批准的参考图。如果工具支持多张参考图,请将角色、服装和场景来源分开,而不是要求一张负担过重的图像定义所有内容。
重现提示词:电影级写实风格的三联角色参考表,角色为 Maya Chen,一名虚构的 31 岁东亚女性,椭圆脸,暖色中等肤色,直至下巴的黑色齐 bob 短发,右侧头发别在耳后,深棕色眼睛,左侧颧骨下方有一颗小痣,中等身材,穿纯炭灰色圆领毛衣、深色直筒裤和黑色短靴;三幅画面中的人物和服装完全相同;全身正面视图、精准侧面视图和全身背面视图;姿势放松中立,双臂自然地与躯干分开,表情中性;中性浅灰色无缝摄影棚背景,柔和均匀的摄影棚照明,准确的解剖结构和面料构造,无道具、无文字、无标志。强制摄影机:视线高度的正投影风格全身参考摄影,70mm 镜头观感,无广角畸变。强制布局:横向 16:9 画布,分为三个等宽垂直面板,顺序为正面、侧面、背面,比例和头顶留白保持一致。
第 3 步——在生成运动前审核场景和镜头画面
在要求生成视频前,先生成一张干净的场景画面和一小组故事画面。这些静帧可以确定构图、美术设计、光线方向、道具位置和画面空间关系,其成本低于反复重新生成完整动态镜头。
对于面包店场景,先审核一张空场景底图。然后制作 Maya 入场画面、咖啡杯特写和后门反应画面。只有相关画面通过连贯性审核后,才使用 image to video流程。
让场景描述简短且可重复使用:
场景锁定——打烊后的面包店
打烊后的狭窄社区面包店。
奶油色瓷砖墙,画面左侧为磨损的橡木服务柜台。
画面右侧有三张无人使用的咖啡桌。
后墙中央是一扇绿色油漆木质后门。
暖色吊灯亮着;店面外是蓝色黄昏。
最近的桌子上放着一只白色陶瓷咖啡杯。
没有顾客,没有员工,没有招牌,没有其他门。重现提示词:电影级编辑写实风格的建立镜头,地点是一家刚打烊不久的小型社区面包店内部;奶油色瓷砖墙,画面左侧为磨损的橡木服务柜台,画面右侧有三张空咖啡桌,后墙中央是一扇绿色油漆木质后门,最近的桌子上放着一只白色陶瓷咖啡杯,杯口升起一缕淡淡蒸汽;暖色吊灯与店面外透入的蓝色黄昏形成对比;表面具有生活痕迹但整洁,实用材质可信,无人物,无可读文字,无标志。强制摄影机:位于前门附近、视线高度的真实四分之三室内视角,35mm 镜头观感,景深足够,使咖啡杯和后门都清晰可辨。强制布局:电影感横向 16:9,柜台固定在左侧三分之一处,咖啡杯位于右下方前景,后门处在中央消失点。
第 4 步——用受限运动生成短镜头
视频提示词应描述随时间发生的变化,而不是重复输入画面中已经确定的每个细节。定义主体动作、摄影机行为、环境运动和最终状态,并限制所有应保持静止的内容。
Maya 小心地走进面包店一步,然后停下。
她的视线从空柜台移向冒着蒸汽的咖啡杯。
她不说话,也不触碰任何物体。
摄影机非常缓慢地向前推进 10 厘米。
只有细微的呼吸、一次自然眨眼和淡淡的蒸汽在移动。
保持她的面部、齐 bob 短发、炭灰色毛衣、身体比例、
桌子位置、咖啡杯形状、后门,以及暖色到蓝色的光线对比。
最后 Maya 保持不动,看着咖啡杯。
如果可能,将互动拆分为不同的覆盖镜头。中景可以承载 Maya 的反应,特写负责咖啡杯,另一个近景负责转动的门把手。这样可以减少模型需要同时解析的身份、四肢和物体数量。
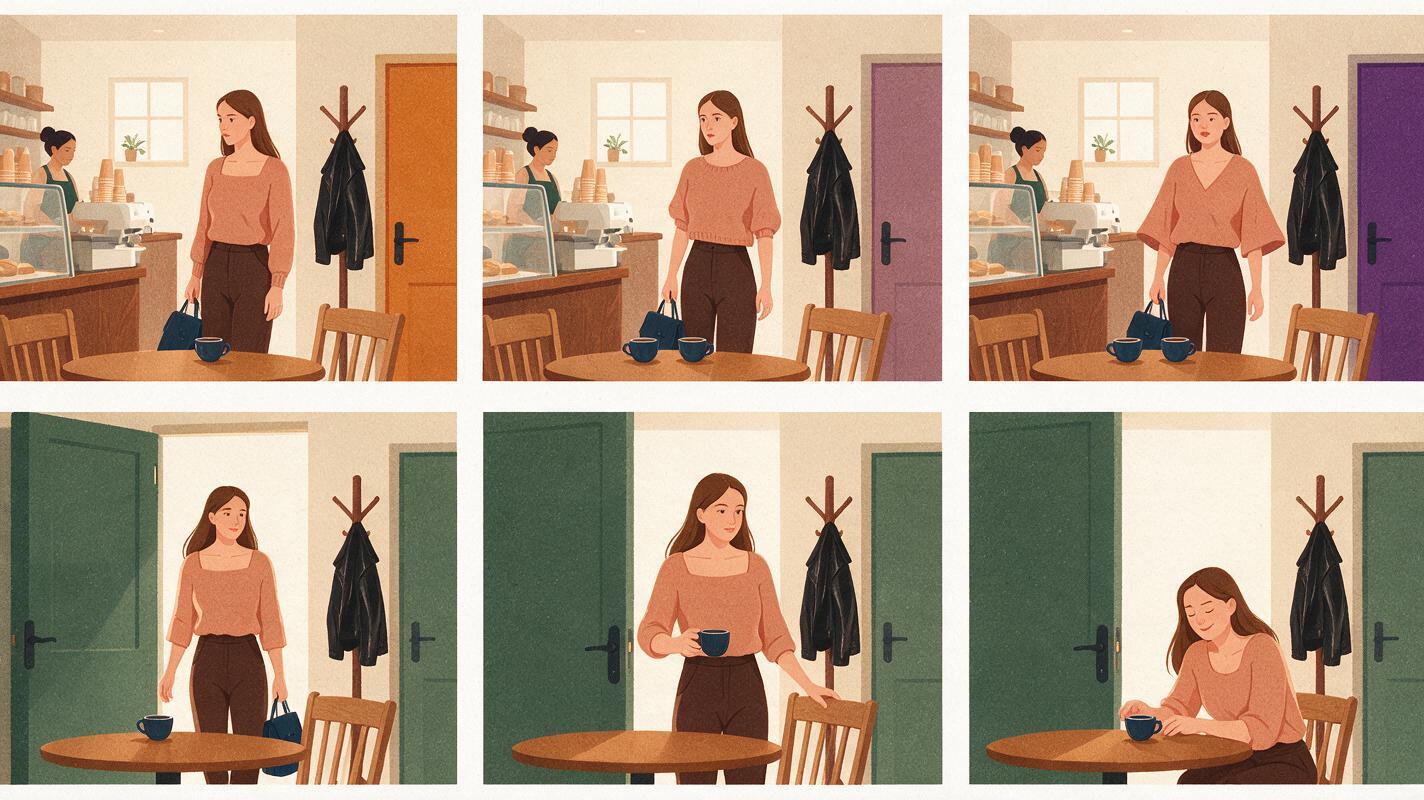
检查每个输出的第一帧、中间帧和最后一帧。即使整体运动看起来很出色,只要身份或故事关键物体发生变形,就应拒绝该镜头。
重现提示词:中性的教学对比画面,展示同一虚构面包店场景的两组电影感镜头序列,上方序列和下方序列各包含三个横向画面;上方序列通过变化的面部身份、重复出现的咖啡杯、漂移的门色和不一致的毛衣形状展示失败;下方序列展示同一个女人、一只稳定不变的咖啡杯、未变化的绿色门、连贯的服装,以及从入场到反应的干净发展;写实电影帧渲染,无界面、无标签、无标志、无文字。强制摄影机:每个嵌入画面均使用视线高度的 50mm 电影感透视,并保持摄影机高度一致。强制布局:横向 16:9 对比画板,均匀排列的上下两行,画面尺寸相同,上排明显不连贯,下排确保连贯性。
第 5 步——在画面节奏稳定后制作对白
临时对白在策划阶段很有用,但最终语音应跟随剪辑完成后的表演。否则,镜头长度会被在视觉节奏形成之前录制的音频限制。
为每个反复出现的角色准备声音简介:
- 声音年龄和大致音域
- 语速和活力
- 在叙事确有需要时使用的口音或方言
- 情绪基线
- 人名和虚构术语的发音说明
- 许可和使用文档
将环境声、拟音和戏剧性音效作为独立素材生成。锁扣声、衣料摩擦声、冰箱嗡鸣和远处的交通声,可以让一个克制的镜头更有意图,而不必强行增加视觉运动。
第 6 步——围绕因果关系剪辑,而不是按照生成顺序剪辑
按照故事顺序排列镜头,并确认每次剪切都保留了因果关系。在面包店场景中,观众应先看到或听到触发事件,再看到 Maya 的反应。咖啡杯特写必须保持足够时长,以传达它刚刚被使用过。门把手镜头的起始画面方向,应与反应镜头中建立的画面方向一致。
一次简洁的审核应检查:
- 身份:Maya 是否始终能被辨认为同一个人?
- 状态:服装、道具、天气和受损状态是否符合当前故事时刻?
- 空间关系:视线方向和入场位置是否与已建立的房间一致?
- 因果关系:每个反应是否都由可见或可听的触发事件推动?
- 边界:相邻镜头的末帧和首帧能否干净地衔接?
- 音频:对白、环境声和音效是否是在支持画面,而不是重复画面?
一个场景通过审核后,将其批准的参考图和提示词模块复用于下一个场景。在这个高意图节点上,你可以免费试用这些模型,并比较一个短试播镜头,然后再选择制作路径。
如何选择而不过度购买
让每套入围方案都运行同一份试播资料包。不要比较彼此无关的展示片段。使用相同的角色参考图、场景、镜头时长、运动请求和验收标准。
| 如果你的主要问题是…… | 优先考虑…… | 试播测试 |
|---|---|---|
| 制作工具彼此割裂,数量过多 | 一体化多模型工作流 | 将一个完整场景从剧本推进到视频和声音 |
| 角色漂移 | 强大的参考图控制能力 | 让同一主角出现在远景、中景、侧面和低光镜头中 |
| 运动缺乏说服力 | 以图像为基础的视频生成和可控摄影机运动 | 测试行走、停下、转身和克制的反应 |
| 对白占比较高的剧集 | 声音控制和干净的音频导出 | 测试两种情绪演绎以及发音一致性 |
| 客户或商业交付 | 清晰的使用条款和团队治理 | 核查当前许可证、许可记录、导出需求和审批角色 |
请直接核查当前价格和条款,因为方案、积分系统、可用模型和商业条件都可能变化。最好的工具,是能够以最少的手动重建,通过你自己的连贯性和交付测试的工具。
常见问题
一个 AI 短片生成器能制作完整的一集吗?
一些平台可以覆盖多个阶段,但可靠的剧集仍受益于对剧本、参考图、场景画面、运动、音频和剪辑分别进行审核。在每个故事节拍和连贯性状态都经过检查之前,应将自动端到端输出视为草稿。
我应该使用文生视频还是图生视频?
文生视频适合探索和非关键插入镜头。当反复出现的角色、确切场景、服装状态或重要道具必须保持可辨识时,图生视频通常更容易控制。
第一次制作应使用多少个视频工具?
从一个主视频模型开始,并为主模型无法解决的镜头保留一个备选方案。小型且有文档记录的流程,比由许多互不相关的视觉系统拼装出的剧集更容易排查问题。
制作系列视频前应该测试什么?
测试一个对白镜头、一个全身运动镜头、一个双人构图、一次道具互动和一次光线变化。在扩大规模前,对比身份、解剖结构、空间关系、运动、可剪辑性和使用条款。
AI 语音可以用于反复出现的角色吗?
可以,但须遵守工具当前的条款,并拥有必要的权利或许可。为每个反复出现的角色保留声音简介、发音指南、情绪基线和经过批准的样音。
来源
- Runway 官方网站
- Kling AI 官方网站
- Luma Dream Machine 官方网站
- Adobe Firefly 官方产品页面
- ElevenLabs 官方网站
- DaVinci Resolve 官方产品页面
最终检查清单
- 根据制作职责选择工具,而不仅仅依据展示质量。
- 在制作多集内容前,先测试一个完整的试播场景。
- 在生成视频前锁定角色、服装、场景和道具参考图。
- 每个镜头使用一个可见事件和一个受限运动计划。
- 在画面剪辑节奏稳定后再生成对白。
- 直接核查当前的许可、授权、价格和商业使用条款。
- 只有在试播集通过身份、因果关系、空间关系和剪辑边界检查后,才扩大制作规模。
关键词
ai short drama, ai short film generator, ai drama generator, ai series video, short drama from script, batch short drama production