Gemini 4 热度遇上创作者现实检验:切换前先测试
Gemini 4 重新激发了创作者对新一代 AI 模型的兴趣,但更新的模型并不一定能自动生成更好的视频。本文提供了一个实用的镜头级框架,帮助你在更换 AI 内容工作流之前评估模型输出。
文章目录
Gemini 4 是测试信号,而不是盲目切换的理由
Gemini 4 已成为最新 AI 模型讨论的一部分,也给创作者带来了重新评估内容工作流背后工具的压力。对于视频创作者而言,真正有用的问题不是最新模型听起来是否更先进,而是它能否将真实需求转化为更清晰的脚本、更完善的镜头规划,以及更一致的视觉素材。
这一点很重要,因为模型可能在广泛演示中表现出色,却仍然难以完成那些决定制作质量的具体任务:在不同场景中保持角色一致、遵循视觉层级、维持预期语调,或编写能够被AI 视频模型可靠理解的提示词。
对于创作者来说,最好的模型是能够减少完整工作流中返工次数的模型,而不一定是名称最新的模型。
一个小型、可重复的创作者基准测试,可能比一长串笼统的宣传更能说明问题。不要立即迁移整个制作流程,而应使用相同的需求、输入、限制条件和输出格式,将 Gemini 4 与你当前使用的模型进行对比测试。
Gemini 4 应在创意工作流中证明什么
通用智能与创作者的实际用途有所重叠,但两者并不完全相同。一个可以用于生产的模型,需要同时理解创意本身以及内容媒介对后续制作的要求。
对于 AI 视频创作,应评估模型能否将宽泛的概念转化为可用的制作产物:
- 需求理解:它能否识别受众、信息、语调、格式和期望行动,同时不遗漏重要限制条件?
- 叙事结构:它能否根据目标时长,将创意转化为适当的开端、发展和结果?
- 镜头设计:每个场景是否描述了可见的动作,而不是模糊的主题或情绪?
- 提示词精确度:主体、环境、运动、构图、光线和连续性细节是否明确?
- 修订控制:当一个元素发生变化时,模型能否保留其他所有内容?
- 格式规范:它能否持续返回符合制作流程的结构化表格、镜头列表或提示词模块?
这正是与 Claude Opus 或 GPT-6 的比较变得更有意义的地方。目标不是评选出一个适用于所有情况的赢家,而是确定哪个模型能以最少的清理工作处理你反复遇到的创意任务。
用于比较 AI 模型的镜头级基准测试
选择一个与你日常发布内容相似的小型项目。一个有用的测试可以是 20 秒的产品故事、竖屏旅行短片、教育类片段,或以角色为主导的社交广告。
向每个模型提供相同的原始需求,并要求相同的交付物。保持提示词中立,避免偏向某个平台所熟悉的回答风格。
为一条 20 秒的竖屏视频制定制作计划。

目标:介绍一款适合早晨通勤者的可重复使用保温瓶。
受众:25–40 岁的城市职场人士。
语调:平静、实用、高端,但绝不夸张。
场景:真实的公寓厨房,随后转到早晨的火车站站台。

请返回:
- 一个简洁的概念
- 一个五镜头序列
- 每个镜头的旁白
- 每个镜头的视觉生成提示词
- 关于保温瓶、服装、光线和时间的连续性说明

避免未经支持的产品声明、屏幕界面图形,以及不可能实现的摄像机运动。
运行提示词时不要添加针对特定模型的提示。随后应将结果作为制作文档进行审阅,而不是作为散文来阅读。如果一段精致的文字让视频生成器无法判断画面中应该出现什么,它就没有实际价值。
根据可观察标准为输出评分
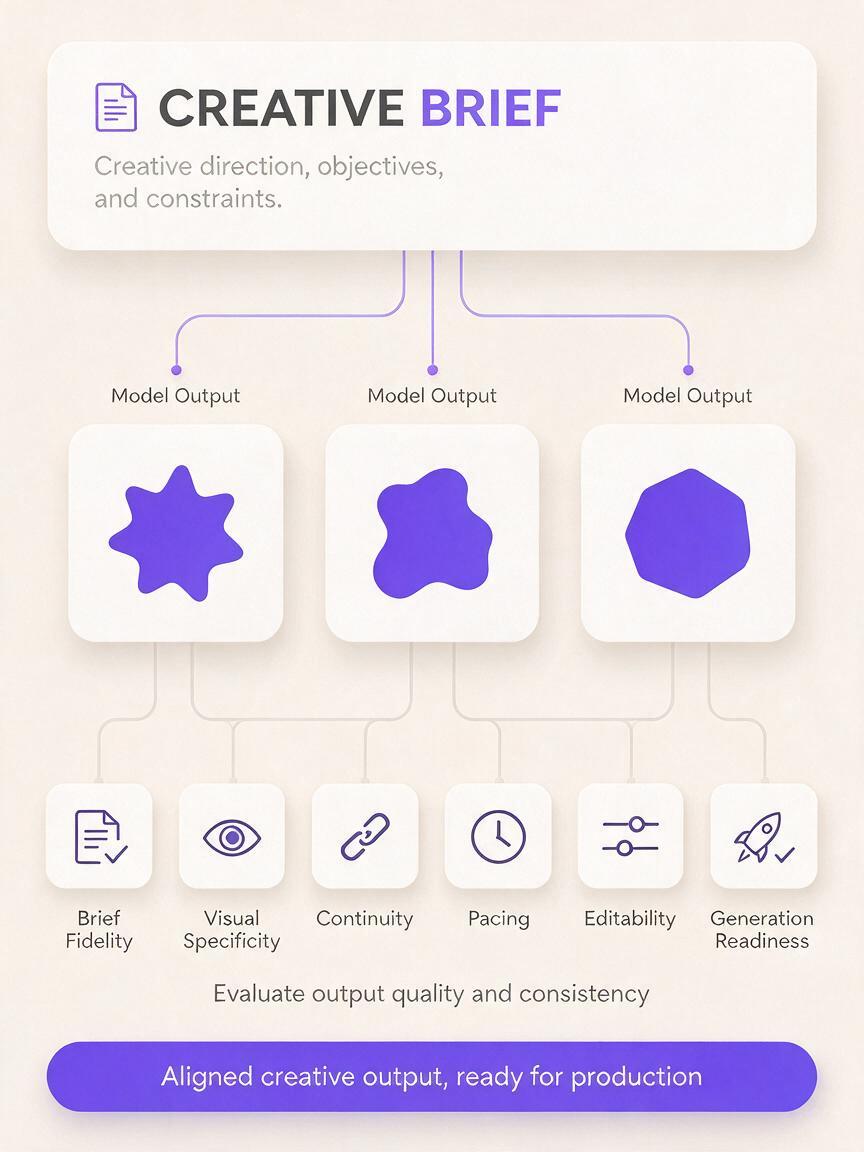
| 标准 | 检查内容 | 常见失败 |
|---|---|---|
| 需求一致性 | 受众、语调、场景、时长和限制条件均保持不变 | 概念加入了未被要求的声明或场景 |
| 视觉具体性 | 每个镜头都明确主体、动作、地点和构图选择 | 提示词依赖“高端生活方式”等抽象表达 |
| 连续性 | 反复出现的物体和人物保持稳定的视觉属性 | 服装、产品颜色、天气或时间发生变化 |
| 节奏 | 镜头数量和复杂程度符合目标时长 | 一个短场景中压缩了过多动作 |
| 可编辑性 | 修改一个镜头时无需重写整个计划 | 局部修改导致无关细节消失 |
| 生成就绪度 | 提示词只需少量改写即可交给视觉工具 | 输出读起来像剧本,却缺少视觉指令 |
简单的三档评分——较弱、可用或较强——通常就足够了。目标不是创建科学排行榜,而是发现会影响实际制作时间的差异。
文生视频与图生视频测试的差异
能够写出有效文生视频提示词的模型,不一定能为图像驱动的动画制作出最佳方案。这两种工作流需要不同类型的控制。
文生视频需要明确的场景构建
对于 text to video,应检查提示词是否定义了完整画面。提示词应明确主体和可见动作,同时确保摄像机运动符合物理规律。
- 主要主体是谁或是什么?
- 镜头过程中发生了什么变化?
- 主体位于什么位置?
- 什么样的构图和摄像机运动能够支持该动作?
- 哪些光线、天气和时间细节必须保持稳定?
提示词并非越密集越好。如果模型加入多个相互竞争的动作、装饰性形容词和相互冲突的摄像机指令,结果可能反而更难控制。
图生视频取决于对源画面的尊重
对于图生视频,源图像已经确定了外观和构图。规划模型应专注于运动、时机和保留原有内容,而不是重新描述或重新设计画面。
一个有用的运动提示词可以指定:杯中的蒸汽缓缓升起,同时摄像机缓慢向前移动。较弱的提示词可能会加入新的家具、改变主体的服装,或要求进行戏剧性的环绕镜头,从而展示源图像中并不存在的环境部分。
将 Gemini 4 与其他模型进行比较时,应要求每个模型根据同一个营销活动概念生成这两种提示词。这样可以看出它是否理解这两种格式背后不同的控制逻辑。
修订测试比初稿更重要
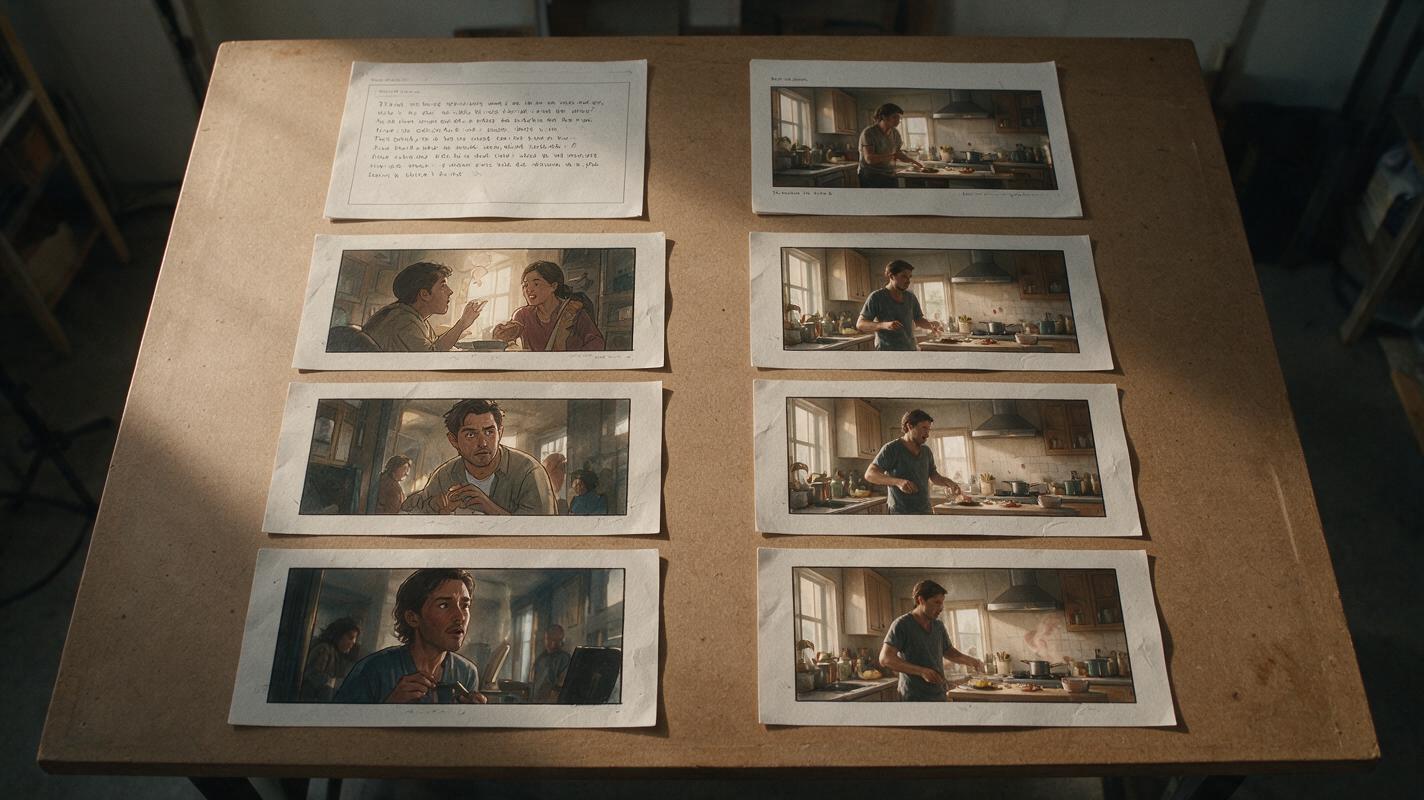
人们大多关注首次输出,但专业内容创作是一个迭代过程。更能说明问题的基准测试,是模型能否处理范围明确的修订,同时不破坏已经通过审核的内容。
生成五镜头保温瓶序列后,尝试提出一个受限请求:
仅修改镜头 3。
将站台的广角画面替换为通勤者把保温瓶放入帆布工作包的特写。
保留已批准的旁白、保温瓶外观、服装、早晨光线、写实语调和总时长。
不要修改镜头 1、2、4 或 5。
逐行比较原始计划和修订后的计划。良好的指令遵循能力应确保无关内容保持不变。如果回答重写了整个概念、改变了产品描述,或未经允许调整了旁白,那么该工作流将需要更多人工版本控制。
再次使用语调调整、更短时长和不同画幅比例进行测试。这些小改动模拟了概念获得批准后日常会收到的修改请求。
从模型输出到 MagicBoat 制作测试
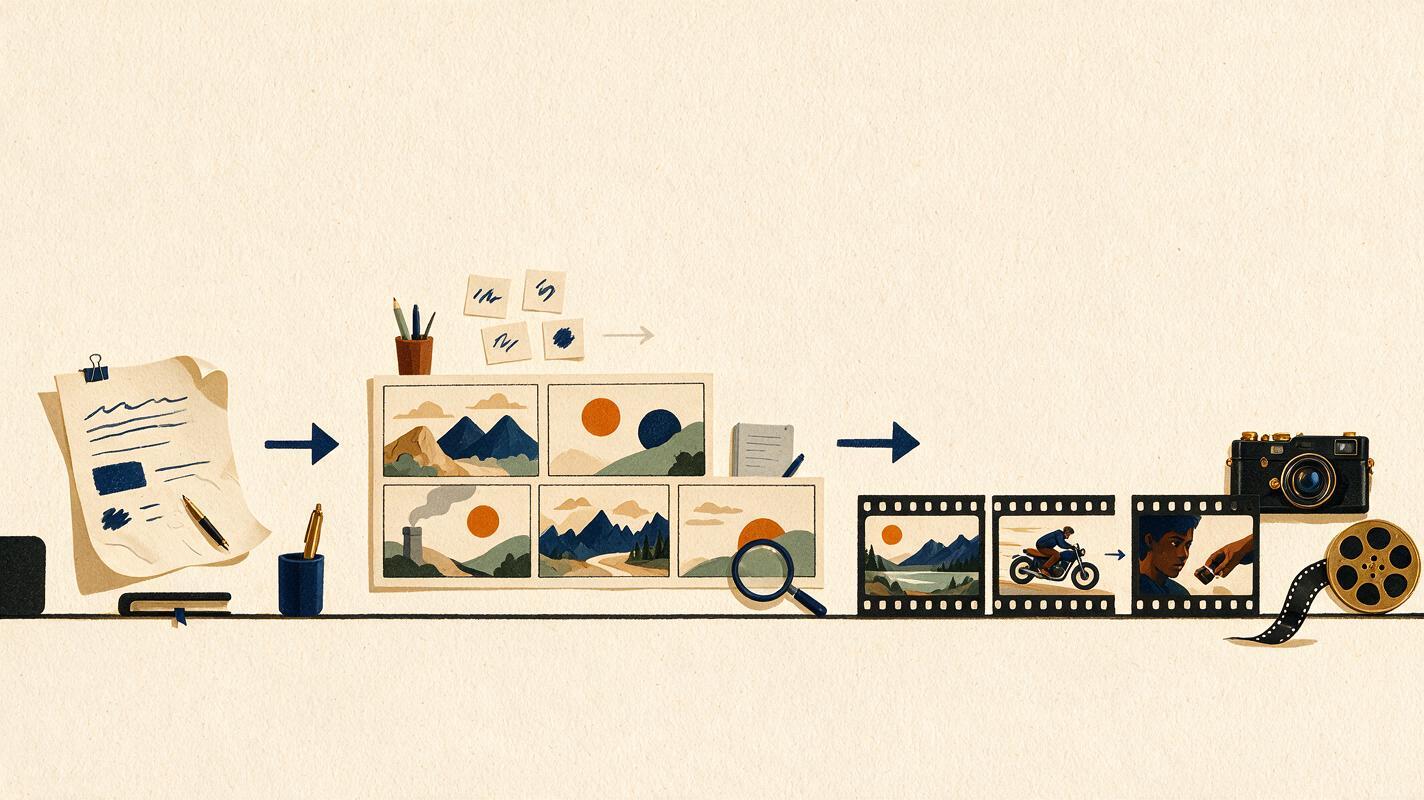
语言模型负责创建计划,但渲染出的媒体才能揭示计划是否有效。下一步是将最强的镜头提示词交给 MagicBoat,比较实际结果,而不是只评判文字。
从少量选择开始:一个建立镜头、一个动作镜头,以及一个对连续性敏感的镜头。它们代表不同的制作挑战,比立即生成整个营销活动更快提供判断依据。
- 使用建立镜头评估构图和氛围。
- 使用动作镜头评估运动和提示词清晰度。
- 使用连续性敏感镜头评估反复出现的视觉细节能否在不同素材中保持一致。
对于图像驱动的项目,应在测试运动变化前创建或选择一个稳定的关键帧。比较 Gemini 4、Claude Opus 或 GPT-6 生成的提示词版本时,保持源图像完全一致。对于文本驱动的生成,只要所选工具支持,就应保留画幅比例和目标时长等设置。
这一从模型推理到渲染输出的衔接,可以避免一个常见错误:仅仅因为规划模型的回答听起来很专业,就选择它。能够生成更干净镜头的简单提示词,比能生成不可预测视觉效果的优雅段落更有用。
使用 MagicBoat 开始下一次 AI 内容测试,在重建工作流之前,通过真实的文生视频和图生视频输出,评估模型编写的概念。
测试后的实际决策
比较结果可能会显示,不同任务的赢家并不相同。一个模型可能更擅长从长篇需求中提取限制条件,而另一个模型可能生成更精炼的视觉提示词,或更忠实地执行修订。
这并不意味着必须进行全盘迁移。混合工作流可以为每个模型分配特定角色:
- 使用最擅长理解需求的模型,识别受众、语调、限制条件和信息层级。
- 使用最擅长视觉规划的模型,将已批准的概念转化为镜头。
- 使用最严谨的编辑模型,处理受限修订和替代版本。
- 通过渲染输出,而不只是文字质量,验证每个最终提示词。
还应考虑多次运行的一致性。如果一个模型生成了一个出色的计划,随后却给出几个结构完全不同的答案,那么它可能很难整合到团队模板中。可靠的格式和可预测的修订,有时比偶尔出现的创意亮点更重要。
关键要点
- 将 Gemini 4 视为对工作流进行基准测试的理由,而不是现有工具的自动替代品。
- 使用相同的需求、限制条件、交付物和输出格式比较模型。
- 评估镜头具体性、连续性、节奏、可编辑性和生成就绪度。
- 分别测试文生视频和图生视频提示词,因为它们需要不同的指令。
- 运行受限修订,衡量已批准内容能否保持稳定。
- 在更改制作流程之前,通过真实的渲染媒体判断规划质量。
来源说明
本文未引用独立的基准测试结果;比较表和提示词构成了一套编辑测试框架,用于在创作者工作流中评估公开宣布的模型更新。
关键词
gemini 4, ai video model, text to video, image to video, ai content creation, claude opus, gpt-6