四家 AI 实验室支持共享 robots.txt AI 训练退出机制
2026 年 11 月中旬,Google、Microsoft、Anthropic 和 OpenAI 共同支持一项共享的 robots.txt 信号 __usage_ai-training。网站运营者只需添加一行配置,即可在四家服务商范围内统一选择退出 AI 模型训练。各家的推出时间表差异很大:Anthropic 已经完成部署,OpenAI 则只承诺“未来几个月”推出;预测市场认为 OpenAI 在 2027 年 3 月 31 日前遵守该信号的概率为 56%。这项自愿承诺仅涵盖训练用途,不包括检索或实时抓取;同时它尚未成为 IETF 正式标准,也将对管理 AI 工作流和内容所有权的创作者产生影响。
文章目录
什么是共享 AI 训练退出信号
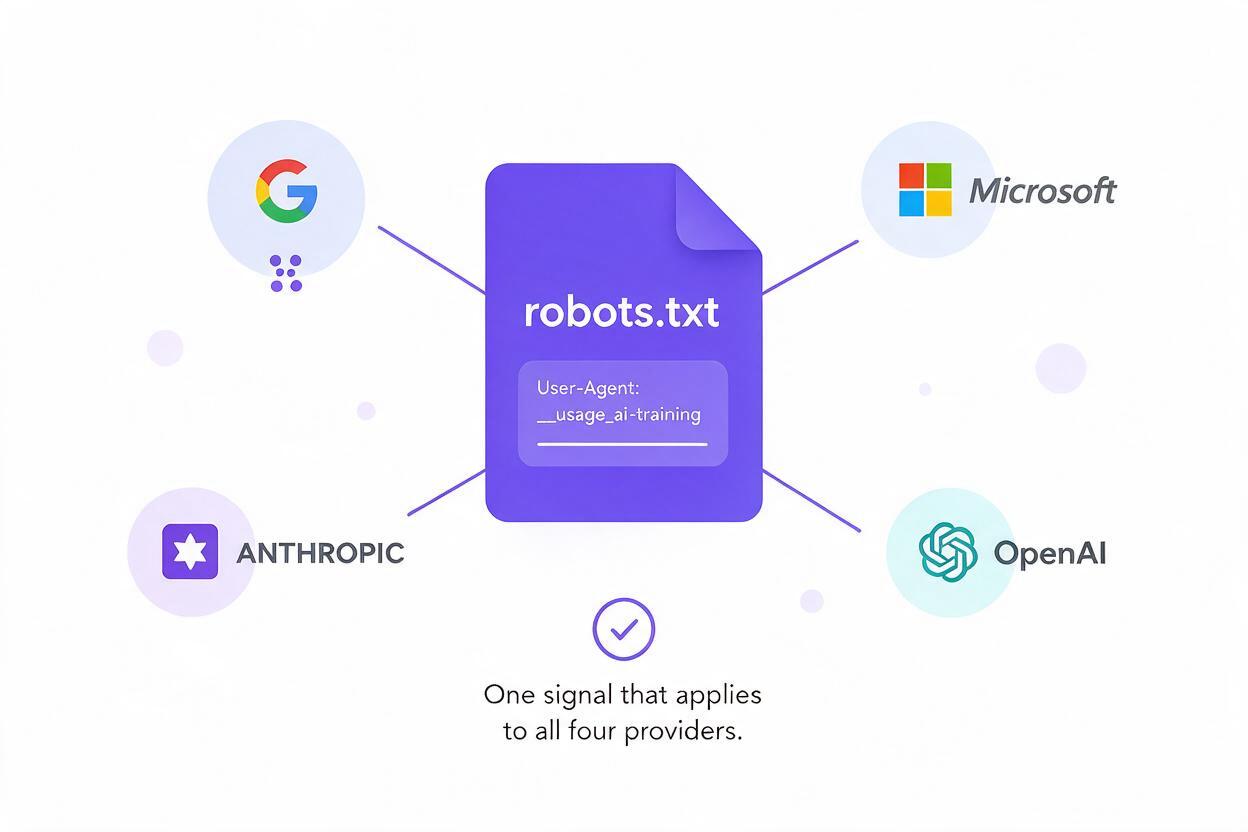
2026 年 11 月中旬,四家领先的 AI 实验室——Google、Microsoft、Anthropic 和 OpenAI——共同支持了一项用于退出 AI 训练的统一共享 robots.txt 信号,标志着整个行业朝着内容控制标准化迈出了重要一步。该信号名为 __usage_ai-training,定义于一份日期为 2026 年 10 月 30 日的 IETF 个人草案中,目前还不是正式采用的标准。网站运营者可以在 robots.txt 文件中添加一行配置,从而在所有签署方服务商范围内拒绝将内容用于 AI 训练,而不必为每家服务商的爬虫分别维护规则。
根据随支持声明一同发布的对比信息,四家实验室对该信号的推出时间差异显著。Anthropic 已经部署了对该信号的支持,Microsoft 则确定了 2027 年 2 月 1 日这一硬性日期,届时其 Bing 爬虫将遵守该信号。Google 的目标是在 2027 年初实施,而 OpenAI 仅承诺“在未来几个月内”推出。截至 11 月中旬,OpenAI 的 GPTBot 文档尚未列出 __usage_ai-training 令牌;预测市场认为 OpenAI 在 2027 年 3 月 31 日前遵守该信号的概率约为 56%。OpenAI 强调,对于已经配置自定义退出规则的用户,现有 GPTBot 控制措施仍然完全有效。
这项承诺也附带重要限制。它是一项自愿协议,没有执法机制,也没有针对不合规行为的处罚。该信号仅涵盖 AI 训练用途,不包括实时 AI 代理查询中的内容检索、实时浏览或搜索引擎抓取。这份草案仍属于 IETF 的个人提交,并非 IETF 或 W3C 等机构制定的正式标准。
该信号如何融入更广泛的 AI 代理生态
共享训练退出信号的出现,正值 AI 代理和 AI 自动化工具日益普及之际,也引发了人们对内容如何在公共网站与 AI 系统之间流动的新思考。多年来,网站运营者一直依靠针对不同爬虫的指令来屏蔽搜索引擎和特定 AI 机器人,但碎片化的生态让网站所有者很难跟上新的模型服务商和代理框架。
区分训练退出机制与实时访问控制非常重要。__usage_ai-training 信号只能控制内容是否被用于训练未来的 AI 模型,不能控制 AI 助手或 AI 代理是否能够实时访问内容,以回答用户查询、完成任务或获取实时数据。对于担心 AI 代理访问其内容的创作者和网站所有者来说,仍然需要 robots.txt 之外的其他控制措施,因为当前标准并未覆盖检索场景。
签署方包括许多使用最广泛的企业级和消费者 AI 工具背后的开发者,从 Claude(Anthropic)到 GPT 模型(OpenAI),再到 Gemini(Google)和 Copilot(Microsoft)。即使只是将内容控制体系中的一个环节标准化,也能减少网站所有者的管理负担,并为未来围绕 AI 工作流和内容治理展开合作树立先例。
这对使用 AI 工具的内容创作者意味着什么
对于搭建 AI 工作流管线的独立创作者和内容团队而言,共享退出信号为不断发展的 AI 内容生态带来了更清晰的方向和背景。无论你是依赖AI 视频生成器制作短篇社交媒体内容,使用AI 图像生成器创作概念艺术和缩略图,还是使用基于文本的 AI 工具进行脚本编写和研究,训练控制标准化都会影响整个创意 AI 生态。
如果你在个人网站、作品集或博客上托管自己的内容,那么这项新信号意味着,只需添加一行配置,就能在四家主要实验室范围内统一退出训练,而不必分别查找并添加 GPTBot、Google-Extended、ClaudeBot 和 BingBot 的规则。这为希望更好地控制原创作品如何被用于训练商业 AI 模型的创作者简化了内容管理。
对于使用 AI 工具而非托管内容的创作者来说,这项声明表明,各大实验室正在回应人们对训练数据透明度和内容所有权的担忧。虽然该信号是自愿的,且仅限于训练用途,但它代表着整个行业正朝着更加一致、更有利于创作者的控制机制发展——这一趋势可以减少围绕 AI 生成内容的版权和合理使用问题所带来的不确定性。
这也提醒我们,AI 工具生态仍然高度碎片化。不同服务商以不同速度推出功能,并遵循不同标准;使用统一的多模型平台,可以帮助创作者及时掌握变化,而不必管理数十个独立账户和政策更新。
核心要点
- Google、Microsoft、Anthropic 和 OpenAI 已支持用于退出 AI 训练的共享
__usage_ai-trainingrobots.txt 信号。 - 推出时间差异很大:Anthropic 已经上线,Microsoft 承诺于 2027 年 2 月推出,Google 的目标是 2027 年初,而 OpenAI 只有含糊的“未来几个月”时间表。
- 该信号是自愿的,没有执法机制,且仅涵盖训练用途,不包括实时抓取、检索或 AI 代理访问。
- 对于运营自己网站的创作者来说,这条统一标准配置简化了在四家主要模型服务商之间设置退出规则的流程。
- 多模型创意平台让你能够使用多家领先服务商的工具,同时跟进行业标准的不断变化。
如果你想了解一个将 AI 视频、图像和脚本工具整合到统一界面中的多模型创意平台,欢迎立即免费试用这些模型。
关键词
AI 训练退出,robots.txt,__usage_ai-training,OpenAI 安全,AI 代理,AI 工作流,Claude,Anthropic