Google 发布 TPU 8tx 和 TPU 8i Max 第八代 TPU
2026 年 11 月 9 日,Google 发布了 TPU 8tx 和 TPU 8i Max,这是其今年推出的第四款和第五款第八代 TPU。两款产品均基于现有芯片,通过优化封装和软件实现性能提升。8tx 引入了硬件级机密计算,可对使用中的模型权重进行加密;8i Max 则将计算能力和内存翻倍,以支持长上下文智能体解码,同时配套提供集成智能体工具的开源软件栈。对于 AI 视频和图像创作者而言,此次发布意味着 Google 支持的 Gemini 4 等模型将拥有更快、更安全的推理能力,也进一步凸显了多模型平台的价值——通过一个平台聚合最新的 AI 工具。
文章目录
Google 新推出的 TPU 8tx 和 8i Max:你需要了解的内容
Google 最新推出的第八代 TPU 在无需重新流片的情况下,带来了硬件级安全性和翻倍的长上下文性能,表明 Google 正转向优化现有 AI 芯片设计,以满足现实世界中的智能体和多模态工作负载需求。
2026 年 11 月 9 日,Google 揭晓了第八代 TPU 产品线的两款新成员:TPU 8tx 和 TPU 8i Max。这两款产品分别是 Google 今年推出的第四款和第五款第八代 TPU。值得注意的是,两款芯片都无需重新流片,而是使用现有的第八代 TPU 裸片,并通过优化封装、配对方式和软件,针对特定的高需求工作负载进行优化。
此次发布正值 AI 实验室和云服务提供商日益重视长上下文智能体工作流,以及面向企业和政府客户的安全推理之际。相关性能提升最终也将惠及视频和图像创作者使用的面向消费者的 AI 工具。
TPU 8tx 和 TPU 8i Max 的关键硬件规格
两款新 TPU 面向不同的使用场景,其硬件分别针对现代 AI 工作负载中的不同重点领域进行了调优:
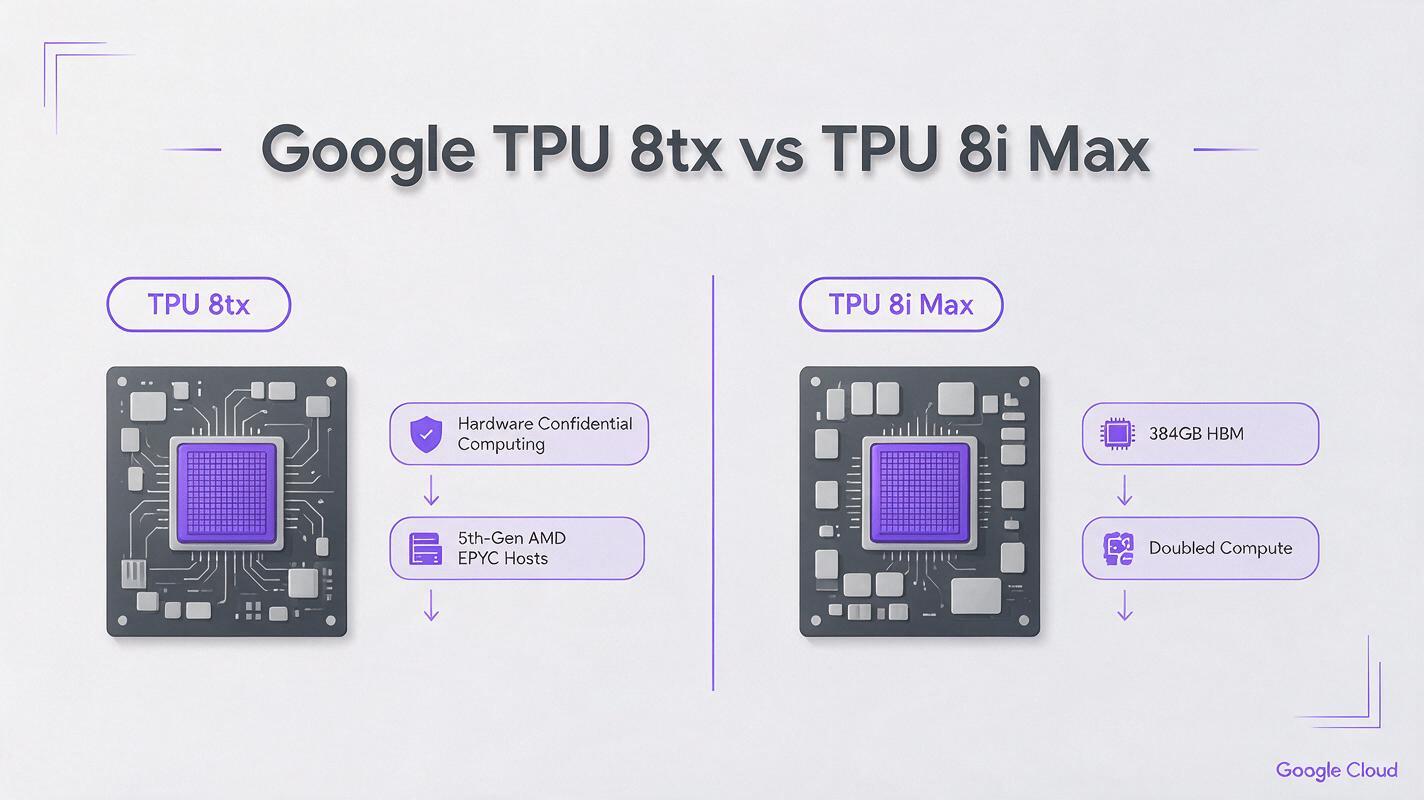
TPU 8tx:硬件级机密计算
TPU 8tx 是 Google 首款内置硬件机密计算功能的 TPU,旨在确保模型权重即使在推理运行期间也处于加密状态。主要信息包括:
- 搭配第五代 AMD EPYC 主机处理器
- 采用 PCIe 链路加密、加密证明和安全内存区域,全程保护权重和数据
- 延迟最高可降至现有 TPU 8t 的一半,同时加密功能几乎不会带来额外的安全开销
这使 8tx 非常适合企业和政府使用场景,尤其适用于必须在处理过程中持续保护敏感数据或专有模型权重的场景。
TPU 8i Max:翻倍的长上下文性能
TPU 8i Max 专为长上下文智能体解码而打造。随着 AI 模型处理更长的提示词、多步骤智能体任务和大型多模态输入,这类工作负载的需求不断增长。主要规格包括:
- 在一个单元中封装两个 8i 裸片,使计算能力、片上 SRAM 和 HBM 带宽翻倍
- 配备 384GB HBM 内存,带宽达到 17.2TB/s
- 配备 768MB 片上 SRAM,可快速访问频繁使用的数据
翻倍的内存和带宽可减少处理长上下文窗口时的瓶颈,这对于需要从大型文档集合中提取信息或生成长篇输出的智能体工作流至关重要。
开源软件栈和智能体工作流优化
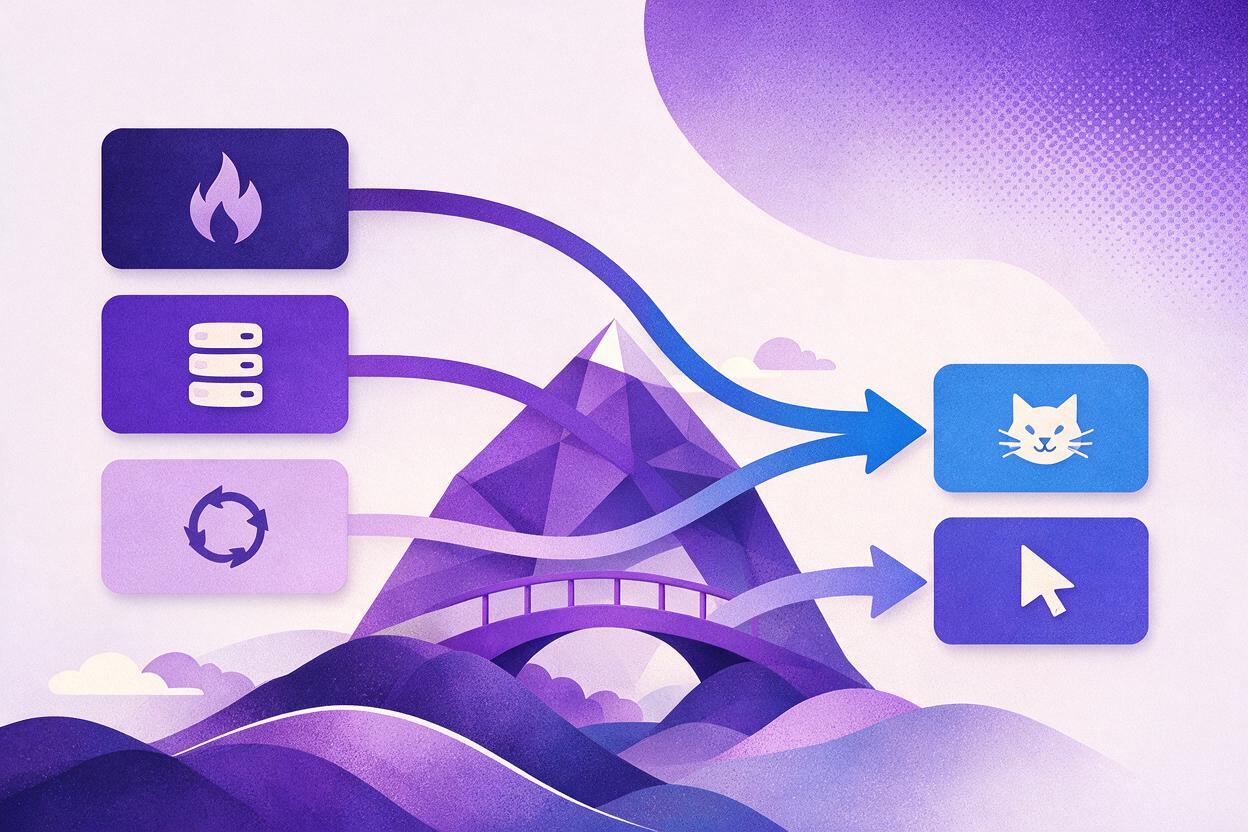
在发布新硬件的同时,Google 还宣布推出经过扩展的开源软件栈,针对智能体和高吞吐推理工作负载进行了优化,旨在让开发者更轻松地在 TPU 上运行模型:
- TorchTPU:面向 TPU 的开源 PyTorch 集成,简化已经采用 PyTorch 工作流的团队进行模型部署的过程
- TPU Agent Suite:为 Claude Code、Cursor 和 Antigravity 等热门智能体工具提供预构建集成
- XLA Serving Engine:针对 TPU 推理优化的开源服务层
- TPU Sync:一项据称可将 KV 传输延迟和首 Token 延迟降低 90% 以上的技术,这是实现响应迅速的智能体和多模态交互的关键指标
Google 表示目前拥有近 100 家外部 TPU 客户,新款 8tx 和 8i Max 预计将于 2027 年出货。截至发布时,官方尚未公布价格或面向公众提供服务的日期。
这对 AI 视频和图像创作者意味着什么
虽然 TPU 硬件在云端 AI 服务的幕后运行,但 8tx 和 8i Max 的改进将对使用 Google 支持的 AI 工具的创作者产生切实影响,其中包括运行在 Google TPU 基础设施上的 Gemini 4 等模型。
TPU Sync 和 8i Max 扩展的内存可降低首 Token 延迟,这意味着在启动文本生成视频或图生图工作流时,等待时间会更短。对于需要反复制作同一视频片段或图像多个版本的创作者而言,更快开始生成意味着在相同时间内可以进行更多轮反馈和优化。
8i Max 对更长上下文的支持,也将解锁更复杂的创意工作流:处理完整的长篇剧本以制作分镜,生成数分钟时长且视觉风格保持一致的扩展视频片段,或分析大型品牌资产参考库,以确保输出符合规范。随着 Google 将新 TPU 部署到其云服务和消费者服务中,任何使用基于 Google 模型栈构建的ai 视频生成器的用户都将获得这些性能提升。
对于处理未发布知识产权、品牌宣传活动或敏感客户资产的专业创作者和工作室而言,8tx 的机密计算功能尤其重要。在加密硬件上运行生成任务,可以降低专有资产在推理过程中暴露的风险,为高风险创意项目增加一层安全保障。
对于在不同提供商之间使用多种 AI 工具的创作者而言,这些由硬件驱动的性能提升凸显了统一多模型平台的价值。无需分别跟踪六七个 AI 服务的性能更新和价格变化,MagicBoat 这样的平台可以让你通过一个账号访问 Google、OpenAI、Anthropic 等提供商的最新模型,从而在速度和质量提升推出后立即享受这些改进。
接下来值得期待什么
由于计划于 2027 年出货且尚未公布价格,TPU 8tx 和 8i Max 的完整影响将在未来一年逐渐显现。企业和政府客户可能会率先获得使用权限,而性能提升将在 2027 年逐步传导至面向消费者的 AI 工具。
Google 对智能体工作负载和长上下文解码的关注,与 AI 内容创作领域的整体趋势一致。如今,多步骤智能体工作流正越来越多地用于处理从剧本创作、分镜制作、配音生成到视频剪辑等端到端任务。随着 TPU 硬件不断改进以支持这些更长、更复杂的工作流,创作者可以期待功能更强大的 AI 工具,帮助处理制作流程中更多环节。
更高效的推理硬件通常也会随着时间推移带来更低的模型使用价格,这可能降低 AI 视频和图像生成工具的成本,尤其是对于每月生成数十甚至数百个素材的高产创作者而言。
关键要点
- Google 于 2026 年 11 月 9 日发布了 TPU 8tx 和 TPU 8i Max,这是其今年推出的第四款和第五款第八代 TPU,且无需重新流片。
- TPU 8tx 增加了硬件级机密计算功能,可在使用期间保持模型权重和数据加密,延迟最高可降至 TPU 8t 的一半。
- TPU 8i Max 将计算能力、内存和带宽翻倍,用于长上下文智能体解码,配备 384GB HBM,带宽达到 17.2TB/s。
- 配备智能体工具集成且可将首 Token 延迟降低 90% 以上的开源软件栈,将让开发者更轻松地在 TPU 上构建快速、响应灵敏的 AI 工具。
- 对于 AI 视频和图像创作者而言,此次发布意味着未来一年中,Google 支持的 Gemini 4 等模型将拥有更快的生成速度、更长的上下文支持和更高的安全性。
- 在 MagicBoat 上免费试用这些模型,通过一个账号访问多个提供商提供的最新 AI 创意工具。
关键词
google tpu 8tx, google tpu 8i max, gemini 4, ai 视频模型, 文本生成视频, 图像生成视频, ai 推理硬件