Gemini 4 Argon 在 ARC-AGI-3 基准测试中得分 97.5%
2026 年 10 月 19 日的一项更新显示,Google 的 Gemini 4 Argon 前沿模型在 ARC-AGI-3 基准测试中取得了 97.5% 的成绩,标志着该模型快速推出过程中的最新里程碑。这一结果正值竞争激烈的前沿 AI 格局发生更广泛转变之际:Google 与 Meta 的联合发力已经终结了 OpenAI 和 Anthropic 此前绝对领先的局面。对于内容创作者而言,这一更新凸显了前沿模型不断增强的能力,同时也再次说明了灵活、多模型生产工作流的价值。
文章目录
Gemini 4 Argon 最新基准测试报告的内容
2026 年 10 月 19 日,一项最新更新显示,Google 的 Gemini 4 Argon 前沿模型在 ARC-AGI-3 基准测试中取得了 97.5% 的成绩。这一公告标志着 Gemini 4 Argon 模型的最新里程碑。过去一周,该模型已面向不同用户群体快速推出,访问范围不断扩大,并以较快速度增加新功能。
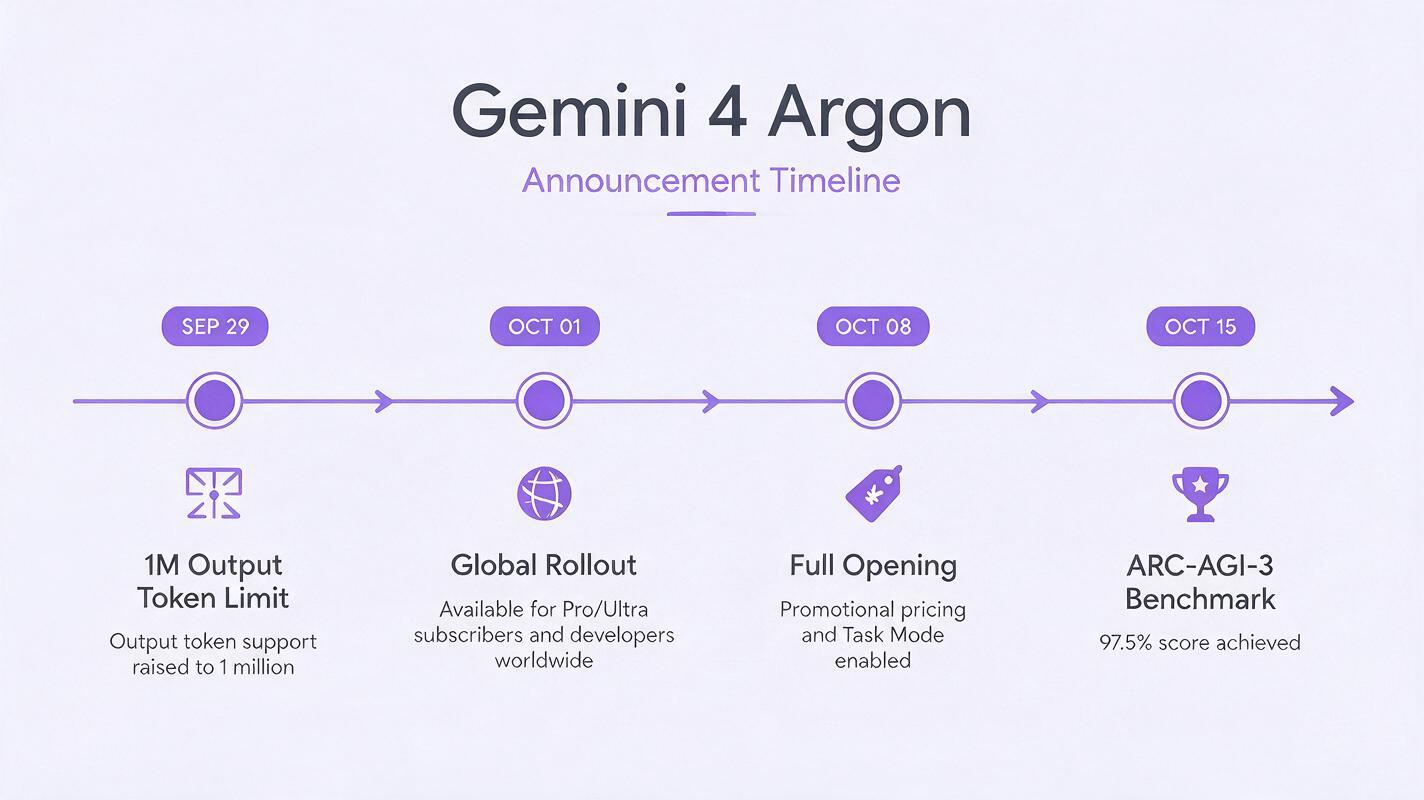
就在五天前的 10 月 14 日,Google 面向 Pro 和 Ultra 订阅用户,以及基于 Gemini API 开发应用的开发者,在全球范围内推出了 Gemini 4 Argon。次日,即 10 月 15 日,该模型面向符合条件的用户全面开放,促销价格设定为每百万输入 token 2 美元、每百万输出 token 10 美元,同时推出了全新的 Task Mode 功能,专为专注于单一目标的工作负载而设计。该模型还支持 100 万 token 的输出窗口,这一能力最早于 2026 年 9 月下旬得到详细介绍。
97.5% 的 ARC-AGI-3 成绩,是 Gemini 4 Argon 全面发布以来公布的首批备受关注的公开基准测试结果之一。尽管初始报告尚未披露评测设置、提示词格式以及直接对比的模型组等具体细节,但对于那些评估前沿模型在真实应用场景中能力的团队而言,这一成绩仍然是一个值得关注的数据点。
这一结果如何融入前沿 AI 竞赛
Gemini 4 Argon 的基准测试更新发布之际,主要供应商接连公布前沿 AI 进展,竞争格局因此发生了显著变化。2026 年 10 月 16 日的一项分析认为,Google 与 Meta 在前沿领域的联合发力已经终结了 OpenAI 和 Anthropic 此前的绝对领先地位;四家供应商持续发布新模型和性能更新,正体现了这一变化。
在 Gemini 4 Argon 基准测试报告发布的同一天(10 月 19 日),OpenAI 发布了两个开放权重模型 GPT-OSS-120B 和 GPT-OSS-20B,标志着其首次大举进入开放权重模型领域。NVIDIA 也于 10 月 19 日公布了 Nemotron 3.5 Super VL 和 Bolt 本地智能体模型,进一步扩大了可用于不同部署环境的前沿能力模型范围,覆盖从云端 API 到本地设备的多种场景。
Meta 于 10 月 12 日推出了 Muse Wonder 前沿模型,其定价是竞品模型的两倍;与此同时,Anthropic 也持续更新 Claude 模型系列,推出低成本的 Claude Haiku 5.5,并扩展企业和政府功能。新模型发布和基准测试更新的频率,凸显了前沿 AI 生态系统的发展速度之快。各家供应商不仅在原始基准测试性能上展开竞争,也在上下文窗口大小、价格和专用任务模式等实用功能方面角力。
这对内容创作者意味着什么
对于内容创作团队而言,Gemini 4 Argon 获得的这类高基准测试成绩,表明 AI 工具处理复杂创意任务的潜力正在不断提升。具备强大通用推理能力的前沿模型,可以支持更广泛的创意工作流,包括撰写长篇视频脚本、生成详细的视觉概念、提供编辑辅助、进行受众定位分析,甚至实现跨平台内容改编。
不过需要注意的是,基准测试成绩并不总能直接转化为真实世界中的创意产出质量。在标准化推理测试中表现出色的模型,可能难以完成某些具体的创意任务,例如在视频系列中保持角色设计的一致性、匹配品牌独特的语气,或制作视觉连贯的长篇内容。评估模型是否适合创意用途的唯一可靠方式,是使用你自己的提示词和质量标准,在确切的工作流中进行测试。
这正是 MagicBoat 这样的多模型平台能够发挥明显价值的地方。团队无需为每一个新推出的前沿模型分别管理账号、计费方案和工作流集成,而是可以通过一个统一界面访问各种 AI 工具。你可以在不同模型之间测试 AI 视频生成器的能力,比较 AI 图像生成器的输出是否符合品牌一致性,还可以在无需切换多个服务的情况下迭代脚本和分镜。随着 Gemini 4 Argon 等新模型发布和更新,你可以立即将它们与现有工作流工具进行对比测试,而无需中断生产流程或重构整个工作体系。
模型发布速度不断加快,也意味着依赖单一供应商可能带来不必要的工作流风险:模型可能发生变化、暂时无法使用,或调整价格结构。多模型方案让你可以在不同工具之间切换,为每项任务找到最合适的工具,同时将创意资产、提示词和项目历史集中保存在一个地方。你可以免费试用这些模型,了解不同前沿模型在你的具体创意项目中的表现。
要点总结
- 据 2026 年 10 月 19 日的一项更新,Google 的 Gemini 4 Argon 模型在 ARC-AGI-3 基准测试中取得了 97.5% 的成绩,标志着这款近期推出的前沿模型实现了最新里程碑。
- 这一结果正值前沿 AI 格局发生更广泛转变之际,Google 和 Meta 的联合投入已经终结了 OpenAI 和 Anthropic 此前的绝对领先地位。
- 基准测试成绩是评估模型能力的有用起点,但无法保证模型在特定创意任务中表现出色——始终有必要结合你自己的工作流和质量标准进行直接测试。
- MagicBoat 这样的多模型 AI 平台可以让创作者在新模型发布时立即进行测试,比较不同工具的输出,并在无需管理多个供应商账号的情况下维持稳定的生产工作流。
关键词
Gemini 4 Argon, ARC-AGI-3, AI 新闻, AI 资讯汇总, AI 工具, 前沿 AI, AI 模型基准测试