Meta 从商业条款中删除 AI 训练网页抓取相关措辞
Meta 已从其商业条款中删除 AI 训练网页抓取相关措辞,该变更于 10 月 30 日生效,此前出版商和法律专家曾对此提出抗议。该公司表示,其网页抓取原本仅用于广告和商业产品,并且 robots.txt 协议仍然规定着对公共网站的访问方式。这一政策转变反映出业界对 AI 训练数据实践日益增长的审查,也将对内容创作者和更广泛的 AI 生态系统产生影响。
文章目录
Meta 的商业条款刚刚发生了什么变化
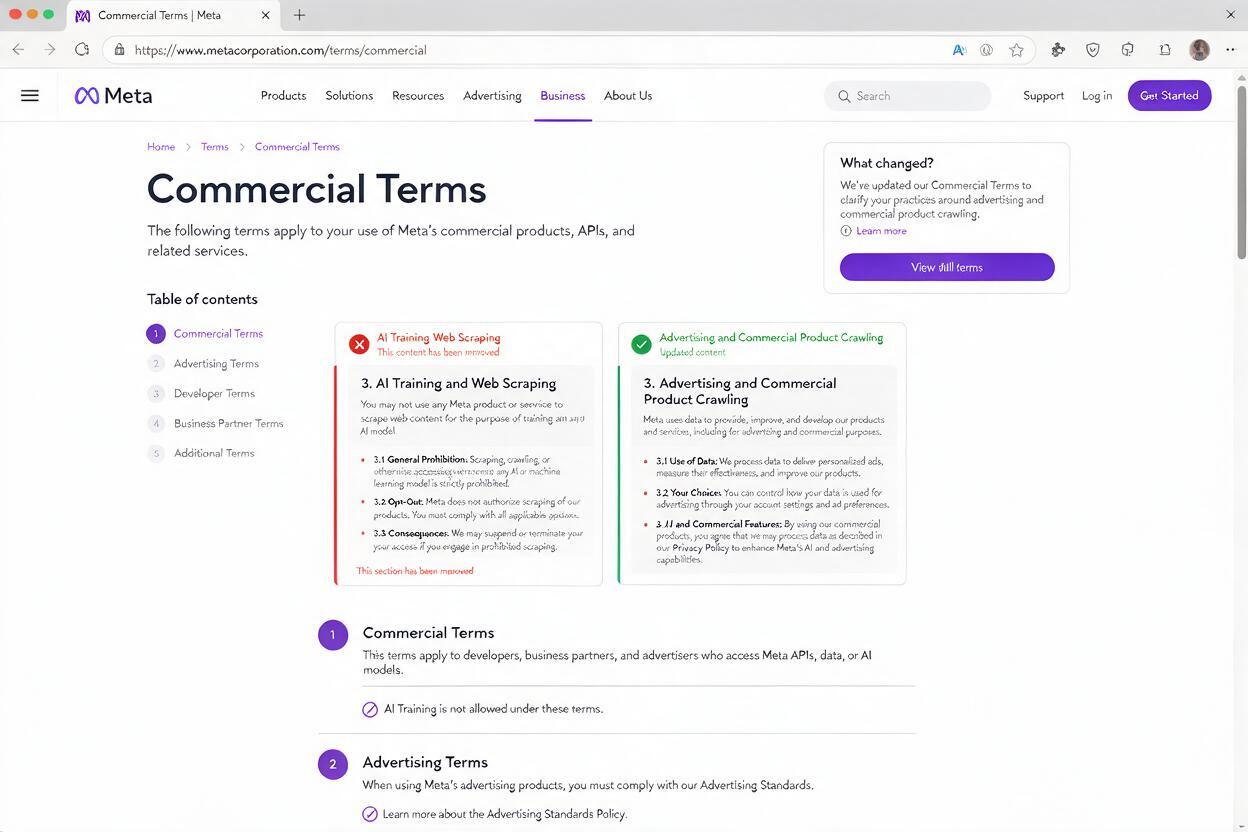
Meta 已从其商业条款中删除涉及 AI 训练网页抓取的措辞,该变更将于 10 月 30 日生效。这项政策更新是在出版商和法律专家广泛抗议之后作出的,他们担心这些条款赋予 Meta 过于宽泛的权利,使其能够抓取网页内容用于 AI 模型开发。The Verge 最先报道了这一变化,并指出,被删除的措辞一直是媒体组织和版权倡导者争议的焦点。
面对反弹,Meta 澄清称,根据商业条款,其网页抓取实践从未被用于 AI 训练,抓取行为仅旨在支持广告和其他商业产品。该公司还强调,robots.txt 协议仍然规定其爬虫如何访问公共网站,网站所有者可以自行决定是否阻止或限制访问。
为什么现在会发生这一转变
删除 AI 训练抓取相关措辞之际,正值围绕数据来源实践对 AI 公司施加的法律和监管压力不断扩大。出版商越来越多地反对在没有补偿或明确许可的情况下使用其内容训练生成式 AI 模型,由此在多个司法管辖区引发了一系列诉讼和政策讨论。
法律专家曾指出,Meta 的商业条款尤其存在问题,他们认为其中宽泛的措辞可能被解读为赋予该公司使用几乎任何公共网页内容进行 AI 训练的权利,而不论版权规定或网站所有者的意愿如何。各方反对意见迫使 Meta 澄清其立场,并修改条款以避免争议进一步扩大。
对 AI 行业的更广泛影响
这一政策转变并不只是某一家公司的更新——它反映出整个 AI 行业正在重新审视数据所有权和合规问题。尽管 AI 资本支出正在激增,Goldman Sachs 预计五大云巨头的 AI 支出明年将增长超过 50%,达到 1.2 万亿美元,但各家公司在获取训练先进模型所需数据的方式上正面临越来越多的限制。
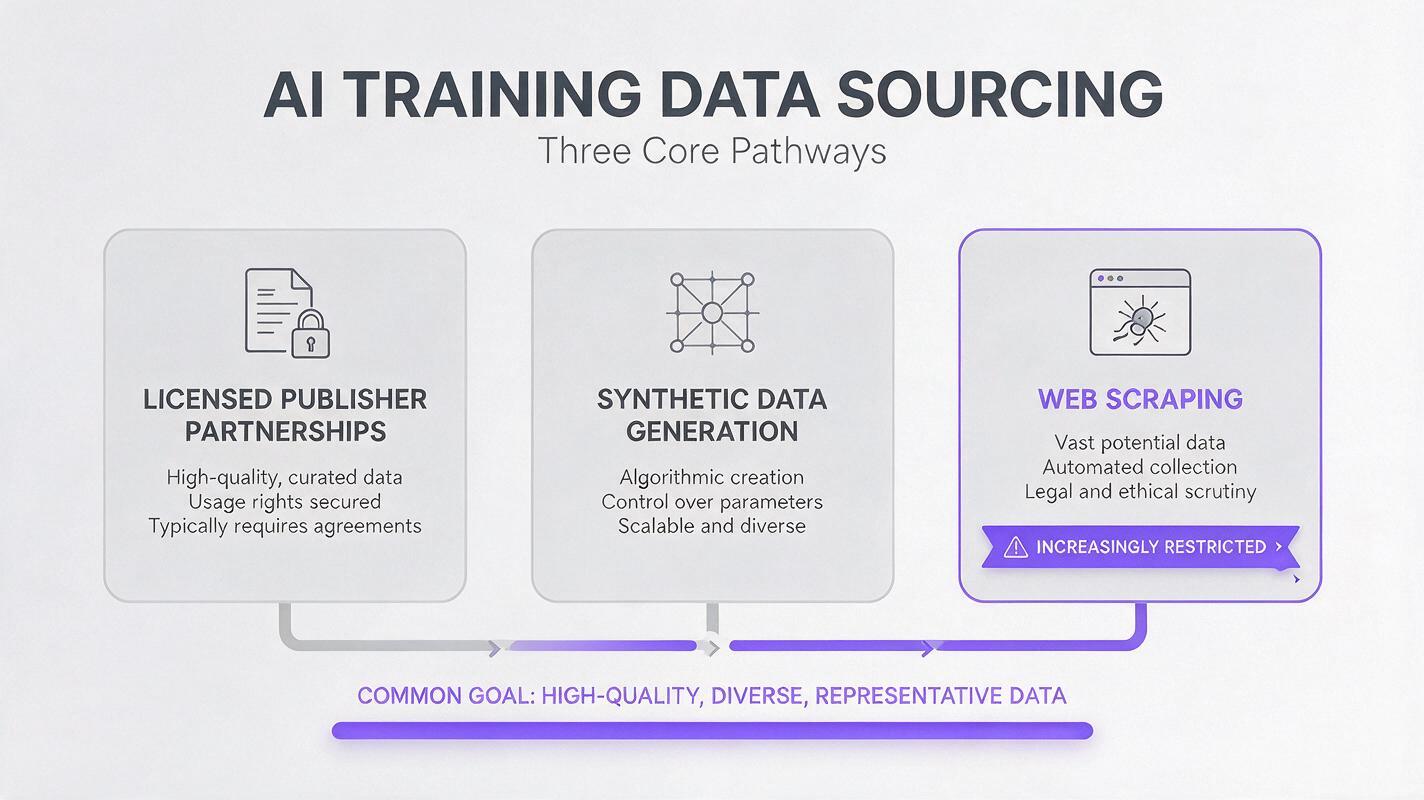
像 DeepSeek 这样快速增长的 AI 企业,据报道其年化收入约为 10 亿美元,并正以 740 亿美元的估值筹集约 75 亿美元 AI 资金,同样需要应对这些不断变化的规则。随着监管审查力度加大,AI 服务提供商可能会越来越多地转向授权数据合作、合成数据生成或设备端训练,以减少对网页抓取的依赖。
对于终端用户而言,这些变化可能会对定价和访问权限产生切实影响。随着数据来源成本上升,AI 图像生成器平台和视频生成服务等工具可能会调整定价模式,从而推高独立创作者和小型内容团队的 AI 视频成本。
这对内容创作者意味着什么
对于在线发布原创内容的创作者而言,Meta 的政策更新是内容所有权保护方面一个虽小但意义重大的胜利。这表明大型科技公司会回应出版商对 AI 训练数据的担忧,但这并不能消除内容被其他 AI 服务提供商抓取,或被用于未公开目的的风险。
依靠生成式 AI 工具制作内容的创作者也面临着行业调整带来的不确定性。数据来源实践的变化可能导致不同供应商的模型能力、价格或可用性发生改变,从而打乱既有工作流程。使用多模型平台可以通过让创作者在单一账户下获得来自不同供应商的一系列工具来降低这一风险。
在 MagicBoat 上,你可以使用AI 图像生成器工具、文本转视频功能,以及其他数十种 AI 创作功能,无需受限于单一供应商的政策。如果某个供应商更改条款或价格,你可以无缝切换到更符合自身需求和预算的其他工具。免费试用这些模型,了解多模型平台如何让你的创作流程更加稳定。
要点总结
- Meta 已从其商业条款中删除 AI 训练网页抓取相关措辞,该变更在出版商和法律界施压后于 10 月 30 日生效。
- Meta 表示,其网页抓取原本仅用于广告和商业产品,并且 robots.txt 协议仍然规定着网站访问方式。
- 这一政策转变反映出业界和监管机构对 AI 训练数据实践日益加强的审查,即使全球 AI 资本支出仍在快速增长。
- 创作者可以通过使用工具选项多样、定价灵活的多模型 AI 平台,减少供应商政策变化对工作流程造成的干扰。
关键词
Meta AI、AI 训练数据、网页抓取、AI 行业、AI 内容创作、商业条款、出版商权利