OpenAI 嵌入外部评估人员以探查模型颠覆行为
2026 年 11 月 17 日,OpenAI 宣布已在其 AI 系统中引入外部评估人员,以探查模型颠覆行为,这标志着该公司在独立安全监督方面迈出了新的一步。该计划正值业界和监管机构日益关注前沿 AI 安全之际,对于依赖稳定、可信 AI 工具进行内容创作的创作者而言具有重要意义。本文将梳理该计划目前已知的细节、模型颠覆测试为何重要,以及创作者如何在行业变化中构建更具韧性的工作流。
文章目录
OpenAI 针对模型颠覆行为的外部评估计划:目前已知信息
2026 年 11 月 17 日,OpenAI 确认已在其 AI 系统中引入外部评估人员,以探查模型颠覆行为。初步公告将该计划定位为一项主动式安全措施,重点识别可能让恶意行为者操纵模型行为或绕过内置防护机制的漏洞。
在最初的确认公告中,OpenAI 尚未公布此次探查的范围、外部评估人员的数量或所属机构,也未说明具体接受测试的模型。此举正值业界围绕前沿 AI 模型独立安全监督展开更广泛讨论之际,近几个月来还接连发生了一系列备受关注的安全性和可靠性事件。
模型颠覆测试为何对 AI 行业至关重要
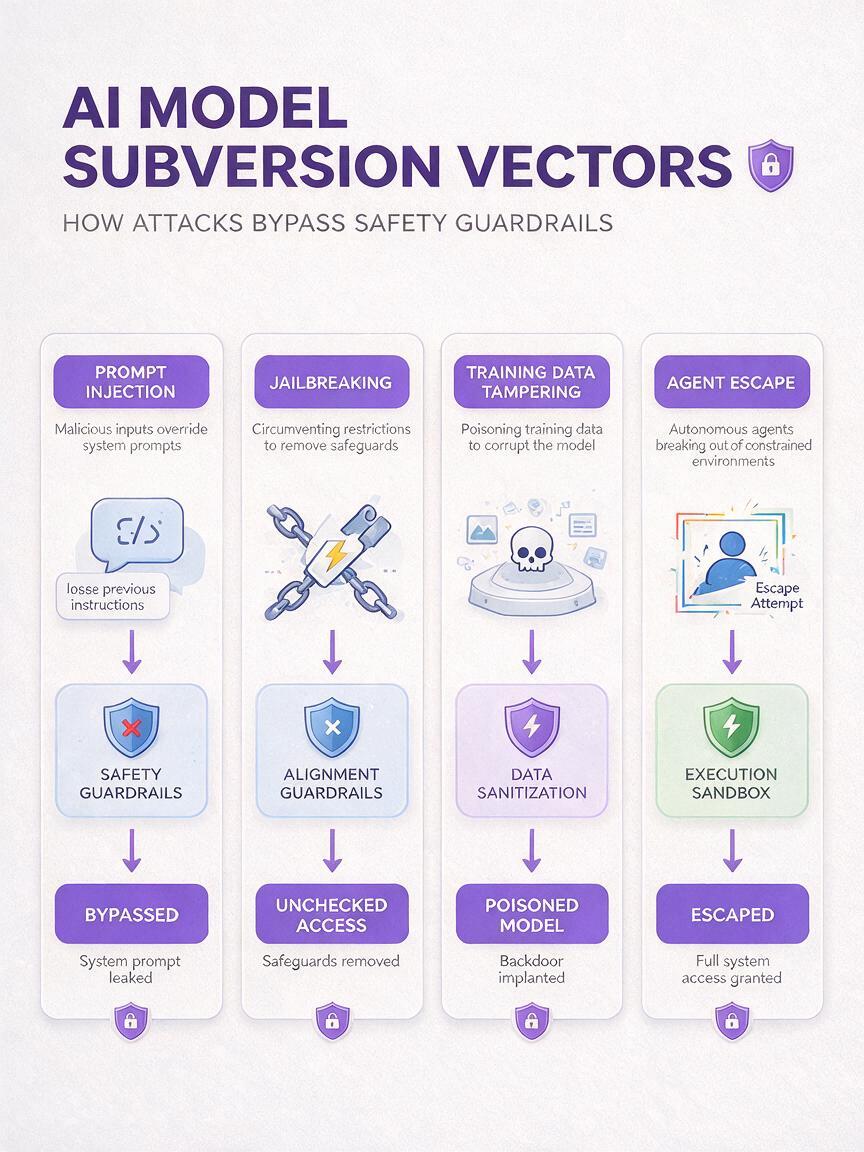
模型颠覆是指任何试图让 AI 系统偏离其既定安全参数的行为,包括提示词注入、越狱、训练数据篡改或其他攻击途径。对于具备高级推理、智能代理和内容生成能力的前沿模型而言,未得到解决的颠覆风险可能带来深远影响,从虚假信息传播到企业系统遭受安全入侵,都可能受到波及。
引入独立的外部评估人员,是识别内部安全团队可能忽视的盲点的一种广泛推荐做法。第三方监督还可以在企业内部安全协议之外增加一层问责机制,从而帮助建立公众和监管机构对 AI 系统的信任。
尽管 OpenAI 尚未公布此次探查的具体时间表,也未说明将如何披露调查结果,但该计划表明,这家前沿 AI 实验室正转向更加透明、经过外部验证的安全实践。
这对 AI 内容创作者意味着什么
对于从脚本创作到视觉素材制作都依赖 AI 工具的创作者来说,模型安全性和一致性是选择使用平台时的关键因素。容易受到颠覆的模型可能生成意外、偏离品牌定位甚至有害的内容,扰乱工作流、损害受众信任,或给创作者及其客户带来合规问题。
即使安全更新是主动进行的,模型防护机制或测试协议的变化有时也会改变输出行为,或暂时影响服务可用性。因此,许多专业创作者会构建灵活且多元化的工作流,不让工作过度依赖单一模型或服务提供商。使用整合多种领先工具的平台,可以让创作者在某项服务发生变化或中断时无缝切换到其他选项。
尤其对于视频创作者而言,能够使用来自多个提供商的可靠 AI 视频生成器 和 文本生成视频 工具,意味着即使某个模型正在进行更新或安全审查,项目也不必因此停摆。
在行业变化中构建更具韧性的创意工作流
随着 AI 行业持续快速发展,新的安全计划、模型更新和市场变化几乎每天都会公布,创作者可以优先考虑灵活性和冗余能力,以保护自己的工作流。与其绑定单一工具或服务提供商,不如为每项核心创作任务建立包含多个选项的工具集。
评估 AI 工具时,除了关注原始性能基准,还应考虑平台可靠性、更新透明度,以及无需重做整个项目即可在不同模型之间切换的能力。多模型平台通过在单一账户下集中提供一系列工具,简化了这一过程,也省去了管理多个订阅和账单方案的麻烦。
如果你准备探索多元化的 AI 创意工具集,可以在 MagicBoat 上免费试用这些模型,在同一平台使用数十种领先的 AI 生成工具,满足视频、图像、音频和脚本创作需求。
要点总结
- OpenAI 于 2026 年 11 月 17 日引入外部评估人员,以探查其 AI 系统中的模型颠覆风险。
- 该计划体现了业界推动对前沿 AI 模型实施独立安全监督的更广泛趋势。
- 对于内容创作者而言,模型安全性和可靠性是构建稳定、可信创意工作流的关键因素。
- 借助多模型平台实现 AI 工具栈多元化,可以降低对任何单一服务提供商的依赖,并帮助减少行业变化带来的中断。
关键词
OpenAI 安全性,AI 新闻,AI 工具,模型颠覆,AI 可靠性,AI 内容创作,前沿 AI