SGLang Consortium 与 llama.cpp 1.0 引领开放推理发布浪潮
2026 年 11 月中旬,一系列开放 AI 推理基础设施公告集中发布,包括由多家行业巨头参与成立的 SGLang Consortium、llama.cpp 和 ggml 稳定版 1.0.0 的发布,以及支持两秒内启动会话的新版 Amazon Bedrock AgentCore 运行时。11 月 14 日的一项可用性追踪还报告称,主要 AI 模型提供商均未发生服务中断,但该数据来自单一来源。这些进展有望为 AI agent 部署和创意 AI 视频工作流带来更快、更低成本且更可靠的性能。
文章目录
新一轮开放 AI 推理基础设施发布浪潮
据 11 月 15 日发布的中国行业资讯汇编,2026 年 11 月中旬集中出现了一系列开放推理基础设施公告,涵盖标准化组织、稳定版开源项目、云运行时更新和开源工具等领域。
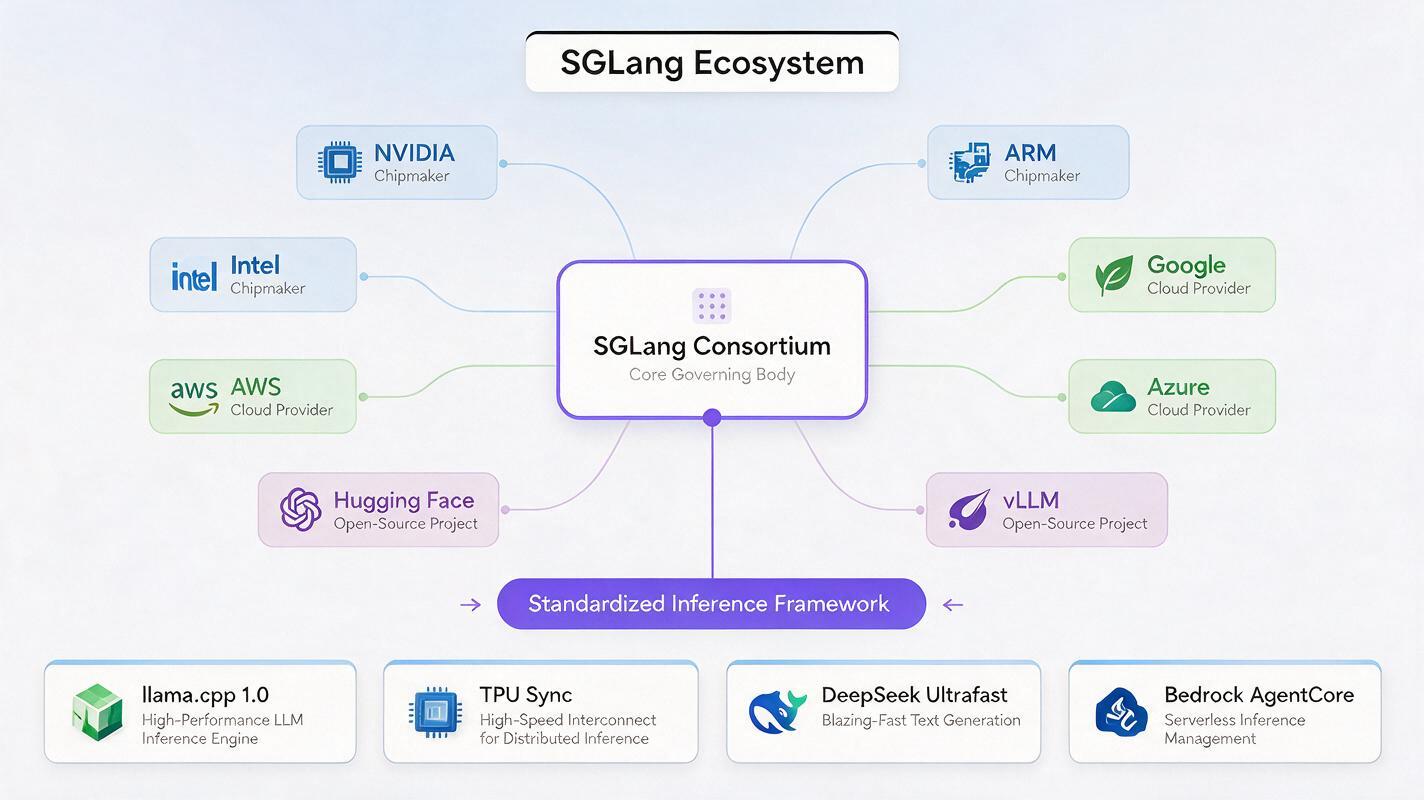
其中最受关注的发布是 SGLang Consortium 的成立,其创始成员包括 NVIDIA、AMD、Intel、Google、Meta、Cloudflare 和 Modal。该组织的既定目标是推动 LLM 推理框架标准化。这一举措有望减少 AI 生态系统中的碎片化,让开发者更容易在不同硬件和云平台之间部署模型。
在开源领域,llama.cpp 发布了首个稳定版本 1.0.0,同时推出 ggml 1.0.0,稳定版本共包含 200 多项变更。llama.cpp 是在消费级和边缘硬件上本地运行 LLM 最广泛使用的工具之一,因此稳定版的发布意味着本地推理部署将具备更高可靠性。
Baseten 将 DeepSeek Ultrafast 推理引擎开源,Google 将用于协调 TPU 工作负载的 TPU Sync 开源,Amazon Bedrock AgentCore 则获得了新的运行时更新,支持硬件隔离会话和按使用量计费。AWS 在 11 月 12 日发布的 Bedrock AgentCore 更新中首次详细介绍了该运行时;它还可将会话启动时间缩短至两秒以内,并降低会话暂停期间的内存使用量,因此更适合短时、高频的 agent 任务。Alibaba 的开源代码审查工具也在同一轮发布浪潮中登上 GitHub 热榜。
另一项 11 月 14 日发布的可用性追踪显示,包括 OpenAI、Anthropic、Google Vertex Gemini、Mistral 和 Microsoft Azure Foundry 在内的主要 AI 模型提供商均未发生服务中断。
不过,这轮集中发布也存在重要限制。大多数公告来自二手资讯汇总,因此不同日期的发布可能被合并到一起。100% 的可用性数据来自单一追踪器,且其探测频率未公开,因此可能无法反映所有地区或特殊情况下的停机。最后,SGLang Consortium 的成立并不等于标准已经发布;在标准化能够带来实际收益之前,该组织仍需就规范达成一致,并推出实施指南。
标准化推理对 AI Agent 开发意味着什么
标准化推理框架对于 AI agent 构建者,以及任何依赖大规模 AI 自动化的用户来说,都是一项重要进展。如今,要在多个云提供商或硬件平台上部署 AI agent,通常需要针对每个环境进行定制优化,这会增加成本并减慢迭代速度。
如果 SGLang Consortium 能够实现其标准化目标,开发者就可以只编写一次 agent 逻辑,并在不同加速器和边缘设备上以一致的方式运行,同时获得可预测的性能和成本。这将降低构建可靠 AI 助手工具的门槛,也让小型团队无需深厚的基础设施专业知识,就能更轻松地部署 agent 工作流。
Amazon Bedrock AgentCore 的运行时更新还解决了 agent 部署中的一个关键痛点:冷启动延迟。两秒以内的会话启动时间意味着,agent 可以按需启动来处理短时任务,而无需为闲置实例浪费资源;硬件隔离会话则为处理创作者账户数据或机密项目文件等敏感工作负载增加了一层安全保障。
稳定的开放推理助力创意 AI 工作流
对于内容创作者而言,推理基础设施的改进会直接转化为更快、更低成本且更可靠的创意工具。更快的推理速度能够加速 AI 视频工作流的每个阶段,从起草脚本,到使用 AI 图像生成器生成素材,再到使用文本生成视频模型渲染最终片段。更低的推理成本意味着创作者可以进行更多迭代、测试更多想法,并在不超出预算的情况下制作更高质量的内容。
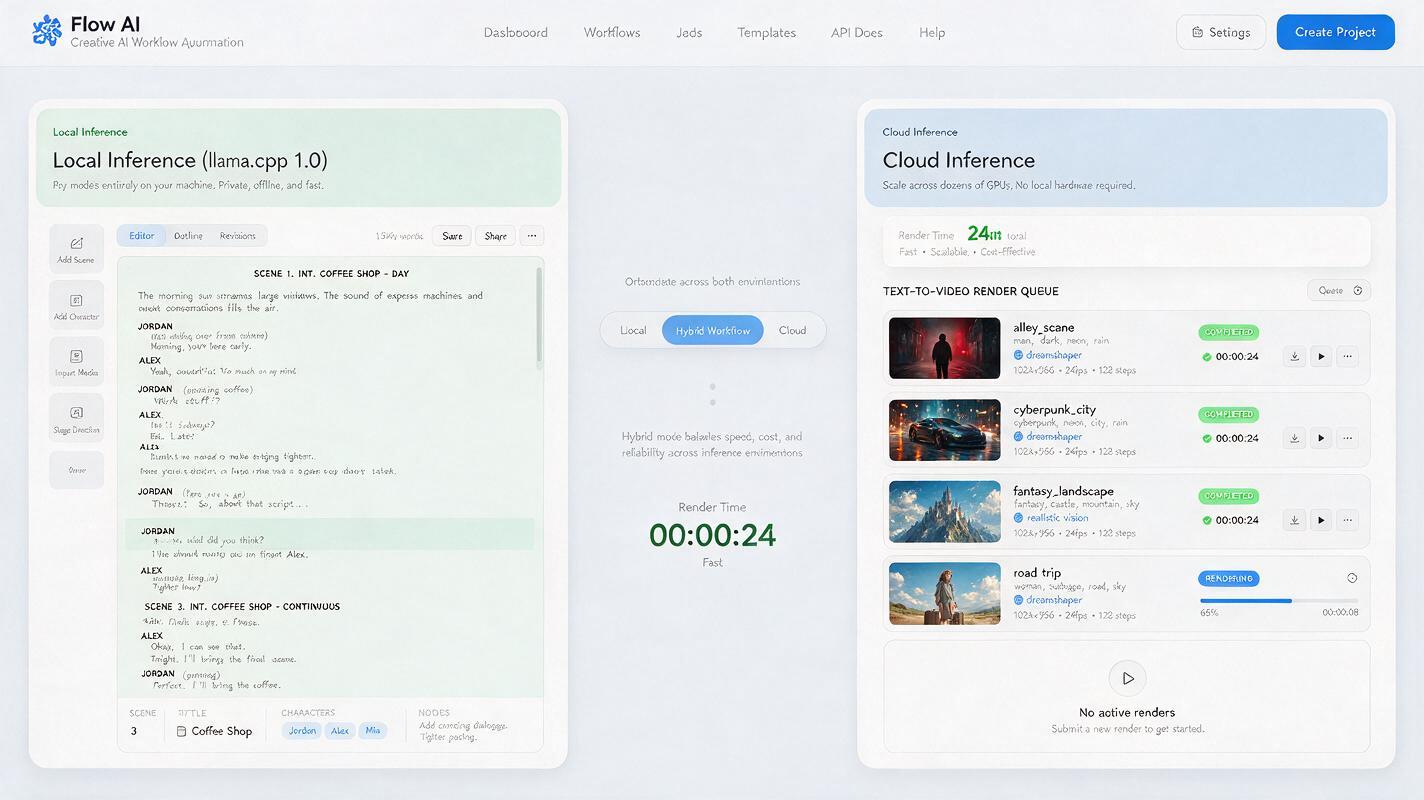
llama.cpp 稳定版 1.0.0 的发布,对于希望在本地运行部分工作流的创作者尤其重要。本地推理可以消除生成镜头清单或编辑文案等快速任务的 API 延迟,并将敏感项目数据保留在设备上,而不是发送到云服务器。创作者可以将本地轻量模型用于快速起草,再搭配云端前沿模型生成高保真输出,从而构建兼顾速度、成本和质量的混合工作流。
标准化推理框架还将让创意工具平台更容易在新模型发布时完成集成,使创作者无需等待定制集成工作,就能更快获得最新能力。
多模型平台为创作者释放推理性能提升
11 月 14 日可用性追踪显示主要提供商均未发生服务中断,这是 AI 服务整体可靠性良好的积极信号,但并不能消除未来发生停机或性能波动的风险。近期的大规模服务中断已经表明,即使是规模最大的云提供商,也可能经历长时间的故障,从而扰乱工作流程。
对于依靠 AI 工具谋生的创作者而言,在降低风险的同时利用最新推理性能提升的最佳方式,是使用一个多模型平台,在同一处提供多个顶级供应商的模型。MagicBoat 就是这样的平台之一,提供涵盖图像生成、视频创作、脚本写作等领域的一整套创意 AI 工具,所有工具均可通过一个账户访问。
创作者无需为每家模型提供商分别管理 API 密钥、账单账户和使用限额,而是可以按需在工具和模型之间切换,为每项任务选择速度最快或最具成本效益的选项。无论是生成概念艺术、起草视频脚本,还是渲染短片,你都可以使用最新的推理性能提升,而不必受限于单一供应商。
如果你准备将这些推理性能提升应用到自己的创意项目中,现在就可以免费试用这些模型。
要点总结
- 2026 年 11 月中旬集中发布了一系列开放推理基础设施,主要包括 SGLang Consortium 的成立和 llama.cpp 1.0.0 稳定版的发布。
- 标准化推理框架有望减少 AI agent 和 AI 自动化工作负载在不同硬件与云平台之间部署时的阻力。
- Amazon Bedrock AgentCore 的新运行时支持两秒以内的会话启动和硬件隔离会话,可提升 agent 任务的性能与安全性。
- 11 月 14 日的一项追踪显示主要 AI 模型提供商均未发生服务中断,但该数据来自单一来源,且监测频率未公开。
- 多模型创意平台让创作者能够利用最新的推理性能提升,同时避免供应商锁定并降低停机风险。
关键词
AI 推理基础设施,SGLang Consortium,llama.cpp,AI agent,AI 工作流,Bedrock AgentCore,AI 自动化,AI 视频工作流